Sieci funkcjonalne
WSTĘP
Sieci funkcjonalne stanowią uogólnienie sieci neuronowych, co osiąga się poprzez zastosowanie funkcji wieloargumentowych i uczących się, tj. w tych sieciach funkcje przejścia związane z neuronami nie są stałe, lecz uczone na podstawie danych. Ponadto nie ma potrzeby uwzględniania parametrów do ważenia połączeń między neuronami, ponieważ ich wpływ jest uwzględniany przez funkcje neuronowe. Inną charakterystyczną cechą tych modeli jest to, że specyfikacja początkowej topologii sieci funkcjonalnej może opierać się na cechach rozpatrywanego problemu. Dlatego wiedza na temat problemu może ukierunkować rozwój struktury sieci, chociaż w przypadku jej braku zawsze można zastosować model ogólny. W niniejszym artykule przedstawiamy przegląd dziedziny sieci funkcjonalnych, który zostanie zilustrowany praktycznymi przykładami.
TŁO
Sztuczne sieci neuronowe (ANN) to potężne narzędzie do budowy systemów zdolnych do uczenia się i adaptacji do otoczenia, z powodzeniem stosowane w wielu dziedzinach. Proces uczenia się polega na dostosowywaniu wartości parametrów, tj. wag łączących neurony sieci. Adaptacja ta odbywa się za pomocą algorytmu uczenia, który próbuje dostosować dane treningowe reprezentujące problem do nauczenia. Algorytm ten opiera się na minimalizacji funkcji błędu, która mierzy, jak dobrze ANN dostosowuje dane treningowe (Bishop, 1995). Proces ten nazywa się uczeniem parametrycznym. Jednym z najpopularniejszych modeli sieci neuronowych są perceptrony wielowarstwowe (MLP), dla których można zastosować wiele algorytmów uczenia: od genialnej propagacji wstecznej po bardziej złożone i wydajne algorytmy Scale Conjugate Gradient lub Levenberg-Marquardt Ponadto konieczne jest również określenie topologii sieci (liczby warstw, neuronów, połączeń, funkcji aktywacji itp.). Nazywa się to uczeniem strukturalnym i odbywa się głównie metodą prób i błędów. W rezultacie istnieją dwie główne wady w pracy z sieciami neuronowymi:
1.Wynikowa funkcja nie daje możliwości fizycznej ani inżynierskiej interpretacji. W tym sensie sieci neuronowe działają jak czarne skrzynki.
2. Nie ma gwarancji, że wagi dostarczane przez algorytm uczenia odpowiadają globalnemu optimum funkcji błędu, może to być optimum lokalne.
Modele takie jak Uogólnione Sieci Liniowe (GLN) prezentują unikalne globalne optimum, które można uzyskać, rozwiązując układ równań liniowych. Jednak jego funkcja odwzorowania jest ograniczona, ponieważ model ten składa się z pojedynczej warstwy adaptacyjnych wag (wj), tworząc liniową kombinację f funkcji nieliniowych (Φj)

Inne popularne modele to sieci funkcji bazowych radialnych (RBF), w których ukryte jednostki wykorzystują odległości do wektora prototypowego (μj), a następnie transformację z funkcją lokalną, taką jak Gaussa:

Powstała architektura jest prostsza niż architektura MLP, co zmniejsza złożoność uczenia strukturalnego i sprzyja możliwości interpretacji fizycznej. Przedstawiają one jednak pewne ograniczenia, takie jak niezdolność do rozróżniania nieistotnych zmiennych wejściowych (Bishop, 1995), uczenia się niektórych transformacji logicznych lub konieczność użycia dużej liczby węzłów nawet dla mapy liniowej, jeśli wymagania dotyczące precyzji są wysokie . Z powodu tych ograniczeń pojawiły się pewne modele rozszerzające oryginalną sieć neuronową, takie jak rozmyte sieci neuronowe , rosnące sieci neuronowe lub probabilistyczne sieci neuronowe). Obecnie większość tych modeli nadal działa jak czarne skrzynki. Sieci funkcyjne , stanowiące stosunkowo nowe rozszerzenie sieci neuronowych, uwzględniają strukturę funkcjonalną i właściwości modelowanego procesu, które naturalnie determinują początkową strukturę sieci. Co więcej, estymacja wag sieci często opiera się na funkcji błędu, którą można zminimalizować, rozwiązując układ równań liniowych, co pozwala szybciej znaleźć jednoznaczne i globalne rozwiązanie.
OPIS SIECI FUNKCJONALNYCH
Sieci funkcjonalne (FN) stanowią uogólnienie sieci neuronowych, które uzyskuje się poprzez zastosowanie funkcji wieloargumentowych i uczących się , tj. kształt funkcji powiązanych z neuronami nie jest stały,lecz uczony na podstawie danych. W tym przypadku nie jest konieczne uwzględnianie wag, aby rozważyć powiązania między neuronami, ponieważ ich wpływ jest uwzględniany przez funkcje neuronowe. Rysunek 1 przedstawia przykład ogólnej sieci FN dla zmiennych objaśniających I=N0. Sieci funkcjonalne składają się z następujących elementów:
a. Kilku warstw jednostek pamięci (przedstawionych na rysunku 1 małymi wypełnionymi kółkami). Jednostki te służą do przechowywania zarówno danych wejściowych, jak i wyjściowych sieci lub do przechowywania informacji pośrednich (patrz jednostki yi(k)
b. Jedna lub więcej warstw jednostek funkcjonalnych lub neuronów (reprezentowanych przez otwarte kółka z nazwami każdej z jednostek funkcjonalnych w środku). Neurony te zawierają funkcję, która może być wielowymiarowa imoże mieć tyle samo argumentów, co danych wejściowych. Argumenty te, a zatem i forma funkcji neuronowych, są przyswajane podczas treningu. Stosując swoje funkcje, neurony oceniają zbiór wartości wejściowych w celu zwrócenia zbioru wartości wyjściowych do następnej warstwy jednostek pamięci. W tym ogólnym modelu każda funkcja neuronowa f(m)i jest zdefiniowana jako następująca kompozycja:

gdzie indeks górny (m) oznacza numer warstwy. Funkcje g(m)i są znane i ustalone przed trenowaniem, na przykład jako suma lub iloczyn. Natomiast funkcje h(m)ij są liniowymi kombinacjami innych znanych funkcji Φiq (na przykład wielomianów, cosinusów itp.), tj.

gdzie współczynniki aijz(m) implikowane w tej kombinacji liniowej są parametrami modelu do nauczenia. Jak widać, MLP, GLN i RBF są szczególnymi przypadkami tego uogólnionego modelu.
c. Zestaw skierowanych połączeń łączących jednostki funkcjonalne i jednostki pamięci. Połączenia te wskazują kierunek przepływu informacji. Ogólna sieć FN na rysunku 1 nie ma strzałek zbiegających się w tej samej jednostce pamięci, ale gdyby tak było, oznaczałoby to, że neurony, z których one wychodzą, muszą generować identyczne wyniki. Jest to ważna cecha sieci FN, która nie jest dostępna dla sieci neuronowych. Te zbieżne strzałki reprezentują ograniczenia, które mogą wynikać z fizycznych i/lub teoretycznych cech rozpatrywanego problemu.
Uczenie się w sieciach funkcyjnych
Sieci funkcyjne łączą wiedzę o problemie, aby określić sieć, oraz dane treningowe, aby oszacować nieznane funkcje neuronowe. Dlatego też, w przeciwieństwie do sieci neuronowych, sieci funkcyjne obejmują dwa rodzaje uczenia się:
1. Uczenie strukturalne. Specyfikacja początkowej topologii sieci funkcyjnej może opierać się na cechach rozpatrywanego problemu . Zazwyczaj wiedza o problemie może być wykorzystana do opracowania struktury sieci. Ważną cechą sieci funkcyjnych jest to, że pozwalają one na zarządzanie ograniczeniami funkcyjnymi określonymi przez znane właściwości estymowanego modelu. Ograniczenia te można przedstawić poprzez wymuszenie zbieżności wyjść niektórych neuronów w unikalnej jednostce pamięci. Następnie sieć można przekształcić w układ równań funkcyjnych, który zazwyczaj można uprościć, aby uzyskać prostszą, ale równoważną architekturę. Wreszcie, w przypadku braku wiedzy o problemie, zawsze można zastosować model ogólny.
2.Uczenie parametryczne. Ten drugi etap odnosi się do estymacji funkcji neuronu. Często te funkcje neuronowe są traktowane jako kombinacje liniowe rodzin funkcyjnych, dlatego uczenie parametryczne polega na estymacji zarówno argumentów funkcji neuronowych, jak i parametrów kombinacji liniowej z wykorzystaniem dostępnych danych treningowych. Należy zauważyć, że ten typ uczenia się uogólnia ideę szacowania wag sieci neuronowej.
Przykład sieci funkcjonalnej
W tej sekcji zastosowanie sieci funkcjonalnych (FN) zilustrowano za pomocą prostego, sztucznego przykładu. Załóżmy, że mamy problem diagnostyki silnika, dla którego monitorowane są trzy zmienne ciągłe (x = "wibracje", y = "gęstość oleju", z = "temperatura"). Problem polega na oszacowaniu prawdopodobieństwa P danej diagnozy na podstawie tych zmiennych, tj. P(x, y, z). Ponadto wiemy, że informacje dostarczane przez monitorowane zmienne są akumulowane. Dlatego możliwe jest na przykład najpierw obliczenie prawdopodobieństwa P1(x, y) diagnozy na podstawie tylko zmiennych x i y, a następnie, gdy dostępna jest zmienna z, połączenie wartości dostarczonej przez P1 z nową informacją z, aby uzyskać P(x, y, z). Oznacza to, że istnieją pewne funkcje, takie jak:

Ta sytuacja sugeruje strukturę FN gdzie I jest funkcją tożsamościową. Współbieżne połączenia w jednostce wyjściowej magazynu, czyli równoważnie równanie 1, ustanawiają silne ograniczenia dotyczące funkcji P1, P2, P3, F, K, L. Zastosowanie metod dla równań funkcyjnych pozwala na rozwiązanie równania 1 w celu uzyskania odpowiednich warunków funkcyjnych, z których możliwe jest wyprowadzenie nowego równania dla funkcji P:
P(x,y,z)=k[p9x) +q(y)+g(z)]
Prowadzi to do nowej, prostszej FN przedstawionej na rysunku b, która jest równoważna z tą z rysunku a.

Porównanie sieci funkcjonalnych i neuronowych
Chociaż sieci funkcjonalne są rozszerzeniem sieci neuronowych, istnieją pewne główne cechy, które odróżniają oba modele:
1.Sieci neuronowe są generowane wyłącznie na podstawie danych dotyczących problemu. Sieci funkcjonalne mogą jednak również wykorzystywać wiedzę o problemie do wyprowadzenia jego topologii, uwzględniając właściwości funkcji, która ma być modelowana.
2. Podczas uczenia się w sieciach neuronowych kształt funkcji neuronowych jest zazwyczaj ustalony i ma postać funkcji sigmoidalnej, a jedynie wagi mogą być dostosowywane. W sieciach funkcjonalnych funkcje neuronowe są również uczone.
3. Funkcje neuronowe, które można wykorzystać w sieciach neuronowych, są ograniczone i należą do pewnej znanej rodziny. Ponadto, dla każdej warstwy ta sama funkcja jest używana dla każdego neuronu. W sieciach funkcjonalnych dla każdego neuronu można zastosować dowolną funkcję.
4. Funkcje te mogą być wieloargumentowe i wielowymiarowe. W sieciach neuronowych funkcje aktywacji mają tylko jeden argument (kombinację kilku danych wejściowych).
5. W sieciach neuronowych możliwe jest wymuszenie zbieżności sygnałów wyjściowych niektórych neuronów poprzez połączenie ich z tą samą jednostką pamięci. Połączenia te stanowią ograniczenia modelu, które czasami można wykorzystać do wyprowadzenia prostszego modelu.
Niektóre modele sieci funkcjonalnych
W tej sekcji przedstawiono kilka typowych modeli sieci funkcjonalnych (FN), które pozwalają rozwiązać kilka rzeczywistych problemów.
Model unikatowości
Jest to prosty, ale bardzo wydajny model, w którym wyjście z odpowiedniej architektury sieci funkcjonalnej (FN) można zapisać jako funkcję wejść x i y,

Jednoznaczność reprezentacji. Aby ten model miał jednoznaczność rozwiązania, wystarczy ustalić funkcje f1, f2, f3 w jednym punkcie .
Uczenie się modelu. Poznanie funkcji F(x, y) w równaniu 2 jest równoważne poznaniu funkcji ze zbioru danych, {(xi, yi, zi): j = 1,…, n}, gdzie z jest pożądanym wynikiem dla danych danych wejściowych. Aby oszacować f1, f2, f3, możemy zastosować metodę nieliniową i liniową:
1.Metoda nieliniowa. Aproksymujemy każdą z funkcji f1, f2, f3 -1 z = F(x, y) = f3,sup>-1(f1(x) +f2(y)), traktując je jako kombinację liniową znanych funkcji z danej rodziny (np. wielomianowych). Na koniec minimalizujemy następującą sumę błędów kwadratowych:

2.Metoda liniowa. Uproszczenie metody nieliniowej można przeprowadzić, biorąc pod uwagę następującą równoważność:

Ponownie funkcje fs można aproksymować jako kombinację liniową znanych funkcji z danej rodziny. Ostatecznie, suma błędów kwadratowych wynosi:

Ponownie funkcje fs można aproksymować jako kombinację liniową znanych funkcji z danej rodziny. Ostatecznie, suma błędów kwadratowych wynosi:

Ponownie funkcje fs można aproksymować jako kombinację liniową znanych funkcji z danej rodziny. Ostatecznie, następującą sumę błędów kwadratowych można zminimalizować, rozwiązując układ równań liniowych, gdzie niewiadomymi są współczynniki asi, jak wykazano w (Castillo, Cobo, Gutiérrez i Pruneda, 1998).
Uogólniony model łączności
Rysunek a przedstawia uogólniony model łączności FN trzech wejść, gdzie węzły I reprezentują funkcję tożsamościową.

Model ten opiera się na uogólnionej własności łączności, tzn. wyjście tej sieci można uzyskać jako funkcję G(x, y) i wejścia z lub jako funkcję wejścia x i N(y, z). Właściwość ta jest reprezentowana przez połączenia zbieżne do węzła wyjściowego u, co prowadzi do równania funkcyjnego
F[G(x,y),z]=K[x,N(y,z)] (3)
Uproszczenie modelu. Można wykazać, że ogólne rozwiązanie równania 3 to:

gdzie f, r, k, n, p, q są dowolnymi funkcjami ciągłymi i ściśle monotonicznymi. Podstawiając równanie 4 do równania 3, otrzymujemy następujący wynik.

Zatem funkcja FN na rysunku b jest równoważna funkcji FN na rysunku 3a.

Jednoznaczność reprezentacji. Stosując równania funkcyjne dla uogólnionego modelu łączności, można wykazać, że jednoznaczność rozwiązania wymaga ustalenia funkcji k, p, q, r w punkcie . Nauka modelu. Problem nauki funkcji FN na rysunku 3b polega na oszacowaniu funkcji k, p, q, r w równaniu 5, które można zapisać w następujący sposób:
k-1(u)=p(x) +q(y)+r(z)
Ponieważ {(x1i, x2i, x3i, x4i)|i = 1,…,n} przy (x1, x2, x3, x4 ≡ x, y, z, u) obserwowana próbka treningowa o rozmiarze n pozwala nam zdefiniować błąd

Załóżmy, że każda z funkcji jest kombinacją liniową znanych funkcji z danych rodzin (np. wielomianowych). Wówczas suma kwadratów błędów jest definiowana jako

Stosując metodę mnożników Lagrange′a, minimum uzyskuje się rozwiązując następujący układ równań liniowych:

gdzie niewiadomymi są mnożniki λ1,…,λ4 współczynniki w zbiorze (akj| j=1,…mk;k=1,2,3,4} które są parametrami FN.
Model rozdzielny
Rozważ równanie

co można zapisać jako

gdzie

Sugeruje to FN na rysunku a.

Uproszczenie modelu. Zakładając, że {f1(x),…,fr(x)}, {gr+1(x),…,gk(x)} to dwa zbiory funkcji liniowo niezależnych, ogólne rozwiązanie równania 6

to

Zastępując te wyrazy w równaniu 6, otrzymujemy

gdzie cij to parametry modelu, co prowadzi do uproszczonego równania FN na rysunku b.

Jednoznaczność reprezentacji. W tym przypadku jednoznaczność reprezentacji jest dana bez konieczności ustalania funkcji domniemanych w dowolnym punkcie. Uczenie się modelu. W tym przypadku prosta metoda najmniejszych kwadratów pozwala uzyskać optymalne współczynniki cij, wykorzystując dostępne dane {(x0i, x1i, x2i)i = 1,…, n} z (x0, x1, x2 ≡ z, x, y). W ten sposób błąd można uzyskać jako:

W celu znalezienia optymalnych współczynników minimalizujemy sumę kwadratów błędów

W tym przypadku parametry nie są ograniczone dodatkowymi warunkami, więc minimum można uzyskać rozwiązując następujący układ równań liniowych, w którym niewiadomymi są współczynniki cij:

Przykłady zastosowań
W tej sekcji przedstawiono ilustrujące przykłady dwóch różnych modeli sieci bazowej (FN). Modele te zastosowano do problemu regresji i klasyfikacji. We wszystkich przypadkach funkcje każdej warstwy aproksymowano, rozważając kombinację liniową znanych funkcji z rodziny wielomianów.
Problem klasyfikacji
Pierwszy przykład przedstawia wydajność sieci bazowej (FN) rozwiązującej problem klasyfikacji: zbiór danych Wine. Bazę danych można uzyskać z repozytorium UCI Machine Learning Repository1. Celem tego problemu jest określenie pochodzenia win za pomocą analizy chemicznej 13 atrybutów ciągłych. Zbiór zawiera 178 instancji, które należy sklasyfikować w trzech różnych klasach. W tym przypadku zastosowano model rozdzielny z trzema jednostkami wyjściowymi. Ponadto, jego wydajność porównano z innymi standardowymi metodami: perceptronem wielowarstwowym (MLP), radialną siecią funkcji bazowych (RBF) i maszynami wektorów nośnych (SVM). Rysunek 5 przedstawia wyniki porównawcze.

Pierwszy podrysunek przedstawia średnią dokładność uzyskaną za pomocą metody walidacji krzyżowej z pominięciem jednego elementu. Jak można zauważyć, sieć FN uzyskuje bardzo dobrą wydajność dla zbioru testowego. Jeśli chodzi o czas potrzebny na proces uczenia, drugi podrysunek pokazuje, że sieci FN są porównywalne z innymi metodami.
Problem regresji
W tym przypadku celem sieci jest przewidywanie siły ścinającej przy zniszczeniu belek betonowych w oparciu o kilka parametrów geometrycznych, podłużnych i poprzecznych belki . Sieć FN, odpowiadająca modelowi asocjacyjnemu , a także sieć MLP zostały wytrenowane z wykorzystaniem dziesięciokrotnej walidacji krzyżowej, przeprowadzając 30 symulacjiz różnymi początkowymi wartościami parametrów. Zestaw 12 próbek zachowano do dalszej walidacji wytrenowanych systemów. Średnie znormalizowane średnie błędy kwadratowe w 30 symulacjach uzyskanych przez FN wyniosły odpowiednio 0,1789 i 0,8460 dla testów i walidacji, podczas gdy MLP uzyskał 0,1361 i 2,9265.
TRENDY NA PRZYSZŁOŚĆ
Sieci funkcjonalne są z powodzeniem wykorzystywane w wielu różnych rzeczywistych zastosowaniach. W problemach inżynierskich stosowano je na przykład do rekonstrukcji powierzchni . W innych pracach wykorzystano te sieci do odzyskiwania brakujących danych oraz do ogólnych problemów regresji i klasyfikacji . Inny niedawny kierunek badań wiąże się z badaniem miar odporności na błędy w celu opracowania nowych metod uczenia się.
WNIOSKI
Niniejszy artykuł przedstawia przegląd sieci funkcyjnych. Sieci funkcyjne są inspirowane sieciami neuronowymi i równaniami funkcyjnymi. Model ten oferuje wszystkie zalety sieci neuronowych, takie jak odporność na szumy i zdolność generalizacji, dodając jednocześnie nowe korzyści. Jedną z nich jest możliwość wykorzystania wiedzy o modelowanym problemie do wyprowadzenia początkowej topologii sieci, co prowadzi do modelu, który można interpretować fizycznie lub inżyniersko. Kolejną główną zaletą jest to, że początkowo zaproponowany model można uprościć za pomocą równań funkcyjnych i nauczyć się go, rozwiązując układ równań liniowych, co przyspiesza proces uczenia się i zapobiega utknięciu w lokalnym minimum. Wreszcie, kształt funkcji neuronowych nie musi być stały, ale można go dopasować na podstawie danych w trakcie treningu, co poszerza możliwości modelowania sieci.
Sieci neuronowe i równowaga, synchronizacja i opóźnienia
WSTĘP
Wszystkie sieci neuronowe, zarówno naturalne, jak i sztuczne, charakteryzują się dwoma rodzajami dynamiki. Pierwsza dotyczy tego, co nazwalibyśmy "dynamiką uczenia się", a właściwie sekwencyjnej (dyskretnej w czasie) dynamiki wyboru wag synaptycznych. Drugi to wewnętrzna dynamika sieci neuronowej postrzeganej jako system dynamiczny po ustaleniu wag w drodze uczenia się. Jeśli chodzi o drugą dynamikę, nowe możliwości obliczeniowe rekurencyjnej sieci neuronowej można osiągnąć, pod warunkiem, że ma ona wiele równowag. Zadanie sieci jest spełnione pod warunkiem, że zbliża się ona do tych równowag. Jednak system dynamiczny ma dynamikę wywołaną a posteriori w procesie uczenia się, który ustalił wagi synaptyczne. Nie jest obowiązkowe, aby dynamika a posteriori miała wymagane właściwości, dlatego należy je sprawdzić osobno. Standardowe właściwości stabilności (Lapunowa, stabilność asymptotyczna i wykładnicza) są zdefiniowane dla pojedynczej równowagi. Ich odpowiednikami dla kilku równowag są: zmienność, globalna asymptotyka, zachowanie gradientowe. W ostatnich dziesięcioleciach wzrosła liczba zastosowań rekurencyjnych sieci neuronowych, przeznaczonych do klasyfikacji, identyfikacji i złożonego przetwarzania obrazu, wizualnego i czasoprzestrzennego w takich dziedzinach, jak inżynieria, chemia, biologia i medycyna . Wszystkie te zastosowania opierają się głównie na istnieniu kilku równowag dla takich sieci, co wymaga od nich omówionych powyżej właściwości "dobrego zachowania". Innym aspektem analizy jakościowej jest tzw. problem synchronizacji, gdy bodziec zewnętrzny, w większości przypadków okresowy lub prawie okresowy, ma do śledzenia . Problem ten z matematycznego punktu widzenia jest niczym innym jak istnieniem, jedynością i globalną stabilnością oscylacji wymuszonych. W ostatnich dziesięcioleciach modele dynamiki sieci neuronowych zostały ponownie zmodyfikowane poprzez wprowadzenie opóźnień transmisji. Standardowy model sieci typu Hopfielda z opóźnieniem to

Niniejsza praca ma na celu ogólną prezentację, zarówno w celach badawczych, jak i edukacyjnych, trzech wspomnianych wcześniej tematów.
TŁO
Układy dynamiczne z kilkoma równowagami występują w takich dziedzinach nauki i technologii, jak maszyny elektryczne, reakcje chemiczne, ekonomia, biologia i wreszcie sieci neuronowe. W przypadku układów z kilkoma równowagami zwykłe lokalne koncepcje stabilności nie są wystarczające do odpowiedniego opisu. Tak zwany "globalny portret fazowy" może zawierać zarówno równowagi stabilne, jak i niestabilne: każdą z nich można scharakteryzować osobno, gdyż stabilność jest pojęciem lokalnym, odnoszącym się do określonej trajektorii. Jednak w celu lepszego opisu systemu potrzebne są również koncepcje globalne, co jest szczególnie prawdziwe w przypadku sieci neuronowych. Rzeczywiście, sieci neuronowe można postrzegać jako wzajemne połączenia prostych elementów obliczeniowych, których możliwości obliczeniowe są zwiększane poprzez wzajemne połączenie ("emergent zbiorowe zdolności" - cytując Hopfielda). Wynika to z nieliniowej charakterystyki prowadzącej do istnienia kilku stabilnych równowag. Sieć osiąga swój cel obliczeniowy, jeśli nie występują samopodtrzymujące się oscylacje i zawsze osiąga pewien stan ustalony (równowaga) wśród skończonej (choć dużej) liczby takich stanów. Zachowanie to najlepiej opisują koncepcje wynikające z prac Kalmana (1957) i Mosera (1967). Ostatni z nich opiera się na następującej uwadze dotyczącej dość ogólnego nieliniowego układu autonomicznego
x =-f(x), x ∈ℝn (2)
gdzie f(x) = stopień G(x) i G:ℝn ->ℝ jest taki, że liczba jego punktów krytycznych jest skończona i ma charakter promieniowy nieograniczony, tj.  .Przy tych założeniach każde rozwiązanie (2) zbliża się asymtotycznie do jednej z równowag (która jest również punktem krytycznym G - gdzie jego gradient, czyli f zanika). Oczywiście najlepsze zachowanie graniczne sieci neuronowej byłoby takie - naturalnie nazywane zachowaniem gradientowym. Niemniej jednak istnieją inne właściwości, które są również ważne, choć słabsze. Obiekt matematyczny będzie znajdował się w następującym układzie równań różniczkowych zwyczajnych

i najpierw zdefiniujemy kilka podstawowych pojęć.
Definicja 1 a) Każde stałe rozwiązanie (3) nazywa się równowagą; zbiór równowag E nazywany jest zbiorem stacjonarnym. b) Rozwiązanie (3) nazywa się zbieżnym, jeśli jestzbliża się asymptotycznie do pewnej równowagi:

Rozwiązanie nazywa się quasi-zbieżnym, jeśli asymptotycznie zbliża się do zbioru stacjonarnego:

gdzie d(z, M) jest odległością (w zwykłym znaczeniu) od punktu z do zbioru M. c) Układ (3) nazywany jest monostabilnym (ściśle zmiennym)jeśli każde rozwiązanie ograniczone jest zbieżne (w powyższym sensie); nazywa się to quasi-monostabilnym, jeśli każde rozwiązanie ograniczone jest quasi-zbieżne. d) Układ (3) nazywamy gradientowym, jeśli każde rozwiązanie nim jest zbieżny; nazywa się to quasi-gradientowym (ma globalną asymptotykę), jeśli każde rozwiązanie jest quasi-zbieżne.
Należy zauważyć, że zbieżność jest właściwością rozwiązania, podczas gdy monostabilność i właściwość gradientu są powiązane z systemami. Dla autonomicznych (niezmiennych w czasie) systemów w formularzu (2) dostępne są następujące wyniki typu Łapunowa.
Lemat 1 :Rozważmy układ (2) i załóżmy, że istnieje funkcja ciągła V: ℝn -> ℝ która nie rośnie wzdłuż żadnego ze swoich rozwiązań. Jeżeli dodatkowo ograniczone na ℝ+ rozwiązanie x(t), dla którego istnieje pewne τ > 0 tak, że V(x(?)) = V(x(0)) jest równowagą, to układ jest quasi-monostabilny.
Lemat 2 Jeżeli założenia Lematu 1 są spełnione i dodatkowo V(x) jest promieniowo nieograniczone, to układ (2) jest quasi-gradientowy.
Lemat 3 Jeżeli założenia Lematu 2 są spełnione i zbiór E jest dyskretny (tj. składa się tylko z izolowanych punktów), to układ (2) jest gradientowy.
Zagadnienia dynamiki powtarzających się sieci neuronowych
Sieci neuronowe jako układy o kilku równowagach
Wspomniano już, że powstające zdolności obliczeniowe sieci neuronowych zapewniają: a) nieliniowe zachowanie komórek nerwowych; b) ich łączność. Te dwie właściwości definiują sieci neuronowe jako układy dynamiczne z wieloma równowagami, których działanie zależy od (wysokiej) liczby tych równowag oraz od właściwości sieci podobnej do gradientu. Z kolei standardowe rekurencyjne sieci neuronowe (Dwukierunkowa pamięć asocjacyjna), komórkowe, które zawierają wewnętrzne pętle sprzężenia zwrotnego - mające tym samym skłonność do niestabilności, posiadają pewną "naturalną", tj. związaną w naturalny sposób funkcję Lapunowa pozwalającą na uzyskanie wymaganych właściwości jakościowych . Jednym z najbardziej ogólnych modeli sieci neuronowych, który ma naturalną funkcję Lapunowa, jest model Cohena-Grossberga opisany przez

z cij = cji; model ten można zapisać jako

gdzie A(x) jest macierzą diagonalną z wpisami

i V: ℝn -> ℝ jest zdefiniowany przez

Obecność A(x) sprawia, że układ (7) jest układem pseudogradientowym - porównaj z (2). Właściwości powiązanej funkcji Lapunowa (9) zapewni wystarczające warunki do uzyskania wymaganych zachowań jakościowych systemu. Funkcja pochodna (9) to:

Można zobaczyć, że nierówność (10) zachodzi pod warunkiem, że ai(λ) > 0 i di(λ) są monotoniczne i niemalejące. Jeżeli dodatkowo di(λ) są ściśle rosnące, to zbiór W = 0 składa się wyłącznie z równowag. Wyniki systemu są quasi-gradientowe, tzn. każde rozwiązanie się zbliża asymptotycznie zbiór stacjonarny. Rozważmy teraz model sztucznej sieci neuronowej realizowanej przez obwody elektryczne:

gdzie φj(⋅) jest sigmoidalne. Ponieważ funkcje sigmoidalne podlegają ograniczeniom sektorowym i globalnym nierównościom Lipschitza, naturalną rzeczą było podjęcie próby poprawy warunków stabilności za pomocą funkcji Lapunowa sugerowanych przez nierówności w dziedzinie częstotliwości Popowa i lemat Jakubowicza-Kalmana-Popowa. Na przykład rozważano dość ogólny układ z kilkoma nieliniowościami ograniczonymi sektorowo, a funkcję Łapunowa skonstruowano w racjonalny sposób, zaczynając od poprawionej nierówności stabilności w dziedzinie częstotliwości typu Popowa z mnożnikiem PI. W przypadku (11) to dość zaangażowane podejście daje zachowanie podobne do gradientu, pod warunkiem, że spełniony jest warunek symetrii Rij = Rji.
Opóźnienia czasowe w sieciach neuronowych
Rozważymy tutaj model (1). Ponieważ nie dysponujemy (jeszcze) w przypadku opóźnienia czasowego instrumentu takiego jak Lapunow jak lematy podane w TŁO, musimy ograniczyć się do analizy stabilności określonej równowagi. Jeśli ūii=1,…,n jest pewną równowagą (1) i jeśli weźmiemy pod uwagę zi= ui,-ūi , otrzymujemy układ w odchyleniach

z  Jak wiadomo, jeśli gj :?ℝ |-> ℝ ?? spełniają zwykłe warunki sigmoidalne, tj.gj(0) = 0, monotonicznie rosnący i globalnie Lipschitz - czyli

ówczas φj zdefiniowane powyżej są takie. Używając zwykłych oznaczeń pola, niech zt(⋅) = z(t + ⋅) oznacza stan (12) w t; rozważona zostanie przestrzeń stanów C(-r,0,ℝn) z  , przestrzeń ciągłych ℝn) - wartościowych odwzorowań zdefiniowanych na [-r, 0] ze zwykłą normą jednorodnej zbieżności. Rozważa się funkcjonał Lapunowa-Krasowskiego (analog funkcji Lapunowa w przypadku bez opóźnienia) zaproponowany przez (Nishimura i Kitamura, 1969), V: C|->ℝ+ jako

przy πi≥ 0,λi≥ 0, ρij≥ 0, δij≥ 0 pewnymi wolnymi parametrami.Rozważając ten funkcjonał wzdłuż rozwiązań (12) i różniczkując go ze względu na t, możemy znaleźć tak zwany funkcjonał pochodny W:C|-> ℝ jak poniżej

Problem znaku dla W daje następujący wybór dowolnych parametrów w (14) :

Zastosowanie standardowych twierdzeń o stabilności dla układów opóźnionych czasowo (da asymptotyczną stabilność równowagi z = 0 (u = ū). Wynik matematyczny brzmi następująco
Twierdzenie 3: Rozważmy układ (12) z ai > 0 i wij taki, że możliwy jest wybór ρij> 0 i δij> 0 w celu spełnienia σi > 0 z σi zdefiniowanym w (16). Wtedy równowaga jest globalnie asymptotycznie stabilna.
Problemy z synchronizacją
Z tego punktu widzenia jakościowe zachowanie sieci to nic innego jak zachowanie się pod wpływem zmiennych w czasie bodźców. Jest to szczególnie prawdziwe w przypadku modelowania czynności rytmicznych w układzie nerwowym lub synchronizacji reakcji oscylacyjnych . Zarówno rytmiczność, jak i synchronizacja sugerują pewien nawrót, co oznacza, że współczynniki i bodźce są okresowe lub prawie okresowe. Model z bodźcem zmiennym w czasie ma postać

przy tych samych założeniach co poprzednio, z funkcjami f

z  . Możemy sformułować
Twierdzenie 2. Załóżmy, że ai > 0, Li > 0 i wij są takie, że funkcjonał pochodnej odpowiadający ci(t) ≡ 0 w (17) mianowicie

jest ujemnie określone z kwadratową górną granicą. Wtedy układ (17) ma unikalne rozwiązanie globalne  który jest ograniczony przez ℝ i wykładniczo stabilny. Co więcej, rozwiązanie to jest okresowe lub prawie okresowe w zależności od charakteru ci(t) - odpowiednio okresowe lub prawie okresowe.
PRZYSZŁE TENDENCJE
Zakładając, że dziedzina sztucznej inteligencji ma swoją własną dynamikę, sieci neuronowe i ich struktury będą ewoluować w celu poprawy zachowań naśladowczych, tj. więcej "naturalnej" inteligencji zostanie przeniesione do sztucznej inteligencji. W rezultacie nauka i technologia będą zajmować się nowymi strukturami o różnej naturze fizycznej, posiadającymi wiele równowag. Badaniom pozostaną przynajmniej następujące zachowania jakościowe: właściwości podobne do stabilności (dychotomia, zachowanie gradientowe itp.), synchronizacja (oscylacje wymuszone, zachowanie prawie liniowe, chaos ,kontrola) i złożoną dynamikę (w tym zachowanie chaotyczne).
WNIOSKI
Nasze doświadczenie w zakresie dynamiki sieci neuronowych pokazuje, że najważniejszym badaniem jest uzyskanie warunków dla zachowania gradientowego lub quasi-gradientowego. Oprócz metody porównawczej , która wymaga relaksacji stanu identycznej dynamiki wszystkich neuronów, najpopularniejszym narzędziem pozostaje metoda Lapunowa. Gdyby w przypadku opóźnienia czasowego dostępne byłyby lematy typu Lapunowa podane w TLE, wówczas ulepszone funkcjonały Lapunowa pozostające stałe na zbiorze równowag mogłyby zapewnić gradient jak zachowanie.
Skracanie zautomatyzowanych wątków negocjacyjnych za pomocą sieci neuronowych
WSTĘP
W dziedzinie sztucznej inteligencji, rozwijającym się obszarem badań, który szybko zyskuje na popularności, są zautomatyzowane negocjacje . W tym kontekście budowanie inteligentnych agentów odpowiednich do uczestnictwa w negocjacjach i autonomicznego działania w imieniu ich właścicieli jest bardzo trudnym tematem badawczym. W zautomatyzowanych negocjacjach należy określić trzy główne elementy : (i) protokół i model negocjacji, (ii) kwestie negocjacyjne oraz (iii) strategie negocjacyjne, które zastosują agenci. Według (Walton i Krabbe, 1995), "Negocjacje to forma interakcji, w której grupa agentów o sprzecznych interesach i chęci współpracy stara się dojść do wzajemnie akceptowalnego porozumienia w sprawie podziału ograniczonych zasobów". Zasoby te odnoszą się nie tylko do pieniędzy, ale obejmują również inne parametry, co do których właściciele agentów są skłonni negocjować, takie jak cechy jakościowe produktu, warunki dostawy, gwarancja itp. W tym kontekście agenci działają zgodnie z predefiniowanymi regułami i procedurami określonymi w stosowanym protokole negocjacyjnym , dążąc do jak najlepszego spełnienia wymagań swoich ludzkich lub korporacyjnych właścicieli. Co więcej, agenci negocjujący stosują model rozumowania, na podstawie którego formułowane są ich odpowiedzi na oferty przeciwnika . Polityka ta jest powszechnie znana jako strategia negocjacyjna agenta . Niniejszy artykuł omawia projektowanie strategii negocjacyjnych dla agentów autonomicznych. Proponowane strategie mają zastosowanie w przypadkach, gdy agenci mają ścisłe terminy i negocjują z jedną stroną o wartości jednego parametru (negocjacje dwustronne dotyczące jednej kwestii). Techniki uczenia się oparte na sieciach neuronowych MLP i GR (ang. Grid Neural Networks - NN) są wykorzystywane przez agentów klienckich w celu przewidywania zachowań przeciwników i terminowego wykrywania nieudanych negocjacji. Proponowane strategie wspomagane sieciami neuronowymi zostały ocenione i okazały się wysoce skuteczne w zakresie skracania czasu trwania wątków negocjacyjnych, które nie mogą prowadzić do porozumień. Pozostała część artykułu ma następującą strukturę. W części drugiej przedstawiono podstawowe zasady zaprojektowanego modelu negocjacji oraz formalne sformułowanie problemu. Część trzecia omawia opracowane strategie wspomagane sieciami neuronowymi i podaje szczegóły konfiguracji zastosowanych sieci neuronowych. Część czwarta przedstawia przeprowadzone eksperymenty, a część piąta podsumowuje i ocenia ich wyniki. Wreszcie, w części ostatniej wyciągnięto wnioski i przedstawiono plany przyszłych badań.
PODSTAWY ZAUTOMATYZOWANYCH RAM NEGOCJACJI
Niniejszy artykuł analizuje jednowątkowe, dwustronne ramy zautomatyzowanych negocjacji. Zatem istnieją dwie strony negocjujące (Klient i Dostawca), reprezentowane przez mobilnych inteligentnych agentów. Agenci negocjują jedną kwestię w oparciu o protokół ofert naprzemiennych , dążąc do maksymalizacji użyteczności stron, które reprezentują. W dalszej części rozważamy przypadek, w którym proces negocjacji jest inicjowany przez Agenta Klienta (CA), który wysyła do Agenta Dostawcy (PA) wstępne zapytanie ofertowe (RFP) określające cechy usługi/produktu, którymi zainteresowany jest jego właściciel. Bez utraty ogólności przyjmuje się, że przedmiotem negocjacji jest cena produktu lub usługi. Zatem PA negocjuje, dążąc do uzgodnienia maksymalnej możliwej ceny, podczas gdy CA dąży do maksymalnego obniżenia ceny wynikającej z umowy. Po otrzymaniu przez PA zapytania ofertowego od CA, PA albo akceptuje udział w określonym wątku negocjacyjnym i formułuje wstępną ofertę cenową, albo odrzuca zapytanie ofertowe i kończy negocjacje bez propozycji. W każdej rundzie PA przesyła do CA ofertę cenową, która jest następnie oceniana przez CA pod kątem ograniczeń i wartości rezerwacyjnych. Następnie CA generuje kontrpropozycję i przesyła ją do PA, który ją ocenia i wysyła kolejną kontrpropozycję do CA. Proces ten trwa do momentu, aż jeden z negocjatorów przedstawi ofertę akceptowalną dla obu stron lub jeden z agentów wycofa się z negocjacji (np. w przypadku upłynięcia terminu bez osiągnięcia porozumienia). Zatem w każdej rundzie negocjacyjnej agenci mogą: (i) zaakceptować poprzednią ofertę, jeśli ich ograniczenia zostały uwzględnione, (ii) wygenerować kontrpropozycję lub (iii) wycofać się z negocjacji. Ilość pla oznacza ofertę cenową zaproponowaną przez agenta negocjacyjnego a podczas rundy negocjacyjnej l. Propozycja cenowa ∉plb jest zawsze odrzucana przez agenta a, jeśli plb ∉ [pma, pMa]
, gdzie [pma, pMa]oznacza akceptowalny przedział cenowy agenta a. W przypadku osiągnięcia porozumienia negocjacje nazywamy sukcesem, natomiast w przypadku rezygnacji jednej ze stron negocjacji, negocjacje uznajemy za nieudane. W każdym innym przypadku mówimy, że wątek negocjacji jest aktywny. Celem naszego problemu jest przewidzenie zachowania agenta w przyszłych rundach negocjacji do czasu upływu terminu wyznaczonego przez agenta. Dokładniej rzecz ujmując, badany problem negocjacyjny można formalnie przedstawić następująco:
Biorąc pod uwagę: (i) dwie strony negocjujące: Dostawcę oferującego określone dobro i Klienta zainteresowanego nabyciem tego dobra, (ii) akceptowalny przedział cenowy [pmc, pMC] dla Klienta, (iii) termin TC, do którego Klient musi zakończyć negocjacje z Dostawcą, (iv) indeks ostatniej rundy negocjacyjnej LC dla Klienta, (v) próg rundy LdC, do którego Klient musi zdecydować, czy kontynuować udział w negocjacjach, czy nie, oraz (vi) wektor PlP = {plP}, gdzie l = 2k - 1 i  cen zaproponowanych przez Dostawcę podczas początkowych rund negocjacyjnych LdC - 1, znajdź (i) wektor Pl′P = {pl′P} , gdzie l′ = 2k′ - 1 i
 , cen, które zostaną zaproponowane przez Dostawcę podczas ostatnich rund LC - LdC, oraz (ii) decyduje, czy Klient powinien kontynuować udział w danym wątku negocjacyjnym, czy nie.
STRATEGIA NEGOCJACJI OPARTA NA SIECIACH NEURONOWYCH
Polityka stosowana przez agentów negocjacyjnych w celu wygenerowania nowej oferty nazywana jest strategią negocjacyjną. Zasadniczo można wyróżnić trzy główne rodziny zautomatyzowanych strategii negocjacyjnych: strategie zależne od czasu, strategie zależne od zasobów i strategie zależne od zachowania strategie te to dobrze zdefiniowane funkcje, które mogą wykorzystywać różne parametry wejściowe w celu wygenerowania wartości negocjowanego zagadnienia, które ma zostać zaproponowane w bieżącej rundzie negocjacji. Proponowany mechanizm wzbogaca każdą ze starszych strategii o techniki uczenia się oparte na sieciach neuronowych (NN). W badanym kontekście strategie wspomagane przez NN są wykorzystywane przez CA do szacowania przyszłego zachowania PA. W niniejszej sekcji przedstawiono proponowaną strategię wspomaganą przez NN i opisano specyfikę zastosowanych NN.
Włączenie predykcji zachowań PA
Jak już wspomniano, badania przedstawione w niniejszym artykule mają na celu oszacowanie parametrów regulujących strategię PA, umożliwiających CA przewidywanie przyszłych ofert cenowych PA. Celem jest podjęcie decyzji na wczesnym etapie, czy dążyć do porozumienia z konkretnym PA, czy wycofać się z wątku negocjacyjnego tak wcześnie, jak to możliwe, jeśli porozumienie nie jest możliwe. W tym celu zastosowano dwie różne sieci neuronowe (NN). Sieci te są trenowane w trybie off-line z wykorzystaniem odpowiednich zestawów treningowych, a następnie wykorzystywane w negocjacjach online, gdy tylko CA tego wymaga. Procedura rozpoczyna się normalnie i dopóki PA złoży wystarczającą liczbę propozycji, CA wykorzystuje sieci neuronowe do wiarygodnej predykcji strategii przeciwnika. Wymaga to tylko kilku rund negocjacyjnych (w porównaniu z rundą wygaśnięcia terminu w CA) i to jest główny powód, dla którego ta technika okazuje się niezwykle użyteczna. Oprócz przedziału [pma,pMa] , istnieją głównie 3 inne parametry, które określają strategię negocjacyjną agenta: parametr ka ∈ [0,1], który określa początkową ofertę złożoną przez agenta w chwili t = 0, stawkę ustępstwa β > 0 oraz ostatnią rundę agenta płatniczego Lp. W niniejszym artykule ka nie znajduje się wśród parametrów predykcji, ponieważ bezpiecznie zakłada się, że agent płatniczy rozpoczyna procedurę od swojej maksymalnej oferty cenowej. Bez utraty ogólności skupiamy się na przypadku, w którym agent płatniczy stosuje wielomianową strategię dowolnego wskaźnika ustępstwa i limitu czasu. Agent płatniczy negocjuje w oparciu o dotychczasową strategię do rundy LdC. Następnie agent płatniczy wykorzystuje sieci neuronowe do uzyskania oszacowań  i
 . Runda LdC będzie dalej nazywana rundą predykcji. W przeprowadzonych eksperymentach LdC = 30 i LC = 100. Na podstawie historii ofert cenowych agencji ratingowej, sieci neuronowe (NN) próbują uzyskać wiarygodną estymację funkcji generowania ofert przez agencję ratingową. Następnie agencja ratingowa (CA) może określić, czy bieżący wątek negocjacyjny może doprowadzić do porozumienia, czy też jest to niemożliwe ze względu na termin końcowy agencji ratingowej. W ten sposób strategia wspomagana przez sieci neuronowe (NN) pozwala agencji ratingowej zaoszczędzić czas i wcześniej wycofać się z wątków negocjacyjnych, które zakończą się niepowodzeniem.
Zastosowane sieci neuronowe
W naszym modelu, gdzie wymagana jest predykcja funkcji ciągłej, wybraliśmy do badania dwa typy sieci neuronowych bez pętli sprzężenia zwrotnego: wielowarstwową sieć neuronową perceptronu (MLP) oraz sieć neuronową regresji uogólnionej (GR). Ta druga jest szczególnym przypadkiem sieci neuronowej z radialną funkcją bazową (RBF), która jest bardziej odpowiednia do aproksymacji funkcji on-line . Obie sieci wybrano ze względu na ich przydatność w tego typu problemach. W przypadku sieci MLP zastosowaliśmy funkcję treningową opartą na algorytmie Levenberga-Marquardta , ponieważ jest ona najwygodniejsza w tego typu problemach. Sieć została prawidłowo wytrenowana na ponad 190 różnych wektorach wejściowych (po 200 epok każdy), reprezentujących różne kombinacje ofert PA w oparciu o określoną strategię. Najlepsza architektura MLP została wybrana po przeprowadzeniu obszernych eksperymentów i ustawiona na 23 (log-sigmoidalne) - 3 (liniowe) neurony, odpowiednio dla warstwy ukrytej i wyjściowej. Podobnie, sieć GR została wytrenowana na ponad 280 różnych wektorach, aby uzyskać dokładne charakterystyki wydajności, co zaowocowało architekturą 280 (ukryte neurony RBF) - 3 (wyjściową). Obie sieci neuronowe są wykorzystywane przez CA i mogą zapewnić wiarygodne przewidywanie zachowania PA, gdy tylko dostępna jest wystarczająca liczba próbek wejściowych (propozycji). Przeprowadzone eksperymenty i ocena wydajności sieci neuronowych zostały przedstawione w dwóch kolejnych sekcjach.
EKSPERYMENTY
W tej sekcji przedstawiono eksperymenty przeprowadzone w celu oceny wydajności zaprojektowanych sieci neuronowych MLP i GR, dotyczące szacowania przyszłego zachowania negocjującego PA. Pierwsza rodzina eksperymentów ma na celu porównanie rzeczywistego zachowania PA z przewidywanym przez sieci neuronowe MLP i GR, gdy [ pPm, pPM ] = [ ,0100] , Lp = 200 i β ∈ [0,1, 10]. Wartości próby dla β pochodzą z jednorodnie rozłożonego wektora losowego 100 wartości w wyżej wymienionym obszarze: 50 β < 1 (Boulware) i 50 β> 1 (Conceder). Oszacowane parametry obejmują: przyszłe oferty PA do 100-tnej rundy negocjacji, minimalną ofertę cenową PA do tego czasu oraz stawkę koncesji PA (β). Druga rodzina eksperymentów bada przypadek, gdy pPm, pPM ] = [ ,0100], β=1 i Lp ∈ [150, 250]. Wartości przykładowe dla Lp wynoszą: 150:1:250. Szacowane parametry obejmują: przyszłe oferty cenowe PA do 100-tej rundy negocjacji oraz minimalną ofertę cenową PA do tego czasu. Jak pokazano na Rysunku 1, gdzie przedstawiono pierwszy zestaw eksperymentów, sieci MLP i GR-NN działają bardzo podobnie, dokładnie prognozując ogólną ofertę cenową PA.
 Na tym samym Rysunku można zaobserwować, że obie sieci NN są używane do momentu, gdy β ≤ 2,8. W przypadku wyższych stawek koncesyjnych i wielomianowych strategii PA, porozumienie osiąga się przed 30. rundą, a sieć NN nie jest konieczna do przewidywania zachowania przeciwnika. Jak pokazano na Rysunku 2, gdzie sieci NN są testowane w liniowej strategii PA, sieci MLP i GR-NN działają niemal identycznie, szacując ofertę cenową PA z niskim marginesem błędu.

Jednakże odchylenie między rzeczywistymi a szacowanymi ofertami PA rośnie wraz ze wzrostem indeksu rundy i skracaniem się czasu oczekiwania na PA. Wynika to z faktu, że obie sieci neuronowe mają tendencję do nieznacznego niedoszacowania stawki koncesyjnej PA, zwłaszcza gdy β ≥ 0,5. Potwierdza to rysunek 3a, na którym oszacowania stawki koncesyjnej MLP-NN i GR-NN są przedstawione wraz z rzeczywistą wartością β z PA, dla całego zestawu przeprowadzonych eksperymentów.

Wreszcie, jak pokazano na rysunku 3b, w odniesieniu do oszacowania minimalnej oferty cenowej PA, MLP nieznacznie przewyższa GR. Krótką analizę wszystkich tych ustaleń przedstawiono w następnej sekcji.

OCENA
W Tabeli przedstawiono wyniki porównawcze dla dwóch rodzin eksperymentów w odniesieniu do średnich błędów estymacji sieci MLP i GR NN dotyczących oferty cenowej PA, minimalnej oferty cenowej PA oraz stawki koncesyjnej PA.

Dla wszystkich rodzin eksperymentów mamy ] pPm, pPM ] = [ ,0100]. Pozostałe ustawienia parametrów przedstawiono w pierwszej kolumnie tabeli, natomiast w drugiej kolumnie podano liczbę eksperymentów, w których zastosowano estymację sieci NN. Wyniki przedstawione w pozostałej części tabeli wskazują, że sieć NN MLP nieznacznie przewyższa sieć GR NN w odniesieniu do estymacji oferty cenowej PA (minimalnej), wykazując średnio o 0,5% - 2,4% wyższą dokładność. Jednakże, odwrotnie jest w przypadku estymacji beta PA, ponieważ sieć NN GR zapewnia dokładniejsze estymacje, średnio o ponad 3%. W Tabeli 2 przedstawiono wyniki oceny dla dwóch strategii negocjacyjnych wspomaganych przez sieci neuronowe (NN) dla obu rodzin eksperymentów, przy założeniu, że pCM = 501.

Wyniki te obejmują liczbę nieudanych wątków negocjacyjnych (UNT) (które wynikają z faktu, że pPm > pCM i czas trwania UNT (LC = 1002) w przypadku braku użycia mechanizmu przewidywania zachowania przeciwnika, liczbę UNT wykrytych przez sieci neuronowe w rundzie 30, UNT wykryte i tym samym zakończone przedwcześnie przez sieci neuronowe, średni czas trwania UNT i średni czas trwania UNT maleją. Wyniki te wskazują, że sieci neuronowe MLP i GR NN identyfikują średnio odpowiednio ∿91% i ∿83% UNT. Ponadto sieci neuronowe MLP i GR NN osiągają średnio odpowiednio ∿64% i ∿58% redukcji czasu trwania UNT. Jeśli chodzi o eliminację UNT,strategia wspomagana przez MLP wyraźnie przewyższa strategię negocjacji wspomaganą przez GR. Z powyższych powodów szacuje się, że sieci neuronowe MLP są bardziej odpowiednie do wspomagania inteligentnych agentów negocjacyjnych w przewidywaniu zachowania przeciwnika na wczesnym etapie rundy negocjacyjnej, w przypadku gdy agent ceni sobie szybkie wykrycie nieudanych wątków negocjacyjnych.
WNIOSKI
W niniejszym artykule zaproponowano wykorzystanie sieci neuronowych w celu wzmocnienia agentów negocjacyjnych za pomocą technik uczenia się, umożliwiających im przewidywanie zachowań negocjacyjnych przeciwnika. Zaprojektowana strategia negocjacyjna wspomagana przez sieci neuronowe okazuje się bardzo użyteczna, ponieważ prowadzi do znacznego skrócenia czasu trwania nieudanych wątków negocjacyjnych, dzięki temu, że przypadki, w których porozumienia nie są możliwe do osiągnięcia, są wykrywane na wczesnym etapie. W ten sposób sieci neuronowe wspierają decyzję agentów o wycofaniu się z trwających wątków negocjacyjnych lub nie. Mówiąc dokładniej, gdy agent negocjacyjny korzysta ze strategii wspomaganych przez sieci neuronowe, jest w stanie przewidzieć zachowanie przeciwnika z dużą dokładnością, a tym samym poznać potencjalny wynik negocjacji. Zarówno badane sieci neuronowe MLP, jak i GR wykazują średni błąd oszacowania ceny przeciwnika niższy niż 2%, a minimalny akceptowalny błąd oszacowania ceny PA wynosi ∿6%. Ponadto, nieudane negocjacje są wykrywane przez sieć neuronową MLP w ponad 90% przypadków, co oznacza o ∿8% lepszą ogólną wydajność niż sieć GR. Zatem sieć neuronowa MLP okazuje się bardziej odpowiednia, gdy CA ma na celu uniknięcie potencjalnie nieopłacalnego lub wręcz niemożliwego do osiągnięcia porozumienia. Prowadzi to do minimalizacji wymaganego czasu i zasobów przetwarzania oraz maksymalizacji całkowitego zysku CA z serii wątków dla jednego towaru.
Selekcja wielomodelowa EA dla SVM
WSTĘP
Algorytmy ewolucyjne (EA) (Rechenberg, 1965) należą do rodziny stochastycznych algorytmów przeszukiwania inspirowanych ewolucją naturalną. W ostatnich latach EA były z powodzeniem wykorzystywane do generowania efektywnych rozwiązań dla wielu trudnych problemów optymalizacyjnych . Algorytmy te działają na populacji potencjalnych rozwiązań i stosują zasadę przetrwania zgodnie z miarą dopasowania powiązaną z każdym rozwiązaniem, aby uzyskać lepsze przybliżenia rozwiązania optymalnego. W każdej iteracji tworzony jest nowy zestaw rozwiązań poprzez selekcję osobników według ich poziomu dopasowania i zastosowanie do nich kilku operatorów. Operatory te modelują procesy naturalne, takie jak selekcja, rekombinacja, mutacja, migracja, lokalność i sąsiedztwo. Chociaż podstawowa idea EA jest prosta, kodowanie rozwiązań, wielkość populacji, funkcja dopasowania i operatory muszą być zdefiniowane zgodnie z rodzajem problemu, który ma zostać zoptymalizowany. Problemy wieloklasowe z binarnymi klasyfikatorami SVM (Support Vector Machine) są powszechnie traktowane jako rozkład na kilka binarnych podproblemów. Otwartym pytaniem jest, jak prawidłowo wybrać wszystkie modele dla tych podproblemów, aby uzyskać najniższy wskaźnik błędów dla konkretnego schematu wieloklasowego SVM. W niniejszym artykule proponujemy nowe podejście do optymalizacji zdolności generalizacyjnych takich wieloklasowych schematów SVM. Podejście to polega na globalnej selekcji modeli dla wszystkich podproblemów i jest określane jako selekcja wielomodelowa. Selekcja wielomodelowa może przewyższyć klasyczną selekcję pojedynczych modeli stosowaną dotychczas w literaturze, ale ten typ selekcji definiuje trudny problem optymalizacyjny, ponieważ odpowiada poszukiwaniu efektywnego rozwiązania w ogromnej przestrzeni. Dlatego proponujemy zaadaptowaną metodę optymalizacji (EA), aby osiągnąć tę selekcję wielomodelową poprzez zdefiniowanie określonej funkcji dopasowania i operatora rekombinacji.
TŁO
Problem klasyfikacji wieloklasowej odnosi się do przypisania klasy do wektora cech w zestawie możliwych wektorów. Spośród wszystkich możliwych induktorów, SVM (ang. Support Vector Machine) charakteryzuje się szczególnie wysokimi zdolnościami generalizacji i zyskała dużą popularność w ostatnich latach. SVM to jednak klasyfikatory binarne i opracowano kilka schematów kombinowanych, aby rozszerzyć SVM o problemy z więcej niż dwiema klasami . Schematy te opierają się na różnych zasadach: prawdopodobieństwie , kodach korekcji błędów ), klasyfikatorach korekcyjnych oraz teorii dowodów. Wszystkie te schematy kombinacji obejmują następujące trzy kroki: 1) rozkład problemu wieloklasowego na kilka podproblemów binarnych, 2) trenowanie SVM na wszystkich podproblemach w celu wygenerowania odpowiadających im binarnych funkcji decyzyjnych oraz 3) strategia dekodowania w celu podjęcia ostatecznej decyzji na podstawie wszystkich decyzji binarnych. Trudności zależą od wyboru schematu kombinacji i sposobu jego optymalizacji . W niniejszym artykule skupiamy się na kroku 2), gdy kroki 1) i 3) są już ustalone. W tym kroku każdy problem binarny musi odpowiednio dostroić hiperparametry (model) SVM, aby uzyskać globalnie niski wskaźnik błędów wieloklasowych przy użyciu kombinacji wszystkich zaangażowanych binarnych funkcji decyzyjnych. Poszukiwanie efektywnych wartości hiperparametrów jest powszechnie projektowane w ramach selekcji modelu. Klasycznym sposobem optymalizacji schematów wieloklasowych jest indywidualny wybór modelu dla każdego powiązanego podproblemu binarnego. Ta metodologia zakłada, że schemat wieloklasowy oparty na kombinacji SVM jest optymalny, gdy każdy klasyfikator binarny biorący udział w tym schemacie kombinacji jest optymalny dla dedykowanego problemu binarnego. Jeśli jednak założymy, że strategia dekodowania może w mniejszym lub większym stopniu korygować błędy klasyfikatorów binarnych, wówczas indywidualny wybór modelu binarnego dla każdego podproblemu binarnego nie może uwzględniać możliwości korekcji błędów. Z tego głównego powodu uważamy, że innym sposobem na optymalizację schematów wieloklasowych jest globalna selekcja wielomodelowa dla problemów binarnych. W rzeczywistości celem jest minimalizacja błędów w problemie wieloklasowym. Selekcja wszystkich modeli podproblemów (selekcja wielomodelowa) musi być przeprowadzona globalnie, aby osiągnąć ten cel, nawet jeśli oznacza to, że wskaźniki błędów nie są optymalne dla wszystkich podproblemów binarnych, gdy są one obserwowane indywidualnie. EA to efektywne podejście metaheurystyczne do realizacji takiej selekcji wielomodelowej.
SELEKCJA WIELOMODELOWA W EA
Ta sekcja jest podzielona na 3 podsekcje. W pierwszej sekcji przedstawiono problem optymalizacji wielomodelowej dla schematów kombinacji wieloklasowych. Przedstawiono więcej szczegółów niż w poprzedniej sekcji oraz przydatne oznaczenia do kolejnych podsekcji. W drugiej sekcji przedstawiono nasz wybór wielomodelowy algorytmu optymalizacji (EA). Opisano szczegóły dotyczące szacowania dopasowania wielomodelowego i operatora krzyżowania na nich. W trzeciej sekcji przedstawiono protokół eksperymentalny i wyniki z naszym wyborem wielomodelowym algorytmu optymalizacji (EA).
Problem optymalizacji wielomodelowej
Schemat kombinacji wieloklasowej indukuje kilka podproblemów binarnych. Liczba k i charakter podproblemów binarnych zależą od rozkładu zastosowanego w schemacie kombinacji. Dla każdego podproblemu binarnego należy wytrenować SVM, aby wygenerować odpowiednią funkcję decyzyjną hi (1 < i < k). Jakość hi jest w dużym stopniu zależna od wybranego modelu θi i jest charakteryzowana przez oczekiwany współczynnik błędu ei dla nowych zbiorów danych z tym samym rozkładem binarnym. Każdy model θi zawiera wszystkie wartości hiperparametrów do trenowania SVM na dedykowanym podproblemie binarnym. Oczekiwany współczynnik błędu ei powiązany z modelem θi jest powszechnie określany za pomocą technik walidacji krzyżowej. Wszystkie modele θi tworzą model wielomodelowy θ = (θ1, …., θk). Oczekiwany współczynnik błędu e schematu kombinacji wieloklasowej SVM jest bezpośrednio zależny od wybranego modelu wielomodelowego θ. Niech Θ oznacza przestrzeń wielomodelową dla problemu wieloklasowego (tj. ∀θ :θ ∈ Θ), a Θi przestrzeń modelową dla i-tego podproblemu binarnego. Najlepszym wielomodelem θ* jest ten, dla którego błąd oczekiwany e jest minimalny i odpowiada on następującemu problemowi optymalizacyjnemu.

gdzie e(θ) oznacza oczekiwany błąd e schematu kombinacji wieloklasowej z wielomodelowym θ. Ogromny rozmiar przestrzeni wielomodelowej (Θ = ×i?[1,k]Θi) sprawia, że problem optymalizacji (0.1) jest bardzo trudny. Aby zmniejszyć złożoność problemu optymalizacji, klasyczną metodą jest użycie następującego przybliżenia:

Postawiono hipotezę, że

Hipoteza ta zakłada również, że

Jeśli jest oczywiste, że każdy indywidualny model θi w najlepszym wielomodelowym θ* musi odpowiadać efektywnemu SVM (tj. niskiej wartości ei) w odpowiadającym i-tym podproblemie binarnym, wszystkie najlepsze indywidualne modele (θ1*,…,θk*)niekoniecznie definiują najlepszy wielomodelowy θ*. Pierwszympowodem jest to, że wszystkie współczynniki błędów ei są szacowane z pewną tolerancją, a połączenie wszystkich tych odchyleń może mieć duży wpływ na ostateczny wieloklasowy współczynnik błędów e. Drugim powodem jest to, że nawet jeśli wszystkie klasyfikatory binarne schematu kombinacji mają identyczne współczynniki błędów ei dla różnych wielomodeli, te klasyfikatory binarne mogą mieć różne predykcje klas binarnych dla tego samego przykładu, w zależności od użytego wielomodelu. W rzeczywistości predykcje wieloklasowe uzyskane poprzez połączenie tych klasyfikatorów binarnych mogą być różne dla tego samego przykładu wektora cech, ponieważ korekta związana z daną strategią dekodowania zależy od charakteru błędów wewnętrznych klasyfikatorów binarnych (głównie liczby błędów). Następnie, wieloklasowe schematy klasyfikacji z tymi samymi błędami wewnętrznymi ei, ale różnymi wielomodelami θ, mogą mieć różną zdolność generalizacji. Z tych wszystkich powodów twierdzimy, że problem optymalizacji wielomodelowej (0,1) może przewyższyć optymalizację pojedynczego modelu (0,2).
Ewolucyjna Metoda Optymalizacji
W naszej metodzie selekcji wielomodelowej AE, miara dopasowania f jest powiązana z wielomodelowym θ, który jest tym większy, im błąd e powiązany z θ jest mały; pozwala to rozwiązać problem optymalizacji (0,1). Wartość dopasowania jest normalizowana tak, aby f = 1, gdy błąd e wynosi zero, oraz f = 0, gdy błąd e odpowiada losowaniu. Co więcej, liczba przykładów w każdej klasie nie zawsze jest dobrze zrównoważona dla wielu wieloklasowych zbiorów danych; aby temu zaradzić, błąd e odpowiada zrównoważonej stopie błędów (BER). W odniesieniu do tych dwóch kluczowych punktów, proponowane sformułowanie dopasowania jest następujące:

gdzie nc oznacza liczbę klas w problemie wieloklasowym. W ten sam sposób, dopasowanie wewnętrzne fi jest definiowane jako fi = 1 - 2ei dla i-tego klasyfikatora binarnego z odpowiadającym mu BER ei. Operator krzyżowania EA dla kombinacji dwóch multimodeli θ1 i θ2 musi faworyzować wybór najefektywniejszych modeli w tych dwóch multimodelach. Warto zauważyć, że nie należy systematycznie wybierać wszystkich najlepszych modeli w celu wygenerowania efektywnego multimodelu θ, jak wyjaśniono w poprzednim podrozdziale. Dla każdego podproblemu, dopasowanie wewnętrzne fi1 i fi2 jest używane do określenia prawdopodobieństwa.

gdzie nc oznacza liczbę klas w problemie wieloklasowym. W ten sam sposób, dopasowanie wewnętrzne fi jest zdefiniowane jako fi = 1 - 2ei dla i-tego klasyfikatora binarnego z odpowiadającym mu BER ei. Operator krzyżowania EA dla kombinacji dwóch multimodeli θ1 i θ2 musi faworyzować wybór najefektywniejszych modeli w tych dwóch multimodelach. Warto zauważyć, że nie należy systematycznie wybierać wszystkich najlepszych modeli w celu wygenerowania efektywnego multimodelu potomnego θ, jak wyjaśniono w poprzednim podrozdziale. Dla każdego podproblemu, dopasowanie wewnętrzne fi1 i fi2 jest używane do określenia prawdopodobieństwa

wyboru i-tego modelu w θ1 jako i-tego modelu w multimodelu potomnym θ. fij oznacza dopasowanie wewnętrzne i-tego klasyfikatora binarnego z multimodelem θj. W przypadku multimodeli potomnych generowanych przez operator krzyżowania, istotną zaletą jest to, że nie jest konieczne nowe trenowanie SVM, jeśli wszystkie powiązane klasyfikatory binarne zostały już wytrenowane. Wręcz przeciwnie, należy ocenić jedynie wskaźniki błędów BER wszystkich multimodeli potomnych. Trenowanie SVM jest konieczne tylko na pierwszym etapie algorytmu transformacji (EA) oraz gdy modele przechodzą przez operator mutacji. Reszta naszego algorytmu transformacji (EA) dla selekcji wielomodelowej jest podobna do innych podejść algorytmu transformacji (EA). Najpierw, na etapie inicjalizacji, populacja λ multimodeli jest generowana losowo. Każdy model θij (1 ≤ i ≤ λ 1 ≤ j ≤ k) odpowiada jednorodnej losowości we wszystkich możliwych wartościach hiperparametrów SVM. Nowe multimodele są generowane poprzez kombinację par multimodeli wybranych za pomocą strategii Stochastic Universal Sampling (SUS). Do selekcji SUS używana jest stała presja selekcyjna ps. Każdy model θij ma prawdopodobieństwo mutacji pm/k (jednolicie losowe, jak w kroku inicjalizacji algorytmu adaptacyjnego). Następnie oceniane jest dopasowanie f wszystkich potomnych multimodeli. Drugi krok selekcji służy do zdefiniowania populacji kolejnej iteracji naszego algorytmu adaptacyjnego. Osobniki λ są wybierane za pomocą strategii SUS (stosowana jest ta sama presja selekcyjna ps) zarówno spośród rodziców λ, jak i dzieci λ. Stają się one populacją wielomodelową w kolejnej iteracji. Liczba iteracji algorytmu adaptacyjnego jest ustalona na nmax. Na końcu algorytmu adaptacyjnego, multimodel o najlepszym dopasowaniu f ze wszystkich tych iteracji jest wybierany jako θ*.
Wyniki eksperymentalne
W tej sekcji wykorzystano trzy dobrze znane zbiory danych wieloklasowych: Satimage (nc = 6), Letter (nc = 26) z kolekcji Statlog oraz zbiór danych USPS (nc = 10) . W pracy (Wu, Lin i Weng, 2004) do utworzenia zbiorów danych treningowych/testowych wykorzystano dwie wielkości próby: 300/500 i 800/1000. Dla każdej wielkości próby wygenerowano 20 losowych podziałów. Zastosowaliśmy te same wielkości próby i ten sam podział dla 3 zbiorów danych: Satimage, Letter i USPS. Do wyboru najlepszego wielomodelowego θ* dla każdego zbioru danych treningowych zastosowano dwie metody optymalizacji. Pierwsza to klasyczny wybór pojedynczego modelu, a druga to nasz wielomodelowy wybór EA. W obu metodach zastosowano dwa schematy kombinacji: jeden na jeden i jeden na wszystkich . Dla każdego problemu binarnego trenowany jest SVM z jądrem Gaussa K(u,v) = exp(-γ||u - v||2) . Możliwe wartości hiperparametrów SVM dla modelu to stała SVM C trade-off oraz pasmo γ funkcji jądra Gaussa (θi ≡ (Ci, γi)). Dla wszystkich problemów binarnych: θi ∈ Θi = [2-5, 2-3,…,215] × [2-5, 2-3,…,215]. Model przestrzeni indywidualnej Θi jest oparty na technikach przeszukiwania siatki. BER e dla problemu wieloklasowego i BER ei dla podproblemów binarnych są szacowane przez pięciokrotną walidację krzyżową (CV). Te wartości BER są używane przez nasz algorytm doboru próby (EA) do selekcji wielomodelowej. Ostateczny BER e wybranego wielomodelu przez nasz algorytm doboru próby jest szacowany na podstawie testowych zestawów danych, które nie były używane w procesie selekcji wielomodelowej. Nasz algorytm doboru próby ma kilka stałych, które muszą być stałe, i dokonaliśmy następujących wyborów: ps = 2, λ = 50, nmax = 100, pm = 0,01. Tabela podaje średni BER dla wszystkich 20 podzielonych zestawów wcześniej wspomnianych zestawów danych dla każdego rozmiaru zestawu treningowego (rozmiar wiersza tabeli 1).

Jest to zrobione dla dwóch schematów kombinacji (jeden na jeden i jeden na wszystkie) oraz dla dwóch wyżej wymienionych metod selekcji (kolumny ēklasyczny i ēEA). Kolumna Δē podaje średnią wariancję BER między naszym wyborem wielomodelowym a klasycznym. Wyniki tej kolumny są szczególnie ważne. Dla dwóch zbiorów danych (USPS i Letter) nasza metoda optymalizacji generuje schematy kombinacji SVM o najlepszych możliwościach generalizacji niż metoda klasyczna. Efekt ten wydaje się być bardziej wyraźny wraz ze wzrostem liczby klas w problemie wieloklasowym. Powodem jest to, że rozmiar przeszukiwania przestrzeni wielomodelowej rośnie wykładniczo wraz z liczbą k problemów binarnych zaangażowanych w schemat kombinacji (121 tys. dla tych eksperymentów). Efekt ten jest bezpośrednio powiązany z liczbą klas nc i może wyjaśniać, dlaczego poprawy nie są mierzalne w zbiorze danych Satimage. W pewnym sensie klasyczna metoda optymalizacji bada przestrzeń wielomodelową Θ w trybie migania, ponieważ skumulowany efekt kombinacji k funkcji decyzyjnych SVM nie mógł zostać określony bez oszacowania e. Efekt ten jest podkreślany, gdy oszacowane BER ei są słabe (tj. rozmiar danych treningowych i testowych jest mały). Porównanie wartości Δē przy zmianie rozmiaru zbioru danych treningowych/testowych w tabeli ilustruje to zjawisko.
PRZYSZŁE TRENDY
Proponowaną metodę selekcji wielomodelowej w algorytmie doboru wartości (EA) należy przetestować z innymi schematami kombinacji , takimi jak kody wyjściowe z korekcją błędów, aby zmierzyć ich wpływ. Należy również przetestować wpływ na inne zbiory danych, które charakteryzują się dużym zakresem liczby klas. Istotne jest również dodanie możliwości selekcji cech do naszej selekcji wielomodelowej w algorytmie doboru wartości (AE). Kolejnym kluczowym aspektem, który należy wziąć pod uwagę, jest skrócenie czasu uczenia się naszej metody EA, który jest w rzeczywistości kosztowny. Jednym ze sposobów zbadania tego jest zastosowanie szybkiej techniki estymacji błędu CV do estymacji BER.
WNIOSKI
W niniejszym artykule zaproponowano nową metodę selekcji wielomodelowej w algorytmie doboru wartości (EA) w celu optymalizacji możliwości generalizacji schematów kombinacji SVM. Definicja operatora krzyżowania oparta na wewnętrznej sprawności SVM dla każdego problemu binarnego stanowi sedno naszej metody EA. Wyniki eksperymentów pokazują, że nasza metoda zwiększa możliwości generalizacji schematów kombinacji jeden na jeden i jeden na wszystkie w porównaniu z metodą indywidualnego wyboru modelu.
Solidny algorytm uczenia się z funkcją błędu LTS
WSTĘP
Sieci neuronowe ze sprzężeniem zwrotnym (FFN) są często uważane za uniwersalne narzędzia i znajdują zastosowanie w takich obszarach, jak aproksymacja funkcji, rozpoznawanie wzorców czy przetwarzanie sygnałów i obrazów. Jedną z głównych zalet stosowania FFN jest to, że zazwyczaj nie wymagają one w procesie uczenia dokładnej wiedzy matematycznej na temat zależności między wejściem a wyjściem. Innymi słowy, można je uważać za aproksymatory bezmodelowe (Hornik, 1989). Uczą się one poprzez minimalizację pewnego rodzaju funkcji błędu, aby jak najlepiej dopasować dane treningowe. Taki schemat uczenia się nie uwzględnia jakości danych treningowych, dlatego jego wydajność w dużym stopniu zależy od tego, czy spełnione jest założenie, że dane są wiarygodne i wiarygodne. Dlatego też, gdy dane są zniekształcone przez duży szum,lub gdy pojawiają się wartości odstające i błędy rażące, sieć buduje model, który może być bardzo niedokładny. W większości przypadków rzeczywistych założenie, że błędy są normalne i niezależne od rzeczywistości (iid), po prostu nie jest spełnione. Dane uzyskane ze środowiska są bardzo często obciążone szumem o nieznanej formie lub wartościami odstającymi, podejrzewanymi o błędy grube. Liczba wartości odstających w danych rutynowych waha się od 1 do 10%. Zwykle pojawiają się one w zbiorach danych podczas pozyskiwania informacji i ich wstępnego przetwarzania, gdy na przykład mogą wystąpić błędy pomiarowe, szum długoogonowy lub wyniki błędów ludzkich. Intuicyjnie możemy zdefiniować wartość odstającą jako obserwację, która znacząco odbiega od większości danych. Niemniej jednak definicja ta nie pomaga w klasyfikowaniu wartości odstającej jako błędu grubego lub znaczącej i ważnej obserwacji. Aby poradzić sobie z problemem wartości odstających, opracowano odrębną gałąź statystyki, zwaną statystyką odporną (Hampel, 1986, Huber, 1981). Odporne metody statystyczne są zaprojektowane tak, aby działać dobrze, gdy prawdziwy model bazowy odbiega od założonego modelu parametrycznego. W idealnym przypadku powinny być one wydajne i wiarygodne dla obserwacji bardzo zbliżonych do założonego modelu, a jednocześnie dla obserwacji zawierających większe odchylenia i wartości odstające. Innym sposobem jest wykrywanie i usuwanie wartości odstających przed rozpoczęciem procesu budowy modelu. Takie metody są bardziej uniwersalne, ale nie uwzględniają specyficznego rodzaju filozofii modelowania (np. modelowania za pomocą sieci FFN). W niniejszym artykule proponujemy nowy, odporny algorytm uczenia się sieci FFN oparty na estymatorze najmniejszych przyciętych kwadratów.
TŁO
Najpopularniejszy schemat uczenia się sieci FFN wykorzystuje strategię propagacji wstecznej (BP) i minimalizację błędu średniokwadratowego (MSE). Do tej pory zaproponowano kilka różnych algorytmów uczenia się sieci BP. Generalnie wykorzystują one ideę odpornych estymatorów. To podejście zostało zaadaptowane do algorytmów uczenia się sieci neuronowych poprzez zastąpienie MSE funkcją błędu straty o takim kształcie, że wpływ wartości odstających może być w pewnych warunkach zmniejszony, a nawet wyeliminowany. Chen i Jain (1994) zaproponowali hiperboliczny tangens Hampela jako nowe kryterium błędu, z estymatorem skali ?, który definiuje przedział, który ma zawierać wyłącznie czyste dane, w zależności od założonej liczby wartości odstających lub bieżących wartości błędów. Pomysł ten został połączony z koncepcją wyżarzania autorstwa Chunaga i Su (2000). Zastosowali oni schemat wyżarzania w celu zmniejszenia wartości β, podczas gdy Liano (1996) wprowadził logistyczną funkcję błędu wyprowadzoną z założenia o błędach generowanych za pomocą rozkładu Cauchy′ego. Pernia-Espinoza i inni przedstawili funkcję błędu opartą na estymatorach tau. Zaproponowano również podejście oparte na adaptacyjnym tempie uczenia się . Takie modyfikacje mogą znacząco poprawić wydajność sieci w przypadku uszkodzonych zbiorów treningowych. Jednak nawet te podejścia obarczone są pewnymi trudnościami i nie mogą być uważane za uniwersalne (również ze względu na właściwości stosowanych estymatorów). Poza tym, do dziś zaproponowano ich bardzo niewiele, a wykorzystują one tę samą podstawową ideę, więc wciąż musimy szukać nowych rozwiązań.
ALGORYTM UCZENIA SIĘ ODPORNEGO LTS
Najmniejsze przycięte kwadraty
Estymator najmniejszych przyciętych kwadratów (LTS), wprowadzony przez Rousseuwa (1984, 1985), to klasyczny, odporny estymator o wysokim punkcie załamania, podobny do wolniej zbieżnej najmniejszej mediany kwadratów (LMS) . Estymator i jego estymatory są często wykorzystywane w problemach regresji liniowej i nieliniowej, w analizie wrażliwości, poprawkach dla małych prób lub w prostym wykrywaniu wartości odstających. Główną różnicą między estymatorem LTS a najmniejszą sumą kwadratów, a także M-estymatorami, jest oczywiście operacja wykonywana na resztach. W tym przypadku jednak odporność osiąga się nie poprzez zastąpienie kwadratu inną funkcją, ale poprzez zastąpienie znaku sumowania czymś innym. Nieliniowy estymator najmniejszych przyciętych kwadratów jest wówczas definiowany jako:

gdzie (r2)1:n ≤ … ≤(r2)n:n to reszty uporządkowane kwadratowo ri2(θ)={yi-η(xi,θ)}2, yi reprezentuje zmienną zależną, xi=(xi1,…,xik) niezależny wektor wejściowy, a θ ∈ Rp oznacza wektor parametrów bazowych dla ogólnego modelu regresji nieliniowej. Stała przycinania h musi być wybrana jako n/2<
Wyprowadzenie algorytmu LTS
Dla uproszczenia rozważmy prostą, trójwarstwową sieć neuronową z jedną warstwą ukrytą. Sieć jest trenowana na zestawie n par treningowych:
{(x1, t1),(x2, t2),…,(xn, tn)},
gdzie xi ∈Rp i ti ∈ Rq.Dla danego wektora wejściowego xi=(xi1,xi2,…,xip)T, wyjście j-tego neuronuwarstwy ukrytej można uzyskać jako:

gdzie f1(⋅) jest funkcją aktywacji warstwy ukrytej, wjk jest wagą między k-tym wejściem netto a j-tym neuronem, a bj jest odchyleniem j-tego neuronu. Wówczas wektor wyjściowy sieci yi=(yi1,yi2,…,yiq)T jest podany jako:

Tutaj f2(⋅) oznacza funkcję aktywacji, w′vj jest wagą między v-tym neuronem warstwy wyjściowej a j-tym neuronem warstwy ukrytej, a b′v jest obciążeniem v-tego neuronu warstwy wyjściowej. Teraz wprowadzamy odporne kryterium błędu LTS, oparte na estymatorze najmniejszych przyciętych kwadratów. Nowa funkcja błędu jest zdefiniowana jako:

W tym przypadku (r2)1:n≤ … ≤(r2)n:n są uporządkowanymi kwadratowymi resztami postaci

Stała przycinania h musi być starannie dobrana, ponieważ odpowiada za liczbę wzorców podejrzewanych o bycie wartościami odstającymi. Dla uproszczenia zakładamy, że wagi są aktualizowane zgodnie z algorytmem uczenia się metodą gradientu zstępującego, ale można to rozszerzyć na dowolny inny algorytm oparty na gradiencie. Następnie do każdej wagi dodawany jest (? oznacza współczynnik uczenia):


gdzie

oraz

Głównym problemem, który może wystąpić, jest obliczenie pochodnej ELTS. Nie jest ona ciągła i można ją zapisać jako:

Jak wykazano eksperymentalnie, taki kształt funkcji pochodnej jest wystarczająco gładki dla algorytmu uczenia się BP. W przypadku stosowania odpornych algorytmów uczenia się istnieją pewne problemy, dotyczące głównie wyboru punktu wyjścia dla metody. W rzeczywistości możemy podzielić to na dwa zadania: wybór początkowych parametrów sieci i wybór odpowiedniego estymatora skali. Jeśli początkowe wagi sieci nie zostaną odpowiednio dobrane, proces uczenia może przebiegać w niewłaściwym kierunku, a algorytm może ułożyć się w lokalnym minimum. W takim przypadku wydajność sieci może stać się bardzo słaba. Estymator skali lub jego odpowiednik (w tym przypadku stała przycinania h) odpowiada za liczbę wartości odstających, które mają zostać odrzucone podczas uczenia. Jest zatem oczywiste, że jeśli h jest niepoprawne, błędy grube mogą zostać uznane za dobre dane, a pożądane punkty mogą zostać rozróżnione. Zgodnie z (Chen i Jain, 1994), zdecydowaliśmy się użyć naszego odpornego algorytmu LTS po okresie uczenia tradycyjnym algorytmem BP do ustawienia parametrów początkowych. Zaproponowaliśmy dwie strategie wyboru parametru przycinania h. W pierwszym podejściu założyliśmy predefiniowaną wartość h, zależną od oczekiwanego odsetka wartości odstających w danych treningowych (LTS1). W tym przypadku potrzebna jest dodatkowa wiedza a priori na temat rozkładu błędów, więc strategia ta nie jest zbyt użyteczna. Drugie podejście (LTS2) polega na wyborze h poprzez użycie mediany wszystkich błędów, jako:
h=|{ri:|ri|< c*median(|ri|), i=1…n}|, (11)
gdzie c=1,483 dla oszacowania skali MAD (Huber, 1981). Błędy użyte do obliczenia h to błędy uzyskane po ostatniej epoce tradycyjnego algorytmu propagacji wstecznej, więc wartość h jest stała dla procesu uczenia.
Wyniki symulacji
Algorytm uczenia LTS został przetestowany w zadaniach aproksymacji funkcji. W niniejszym artykule przedstawiamy tylko kilka z wielu różnych sytuacji testowych. Pierwszą aproksymowaną funkcją jest y=x-2/3 zaproponowana przez Chena i Jaina (1994), drugą jest dwuwymiarowa spirala opisana jako x=siny, z=cosy. Do symulacji rzeczywistych danych zawierających szum i wartości odstające zastosowaliśmy różne modele, zdefiniowane w następujący sposób:
o Dane czyste, bez szumu i wartości odstających;
o Dane zniekształcone za pomocą modelu błędu grubego: F=(1-δ)G+δH, gdzie F to rozkład błędu, G ∿N(0,0;0,1) i H∿N(0,0;10,0) to szum Gaussa i wartości odstające, występujące z prawdopodobieństwem 1-δ i δ (typ danych 1);
o Dane z losowymi wartościami odstającymi o wysokiej wartości (Typ 2), zaproponowane w postaci F=(1-δ)G+δ(H1+H2+H3+H4), gdzie H1∿N(15,2), H2∿N(-20,3), H3 ∿N(30,1,5), H4 ∿N(-12,4).
o Dane z wartościami odstającymi wygenerowane z modelu błędu grubego, wstrzyknięte do wektora wejściowego xi (Typ 3).
Porównano wydajność tradycyjnego algorytmu propagacji wstecznej (BP), odpornego algorytmu LMLS oraz obu wariantów nowego odpornego algorytmu LTS, LTS1 i LTS2. Patrząc na Tabelę , widać, że dla czystych danych pierwszego zadania wszystkie algorytmy działają stosunkowo dobrze.

W przypadku danych zawierających błędy grube, dwie odmiany algorytmu LTS zapewniają najlepszą wydajność i trudno powiedzieć, która z nich jest lepsza. W przypadku danych z wartościami odstającymi o wysokiej wartości tylko LTS2 i LMLS zapewniają dobre dopasowanie do danych testowych, podczas gdy LTS1, choć nadal lepszy niż algorytm BP, działa raczej słabo. W przypadku danych zawierających wartości odstające wprowadzone do danych wejściowych, algorytmy LTS1 i LTS2 wykazały się najlepszą wydajnością, a błąd LTS1 jest nawet o ponad 25% lepszy niż w przypadku LMLS i BP. Wyniki uzyskane dla drugiego zadania aproksymacji są generalnie podobne. W przypadku danych zawierających wartości odstające, przewaga algorytmu LTS jest wyraźnie widoczna. LTS2 działa dobrze również w przypadku wartości odstających o wysokiej wartości, wykazując najniższy błąd. Ponadto, w przypadku błędów grubych w wektorze wejściowym, algorytmy LTS1 i LTS2 wydają się być najlepsze. Podsumowując, można zauważyć, że oba algorytmy LTS wykazały
lepszą wydajność niż dwa pozostałe algorytmy, zarówno dla danych zawierających błędy grube na wejściu, jak i w wektorze wyjściowym.
PRZYSZŁE TRENDY
Potencjalnie, algorytmy uczenia odpornego, oparte na zmodyfikowanej funkcji błędu, mogą być projektowane również do trenowania innych typów struktur NN, takich jak sieci rekurencyjne lub samoorganizujące się. Co więcej, dla sieci FFN istnieje wiele technik (adaptacyjne tempo uczenia, funkcje przejścia itp.), które można wykorzystać, aby uczynić ich proces uczenia bardziej odpornym na obserwacje odstające.
WNIOSKI
W niniejszym artykule zaproponowano nowy algorytm uczenia odpornego LTS. Jak wykazano eksperymentalnie, zachowuje się on lepiej niż algorytm tradycyjny i odporny algorytm LMLS w obecności obserwacje odstające w danych treningowych. Co więcej, jest to jednocześnie pierwszy algorytm uczenia odpornego, który uwzględnia również błędy grube wprowadzone do wektora wejściowego wzorców treningowych (punkty dźwigni). Szczególnie w jego drugiej wersji (LTS2), z błędem mediany używanym do ustawienia stałej przycinania h, można go uznać za prosty i skuteczny sposób na zwiększenie wydajności uczenia na zanieczyszczonych zbiorach danych. Nie wymaga on żadnej dodatkowej wiedzy a priori o założonym rozkładzie błędów, aby zapewnić względnie dobre wyniki treningu w każdych warunkach. Wytrzymały algorytm uczenia LTS można łatwo dostosować do wielu rodzajów strategii uczenia sieci neuronowych.
Symulacje statystyczne sumatorów perceptronowych
WSTĘP
W niniejszym artykule porównujemy szereg ogniw z pełnym sumatorem (sumator 1-bitowy) pod względem minimalnego napięcia zasilania i wydajności, uwzględniając symulacje statystyczne. Zgodnie z mapą drogową ITRS, dwa z najważniejszych wyzwań dla przyszłego projektowania nanoelektroniki to zmniejszenie zużycia energii i zwiększenie produktywności (ITRS, 2005). Wykorzystujemy podprogową technologię CMOS, uważaną przez wielu za najbardziej obiecującą technikę układów o ultraniskim poborze mocy. Wykazano również, że minimalny współczynnik redundancji na poziomie zaledwie 2 wystarcza, aby układy zachowały pełną funkcjonalność w przypadku występowania defektów. Jest to, według naszej wiedzy, najniższy współczynnik redundancji odnotowany dla porównywalnych układów i opiera się na metodzie zaproponowanej kilka lat temu (Aunet i Hartmann, 2003). Standardowy układ pełnego sumatora (FA) i układ FA oparty na perceptronach wykorzystujący "bramkę lustrzaną", zaimplementowany w standardowej technologii CMOS 90 nm, nie wytrzymują niedopasowania statystycznego i zmian procesu dla napięć zasilania poniżej 150 mV. Wykorzystanie schematu redundancji tolerującego zwarcia "otwarte", z redundancją na poziomie bramki i zwartymi wyjściami, pokazuje, że te same dwa układy FA mogą generować wystarczające sygnały sumy i przeniesienia przy obecności uszkodzonego PMOS dla napięć zasilania powyżej 150 mV, przy współczynniku redundancji 2 (Aunet i Otnes Berge, 2007). Dwa dodatkowe perceptrony nie tolerują zmian procesu, zgodnie z symulacjami. Symulacje sugerują, że standardowy układ FA ma najniższe zużycie energii. Zużycie energii zmienia się o ponad rząd wielkości dla wszystkich podprogowych układów FA ze względu na zmiany statystyczne.
TŁO
Pierwszy prosty model matematyczny neuronów biologicznych, opublikowany przez McCullocha i Pittsa w 1943 roku, oblicza znak ważonej sumy sygnałów wejściowych. Czasami takie układy nazywane są progowymi bramkami logicznymi lub elementami progowymi. Perceptrony mogą być wykorzystywane do implementacji sieci neuronowych, a także cyfrowego przetwarzania sygnałów. Oczekuje się, że technologia CMOS w skali nano będzie wykorzystywanawraz z innymi technologiami w przyszłości. Typowy układ scalony ulegnie awarii, jeśli choćby jeden tranzystor lub przewód na układzie będzie uszkodzony. Zmniejszenie zużycia energii i stworzenie układów odpornych na defekty zostały wskazane jako istotne kwestie (Mead, 1990), (ITRS, 2005). Obniżenie napięcia zasilania jest najbardziej bezpośrednim i spektakularnym sposobem redukcji zużycia energii a obwody podprogowe pracujące z napięciem zasilania Vdd mniejszym od wartości bezwzględnej napięć progowych Vt są znane od dziesięcioleci. W przypadku starszych technologii, w których możliwości produkcyjne, w tym zmienność napięcia progowego, nie stanowiły tak istotnego problemu (ITRS 2005) , minimalne napięcia zasilania często szacowano bez uwzględniania niedopasowania i zmian procesu . Aby uzyskać bardziej realistyczne szacunki, przeprowadziliśmy symulację i porównaliśmy 4 różne topologie dodawania 1-bitowego przy statystycznych zmianach w procesie i właściwościach dopasowania.
GŁÓWNY TEMAT
Tranzystory MOS w stanie podprogowym
Dla tranzystora NMOS w stanie podprogowym mamy :

Ids,n wyraża prąd z drenu do źródła. I0 to prąd polaryzacji zerowej, gdzie stałe prewykładnicze zostały zaabsorbowane. Obejmuje to szerokość kanału ("W") i długość ("L") struktury MOSFET. Vgs to potencjał bramka-źródło, Vds to potencjał dren-źródło, a Vbs to potencjał podłoże-źródło. V0 to napięcie wczesne, które jest proporcjonalne do długości kanału. ? określa skuteczność, z jaką potencjał bramki kontroluje prąd kanału. Często wynosi ona około 0,7-0,75 . Napięcie termiczne wyraża się wzorem Vt=kT/q. Vt = 25,8 mV w temperaturze pokojowej. Chociaż równanie (1) uwzględnia mniej efektów fizycznych i niemonotonicznych zachowań w pewnych przypadkach niż na przykład podane w (Calhoun, Wang i Chandrakasan, 2004), dostarcza ono wystarczających informacji, aby przeprowadzić krótką analizę wielu obwodów podprogowych. Podobne równanie ma zastosowanie do tranzystorów PMOS, ale z przeciwną polaryzacją.
Układ eksperymentalny do symulacji statystycznych funkcjonalności i poboru mocy sumatorów 1-bitowych
Do symulacji statystycznych (Monte Carlo) wykorzystaliśmy standardowy proces CMOS 90 nm dostępny w CMP (CMP, 2007). Symulowano cztery różne obwody pełnego sumatora ("FA"), których wejścia sterowane były przez inwertery, a same układy sterowały prostymi inwerterami. Ilustruje to rysunek 1.

W przypadku braku redundancji i usterek, dolna wartość FA z rysunku (1) nie została uwzględniona. Dla każdego obwodu, przy 8 różnych napięciach zasilania, wykonano 100 "przebiegów" Monte Carlo, każdy z ośmioma możliwymi kombinacjami trzech wejść, przez całkowity okres symulacji (symulacja przejściowa) 400 μs, jak pokazano na rysunku 3 dla przypadku po 5 "przebiegach".

Było to dalekie od maksymalnej prędkości operacyjnej któregokolwiek z FA, co oznaczało, że wynikowe sygnały sumy i przeniesienia miały więcej niż wystarczająco czasu na ustabilizowanie się. Każdy ze 100 przebiegów reprezentował inną niedopasowanie i parametry procesu, a dla każdego przebiegu sprawdzaliśmy, czy układ był w stanie wygenerować poprawne wyjścia "0" lub "1" dla wszystkich ośmiu kombinacji wejściowych. Wydajność, pokazana na rysunku 4, przedstawia procent pełnych sumatorów (FA) pracujących dla danego napięcia zasilania, spośród 100 "przebiegów" Monte Carlo.

Wykorzystano redundancję z wykorzystaniem zwartych węzłów sterowanych , duplikując każdą bramkę dla trzech FA w oparciu o bramki progowe (rysunek 2).

W przypadku pozostałych FA zwarte były tylko węzły sterowane przed inwerterami poprzedzającymi węzły S i C. Z 4 bramek progowych usunięto łącznie 4 tranzystory PMOS (po jednym dla każdej bramki), tak że każda bramka progowa nie posiadała jednego tranzystora PMOS. Oznacza to, że każda bramka progowa na rysunku 1 miała dokładnie (2N - 1) liczbę tranzystorów N w porównaniu z poprzednim przypadkiem bez redundancji. Obliczono również średnie zużycie energii dla ośmiu kombinacji wejściowych. Każdy z czterech perceptronów obwodów, bez redundancji, został przetestowany dla 8 różnych napięć zasilania. Brakujący tranzystor znajdował się w najniższej bramce "min3" (rysunek 2). W przypadku bramki lustrzanej brakujący tranzystor PMOS to ten z wejściem Z. Zarówno w przypadku bramki piętrowej, jak i bramki iJCNN brakujący tranzystor PMOS znajdował się pomiędzy dwoma pozostałymi tranzystorami PMOS, jak pokazano na rysunku 2. W przypadku bramki FA w lewym górnym rogu rysunku 2 usunięto tranzystor PMOS z bramką podłączoną do wejścia Cin. Reszta konfiguracji była identyczna z tą opisaną w poprzednim podrozdziale, bez zbędnych powtórzeń.Testowanym układem FA był standardowy sumator CMOS Full Adder zawierający 28 tranzystorów (górny, lewy, na rysunku 2), podczas gdy trzy pozostałe opierały się na topologii z prawego górnego rogu rysunku 2. Bazowały one, od lewej do prawej na rysunku 2, na bramce "lustrzanej" , bramce "warstwowej" oraz bramce "ijcnn" , które są bramkami progowymi. Jeśli chodzi o wymiary tranzystorów, długość wszystkich bramek wynosiła 100 nm, a szerokość wszystkich tranzystorów NMOS wynosiła 220 nm. Standardowy układ FA i układ FA "stacked" miały szerokości wszystkich PMOS równe 400 nm, podczas gdy układ FA "ijcnn" i układ FA "mirrored" miały szerokości PMOS odpowiednio 550 nm i 650 nm. Bufory, wykonane z dwóch inwerterów, zostały umieszczone na węzłach sumy, a także pomiędzy dwiema najwyższymi bramkami progowymi ("min3") na rysunku 2.
Wyniki
Procent układów FA, które wygenerowały poprawne poziomy logiczne dla sygnałów sumy i przeniesienia, w różnych warunkach, przedstawiono na rysunku 4. Jest oczywiste, że standardowy układ FA CMOS i układ oparty na bramce lustrzanej dają większy procent dla danego napięcia zasilania w porównaniu z układami FA opartymi na dwóch pozostałych bramkach progowych. Pobór mocy w funkcji napięcia zasilania przedstawiono na rysunku 5 dla podstawowych układów bez uszkodzonych tranzystorów ani redundancji.
DYSKUSJA
Standardowy układ Full Adder oraz topologia oparta na bramce progowej (prawy górny róg na rysunku 2) wykorzystująca bramkę lustrzaną wymagają napięcia zasilania co najmniej 150 mV, aby tolerować niedopasowanie i zmiany w procesie, zgodnie z naszymi symulacjami. Widać to po lewej stronie na rysunku 4. Bramki progowe "ijcnn" i "stacked" nie tolerują zmian statystycznych, tak jak dwa wcześniej wspomniane rozwiązania, przynajmniej nie w przypadku braku redundancji i użycia stosunkowo małych tranzystorów. Większe tranzystory powinny poprawić właściwości dopasowania i zmniejszyć podatność układów na zmiany statystyczne w produkcji, ponieważ rozrzut na przykład napięć progowych jest odwrotnie proporcjonalny do pierwiastka kwadratowego iloczynu szerokości i długości tranzystorów MOSFET: b(VT) = A0(VT) / Sqrt(WL). Bramka progowa zwierciadlana została przyjęta do pracy podprogowej i tolerancji defektów/błędów przy użyciu zwartych wyjść i przeszła symulacje statystyczne, jak tutaj, w (Granhaug & Aunet, 2006). Następnie uzyskano współczynnik redundancji równy 2 w połączeniu z napięciem zasilania minimum 175 mV, jeśli pojedynczy defekt PMOS miał być tolerowany. W (Granhaug & Aunet, 2006) rozmiary tranzystorów były nieco inne, a studnie zarówno tranzystorów PMOS, jak i NMOS były zwarte, w przeciwieństwie do naszego przypadku, gdzie studnie były podłączone do szyn. W przypadku systemów o znacznych rozmiarach, zaimplementowanych w krzemie, najniższe napięcie zasilania może wynosić 175 mV, jak podano w (Miyazaki, Kao & Chandrakasan, 2002). Wykorzystanie redundancji, duplikacja każdej bramki i wyrwanie jednego tranzystora PMOSz każdego z czterech sumatorów pełnych dało wyniki pokazane po prawej stronie na rysunku 4. Rysunek przypomina przypadek po lewej, bez redundancji, ale z pewnymi różnicami. Minimalne napięcie Vdd potrzebne do wykonania standardowego FA i oparte na lustrzanej funkcji bramki dla wszystkich 100 przebiegów Monte Carlo wynosiło nadal 150 mV. Jest to niższe napięcie zasilania niż 175 mV uzyskane w (Granhaug i Aunet, 2006). Rozmiar tranzystora, a także polaryzacja studni, mogą mieć znaczący wpływ na wyniki, szczególnie w zakresie podprogowym, z wieloma zależnościami wykładniczymi, jak pokazano w równaniu 1. Z rysunku 4 można również zauważyć, że algorytmy FA oparte na bramkach "lustrzanych" i "ijcnn" często charakteryzują się wyższą wydajnością dla danego napięcia zasilania po wprowadzeniu redundancji i uszkodzonego tranzystora, w porównaniu z przypadkiem bez redundancji i jakiegokolwiek defektu. Algorytm FA oparty na bramce "lustrzanej" był najbardziej odporny w przypadku uszkodzonego tranzystora, dając najwyższą wydajność dla niskich napięć zasilania, zgodnie z symulacjami przedstawionymi na rysunku 4. Więcej symulacji, uwzględniających inne defekty i dodatkową redundancję, mogłoby być interesujących dla przyszłych badań. Usunięcie pojedynczych tranzystorów symuluje pewne "otwarte" awarie w redundantnych jednostkach, a schemat wykorzystujący zwarte wyjścia , stosowany na przykład w (Beiu, Aunet, Nyathi, Rydberg i Djupdal, 2005), może nie wytrzymać "zamkniętych" awarii, takich jak zwarcie wyjść redundantnych jednostek z jedną z szyn zasilania. Metodę tolerującą takie defekty przedstawiono również w (Schmid i Leblebici, 2003). Żadna pojedyncza technika nie jest wystarczająca do tolerowania wszystkich mechanizmów błędów w obwodach i systemach nanoskalowych, jak stwierdzono w (Lehtonen, Plosila i Isoaho, 2005), dlatego konieczne jest zastosowanie kombinacji kilku metod, w zależności od konkretnej konstrukcji i podatności na różne źródła defektów . Średnie, maksymalne i minimalne zużycie energii w przypadkach, w których układy FA były w stanie wytworzyć poprawne wyjścia logiczne, przedstawiono na rysunku 5.

Standardowy układ FA CMOS wykazuje najniższe średnie zużycie energii, gdy napięcie zasilania przekracza 150 mV, czyli gdy dwa układy FA dają "wydajność" 100 procent, zgodnie z naszymi wynikami. Układ FA oparty na bramce "lustrzanej" wykazuje nieco wyższe zużycie energii, podczas gdy układ FA oparty na bramce "ijcnn" wykazuje zużycie energii nawet o rzędy wielkości wyższe od pozostałych, a coraz bardziej w przypadku relatywnie wyższych napięć zasilania. Nawet układy FA wykazujące stosunkowo wysoką tolerancję na niedopasowanie i zmiany procesu mają poziomy prądu wahające się ponad rząd wielkości, czyli 10-krotnie, dla danego napięcia zasilania. Oczekuje się, że pobór mocy dla danego napięcia zasilania będzie liniowo wzrastał wraz ze współczynnikiem redundancji. Realizm symulacji jest ograniczony, szczególnie w przypadku układów CMOS w skali nano . Zatem techniki układu mające na celu zapewnienie wysokiego dopasowania, w tym struktury pozorne, mogą prowadzić do innych wyników niż te przedstawione tutaj.
PRZYSZŁE TRENDY
Założenie, że system składa się głównie z prawidłowo funkcjonujących jednostek, nie jest już prawdziwe w rozwijającej się nanoelektronice, a zmniejszenie całkowitego zużycia energii jest również jednym z głównych wyzwań dla przyszłej nanoelektroniki. Perceptrony o niskim oporze wejściowym, zwane również bramkami głosującymi lub bramkami mniejszościowymi, mogą być bardzo użytecznymi kandydatami dla przyszłej nanoelektroniki, co zostało niedawno stwierdzone . Odporne na defekty obwody perceptronów podprogowych wykorzystujące bramki większościowe, jak przedstawiono w niniejszym artykule, mogą zatem być użytecznymi elementami składowymi na przyszłość.
WNIOSKI
Przeprowadzono statystyczne symulacje Monte Carlo na 4 układach sumatora pełnego. Dla każdego układu sumatora pełnego wykonano 100 przebiegów Monte Carlo przy 8 różnych napięciach zasilania podprogowego, a następnie obliczono odsetek przebiegów zapewniających odpowiednie poziomy logiczne dla wyjść sumy i przeniesienia. "Wydajność" 100% oznaczała, że dany układ FA tolerowałby wszystkie symulowane kombinacje odchyleń statystycznych. Układy zdolne do osiągnięcia tego limitu to standardowy układ FA i układ FA oparty na "lustrzanej" bramce progowej, oba wymagające napięcia zasilania, Vdd, powyżej co najmniej 150 mV, aby zagwarantować funkcjonalność w warunkach niedopasowania i zmian procesu. W przypadku wykorzystywania redundancji i zwarć na wyjściach , napięcie zasilania poniżej 150 mV nie wystarcza do tolerowania odchyleń statystycznych po usunięciu PMOS ze schematu i zastosowaniu współczynnika redundancji równego 2. Standardowe i lustrzane układy FA nadal działają przy napięciu zasilania powyżej 150 mV dla jednego uszkodzonego tranzystora MOSFET. Pobór mocy zmienia się o około rząd wielkości dla wszystkich 4 symulowanych układów FA w zakresie podprogowym, przy czym standardowy układ FA ma najniższe zużycie mocy przy użytecznych napięciach zasilania tolerujących duże odchylenia statystyczne.
Stacjonarna gęstość stochastycznych procesów przeszukiwania
WSTĘP
Optymalizacja funkcji kosztu, która ma szereg minimów lokalnych, jest istotnym tematem w wielu ważnych dziedzinach. Na przykład, wyznaczanie wag maszyn uczących się zależy generalnie od rozwiązania zadań optymalizacji globalnej . Cechą wspólną niemal wszystkich najpopularniejszych deterministycznych i stochastycznych algorytmów ciągłej optymalizacji nieliniowej jest to, że ich wydajność jest silnie uzależniona od warunków początkowych. W zależności od algorytmu, prawidłowy wybór punktu początkowego lub zbioru punktów ma bezpośredni wpływ na wydajność, a nawet na możliwość znalezienia minimów globalnych. Oczywiście, odpowiedni wybór ziaren implikuje wcześniejszą wiedzę na temat struktury zadania optymalizacji. W przypadku braku informacji a priori, naturalnym wyborem jest pobranie ziaren z jednorodnej gęstości zdefiniowanej w przestrzeni przeszukiwania. Wiedzę na ten temat można uzyskać poprzez eksplorację tej przestrzeni. W niniejszym artykule przedstawiono metodę szacowania gęstości prawdopodobieństwa opisującą asymptotyczne zachowanie ogólnych stochastycznych procesów przeszukiwania w ciągle różniczkowalnych funkcjach kosztu. Znaczenie takich gęstości polega na tym, że opisują one czasy przebywania w różnych obszarach przestrzeni poszukiwań po nieskończenie długiej eksploracji. Preferowane obszary to te, które minimalizują koszt globalnie, co znajduje odzwierciedlenie w gęstościach asymptotycznych. Po pierwsze, uzyskane gęstości można wykorzystać do narysowania populacji punktów zgodnych z globalnymi właściwościami powiązanych zadań optymalizacyjnych.
TŁO
Stochastyczne strategie optymalizacji są niezbędne dla większości technik heurystycznych stosowanych w rozwiązywaniu złożonych, niestrukturalnych problemów optymalizacji globalnej . Korzenie takich metod sięgają algorytmu Metropolisa , wprowadzonego na początku ery informatyki naukowej w celu symulacji ewolucji układu fizycznego do równowagi termicznej. Proces ten stanowi podstawę techniki symulowanego wyżarzania (Kirkpatrick, Gellat i Vecchi, 1983), która wykorzystuje zbieżność do globalnego minimum energii konfiguracyjnej obserwowanej w układach fizycznych w stanie równowagi termicznej, gdy temperatura spada do zera. Metoda przedstawiona w niniejszym artykule opiera się na podobnych zasadach fizycznych, na których oparte są algorytmy symulowanego wyżarzania. Jednakże, w przeciwieństwie do innych podejść , proponowana metoda uwzględnia gęstość punktów zamiast przejść Markowa poszczególnych punktów. Technika ta opiera się na wzajemnym oddziaływaniu modeli Langevina i Fokkera-Plancka dla procesów stochastycznych, co jest dobrze znane w badaniach układów fizycznych poza równowagą. Równanie Fokkera-Plancka zostało już zaproponowane do zastosowania w algorytmach przeszukiwania w kilku kontekstach. Na przykład, zostało wykorzystane do bezpośredniego badania zbieżności populacji punktów do minimów globalnych , jako narzędzie do demonstracji zbieżności algorytmów symulowanego wyżarzania lub jako teoretyczne ramy dla maszyn uczących się typu Boltzmanna . W kontekście optymalizacji globalnej za pomocą populacji punktów zaproponowano, że populacje ewoluują zgodnie z zależną od czasu wersją równania Fokkera-Plancka, zgodnie z harmonogramem redukcji stałej dyfuzji D . W naszym podejściu stacjonarna wersja równania Fokkera-Plancka jest wykorzystywana do poznania długoterminowej gęstości prawdopodobieństwa ogólnego stochastycznego procesu poszukiwań. Osiąga się to za pomocą operacji liniowych i stosunkowo niewielkiej liczby ewaluacji danej funkcji kosztu.
STACJONARNY ALGORYTM SZACOWANIA GĘSTOŚCI
Rozważmy minimalizację funkcji kosztu postaci V(x1, x2, …, xn, ...… xN) z przestrzenią poszukiwań zdefiniowaną na L1,n ≤ xn ≤ L2,n. Stochastyczny proces poszukiwań dla tego problemu jest modelowany przez

gdzie e(t) jest szumem addytywnym o zerowej średniej. Równanie (1), znane jako równanie Langevina w literaturze fizyki statystycznej, oddaje podstawowe właściwości ogólnej stochastycznej strategii poszukiwań. W przypadku nieskorelowanego szumu gaussowskiego o stałej sile, równanie (1) reprezentuje poszukiwanie przez dyfuzję, podczas gdy siła szumu, która powoli zmienia się w czasie, daje symulowany proces wyżarzania. Zauważ, że wybierając szum zewnętrzny o nieskończonej amplitudzie, traci się dynamiczny wpływ funkcji kosztu na proces eksploracji, co prowadzi do ślepego poszukiwania. Model podany w równaniu (1) można interpretować jako nieliniowy układ dynamiczny złożony z N oddziałujących cząstek. Ewolucję czasową gęstości prawdopodobieństwa takiego układu opisuje liniowe równanie różniczkowe, równanie Fokkera-Plancka ,

Podejście zaproponowane w tym artykule opiera się na pojęciu nieskończenie długiej eksploracji przestrzeni poszukiwań. W obecnej konfiguracji modelu dla poszukiwania proces zbiega do stanu opisanego przez stacjonarne rozwiązanie równania (2) . Postać tegorozwiązania jest dobrze znanego typu Boltzmanna . W celach optymalizacji lub generowania odchyleń, jego bezpośrednie użycie oznaczałoby wysoki koszt obliczeniowy. Zamiast tego, zaproponowano formę próbkowania Gibbsa w celu oszacowania brzeżnej gęstości prawdopodobieństwa p(xn) (szczegóły poniższej dyskusji można znaleźć w (Berrones, 2007)). Jednowymiarowa projekcja równania (2) w chwili t ->∞ prowadzi do następującego równania warunkowego rozkładu skumulowanego: y(xn | {xjj ≠ xn})

Zatem oszacowanie postaci analitycznej y(xn | {xjj ≠ xn}) można uzyskać przez podstawienie rozwinięcia

do równania (3). Uzyskany w ten sposób rozkład można wykorzystać do wyciągnięcia punktów z warunkowej gęstości p(xn | {xjj ≠ xn}). Zgodnie z zasadami próbkowania Gibbsa (Geman i Geman, 1984), iteracja poprzednich kroków dla N zmiennych wytworzy populację próbkowaną z odpowiadających im gęstości brzegowych p(xn). Jednak w naszym rozwiązaniu wszystkie informacje potrzebne do scharakteryzowania gęstości są zawarte we współczynnikach rozwinięcia (4). W ten sposób stacjonarne gęstości brzegowe powiązane z N zmiennymi problemu optymalizacji są uczone poprzez uśrednianie współczynników w iteracji procesu generowania odchylenia losowego. Tę podstawową procedurę nazywamy algorytmem estymacji gęstości stacjonarnej (SDEA). Metodę nazwaliśmy również stacjonarną maszyną Fokkera-Plancka (SFPM) w (Berrones, 2007), aby wskazać jej związek z innymi metodami (Suykens, Verrelst i Vandewalle, 1998), które wykorzystują równanie Fokkera-Plancka do uczenia się cech statystycznych
stochastycznych procesów poszukiwań. Jednak w (Suykens, Verrelst i Vandewalle, 1998) równanie Fokkera-Plancka jest wykorzystywane do badania ewolucji skończonych populacji punktów ze stanów poza równowagą. Kontrastuje to z naszym podejściem, które polega na szacowaniu gęstości równowagowych w całej przestrzeni poszukiwań. Na przykład algorytm SFPM jest testowany na funkcji Levy′ego nr 5, ważnym problemie porównawczym z około 760 lokalnymi minimami i jednym globalnym optimum (Parsopoulos i Vrahatis, 2002),

z przestrzenią poszukiwań daną przez hipersześcian [-10, 10]. Bezpośrednia implementacja stochastycznego przeszukiwania poprzez równanie (1) implikowałaby symulację stochastycznego układu dynamicznego złożonego z dwóch cząstek o silnie nieliniowych oddziaływaniach. Natomiast dzięki naszej metodologii jesteśmy w stanie uzyskać odpowiednie gęstości poprzez operacje liniowe i wykonanie umiarkowanej liczby ocen funkcji kosztu. Na rysunku. 1 przedstawiono gęstości wygenerowane przez 10 iteracji algorytmu estymacji z parametrami L=50 i D=200.

Uzyskane gęstości są idealnie zgodne z globalnymi właściwościami problemu, ponieważ znane globalne optimum w punkcie (-1,3068, -1,4248) znajduje się w obszarach o najwyższym prawdopodobieństwie. Nakład obliczeniowy jest niski w sensie wymaganej liczby ocen funkcji kosztu, danej przez 2(L-1)MN=1960. Jest to porównywalne z wysiłkiem wymaganym przez zaawansowane techniki oparte na populacjach w celu uzyskania rozwiązań dobrej jakości dla tego samego problemu . Nasze podejście nie ogranicza się jednak do zbieżności do dobrych rozwiązań, ale szacuje całkowite gęstości. Implikacje tego, na przykład w definiowaniu probabilistycznych kryteriów optymalności, są obecnie przedmiotem naszych badań.
TRENDY NA PRZYSZŁOŚĆ
Naszym zdaniem teoria i wyniki przedstawione do tej pory mają potencjał znacznego wzbogacenia narzędzi optymalizacji globalnej. Charakterystyka problemów optymalizacyjnych w kategoriach wiarygodnych gęstości prawdopodobieństwa może otworzyć drogę do nowych spostrzeżeń na temat optymalizacji globalnej poprzez wykorzystanie koncepcji probabilistycznych i informatyczno-teoretycznych. Z bardziej praktycznego punktu widzenia, proponowaną metodologię można wdrożyć na wiele sposobów w celu ulepszenia istniejących lub skonstruowania nowych algorytmów optymalizacji.
WNIOSKI
Niniejsza praca przedstawia metodologię estymacji funkcji gęstości prawdopodobieństwa problemów optymalizacyjnych z ciągłą różniczkowalną funkcją kosztu, przy użyciu operacji liniowych i umiarkowanej liczby ewaluacji funkcji kosztu. Uogólnienie na problemy z ograniczeniami wydaje się proste. Jest to oczekiwane, biorąc pod uwagę fakt, że proponowana metoda wykorzystuje wyłącznie operacje liniowe. W ten sposób ograniczenia mogą wchodzić do równania (1) jako dodatkowe człony nieliniowe, bez istotnego wzrostu kosztów obliczeniowych. Na przykład, kombinacje funkcji sigmoidalnych można wykorzystać do reprezentacji ograniczeń jako sił generowanych przez bariery energetyczne.
Stan wiedzy w zakresie rozpoznawania twarzy opartego na wideo
WSTĘP
W ciągu ostatnich kilku lat rozpoznawanie twarzy zyskało na popularności. Stało się popularnym obszarem badań w dziedzinie wizji komputerowej i rozpoznawania wzorców. Problem ten przyciąga badaczy z różnych dyscyplin, takich jak przetwarzanie obrazu, rozpoznawanie wzorców, sieci neuronowe, wizja komputerowa i grafika komputerowa . Rozpoznawanie twarzy jest typowym problemem wizji komputerowej. Celem wizji komputerowej jest zrozumienie obrazów scen, lokalizacja i identyfikacja obiektów, określenie ich struktury, układu przestrzennego i relacji z innymi obiektami . Głównym zadaniem rozpoznawania twarzy jest lokalizacja i identyfikacja osób na scenie. Rozpoznawanie twarzy jest również trudnym problemem rozpoznawania wzorców. Liczba próbek treningowych każdej klasy twarzy jest zazwyczaj tak mała, że trudno jest poznać rozkład każdej klasy. Ponadto różnice wewnątrzklasowe mogą być czasami większe niż różnice międzyklasowe ze względu na różnice w oświetleniu, pozie, wyrazie twarzy, wieku itp. Dostępność wykonalnych technologii otwiera wiele potencjalnych zastosowań dla rozpoznawania twarzy, takich jak identyfikacja twarzy, kontrola dostępu, bezpieczeństwo, nadzór, karty inteligentne, egzekwowanie prawa, bazy danych twarzy, zarządzanie multimediami, interakcja człowiek-komputer itp. . Tradycyjne rozpoznawanie twarzy oparte na nieruchomych obrazach odniosło duży sukces w ograniczonych środowiskach. Jednak gdy warunki (w tym oświetlenie, poza, wyraz twarzy, wiek) zmieniają się zbyt mocno, wydajność drastycznie spada. Niedawny test FRVT2002 (Face Recognition Vendor Test 2002) pokazuje, że wydajność rozpoznawania obrazów twarzy zarejestrowanych w środowisku zewnętrznym i w różne dni nadal nie jest satysfakcjonująca. Obecne algorytmy rozpoznawania twarzy oparte na nieruchomych obrazach są dalekie od możliwości ludzkiego systemu percepcyjnego). Z drugiej strony, badania psychologiczne i fizjologiczne wykazały, że ruch może pomóc ludziom w lepszym rozpoznawaniu twarzy . Torres (2004) zwrócił uwagę, że tradycyjne rozpoznawanie twarzy oparte na nieruchomych obrazach napotyka na duże wyzwania i trudności. Istnieją dwa potencjalne sposoby rozwiązania tego problemu: technologia rozpoznawania twarzy oparta na wideo i technologia identyfikacji multimodalnej. W ciągu ostatnich kilku lat wiele wysiłków badawczych koncentrowało się na rozpoznawaniu twarzy opartym na wideo. W porównaniu z rozpoznawaniem twarzy opartym na nieruchomych obrazach, prawdziwe algorytmy rozpoznawania twarzy oparte na wideo, wykorzystujące zarówno informacje przestrzenne, jak i czasowe, pojawiły się zaledwie kilka lat temu. Niniejszy artykuł przedstawia przegląd większości istniejących metod w dziedzinie rozpoznawania twarzy na podstawie wideo oraz analizę ich zalet i wad. Najpierw przedstawiono ogólne założenia dotyczące rozpoznawania twarzy. Następnie krótko omówiono większość istniejących metod rozpoznawania twarzy na podstawie wideo. Na koniec przedstawiono kilka przyszłych trendów i wniosków.
TŁO
Ogólnie rzecz biorąc, kompletny system rozpoznawania twarzy na podstawie wideo obejmuje moduł wykrywania twarzy, moduł śledzenia twarzy, moduł ekstrakcji cech oraz moduł rozpoznawania twarzy. Detekcja twarzy znajduje się na najniższej warstwie. Zadaniem detekcji twarzy jest określenie położenia przestrzennego i pozy twarzy (twarzy). Śledzenie twarzy znajduje się na środkowej warstwie. Śledzi ono ciągłą zmianę położenia twarzy w czasie. Ekstrakcja cech znajduje się na wyższej warstwie. Jego zadaniem jest zlokalizowanie położenia cech twarzy, takich jak oko, nos itp., i wydobycie powiązanych informacji. Moduł rozpoznawania twarzy znajduje się na najwyższej warstwie. Moduł rozpoznawania twarzy identyfikuje lub weryfikuje wprowadzone twarze za pomocą baz danych. Rysunek 1 przedstawia ogólne ramy systemu rozpoznawania twarzy opartego na wideo, wraz ze schematem blokowym i kilkoma przykładami.

W tym artykule skupimy się na najwyższej warstwie systemów rozpoznawania twarzy - module rozpoznawania twarzy. Ogólne zasady rozpoznawania twarzy można zdefiniować następująco: na podstawie nieruchomych lub wideo obrazów sceny, zidentyfikuj lub zweryfikuj jedną lub więcej osób na scenie za pomocą zapisanej bazy danych twarzy . Rozpoznawanie twarzy oparte na nieruchomych obrazach zazwyczaj odnosi się do procesu, w którym dane wejściowe stanowią nieruchome obrazy. Z drugiej strony, rozpoznawanie twarzy oparte na wideo często odnosi się do procesu, w którym dane wejściowe stanowią ujęcia wideo. Baza danych może również obejmować nieruchome obrazy lub wideo. Zatem, w zależności od różnych modalności danych wejściowych i bazy danych, można wyróżnić cztery różne scenariusze rozpoznawania twarzy. Tabela przedstawia te cztery różne scenariusze rozpoznawania twarzy.

Rozpoznawanie twarzy oparte na wideo zazwyczaj odnosi się zarówno do rozpoznawania twarzy typu "wideo - obraz(y)", jak i do rozpoznawania twarzy typu "wideo - wideo", czyli z danymi wejściowymi wideo. W porównaniu z rozpoznawaniem twarzy na podstawie nieruchomych obrazów, rozpoznawanie twarzy na podstawie wideo może wykorzystywać informacje czasowe i przestrzenne dostępne w materiale wideo. Powszechnie uważa się, że rozpoznawanie twarzy na podstawie wideo jest bardziej obiecujące niż rozpoznawanie twarzy na podstawie nieruchomych obrazów. Istnieją jednak również pewne trudności w rozpoznawaniu twarzy na podstawie wideo, takie jak obrazy twarzy o niskiej rozdzielczości, duże wahania skali, zmiany oświetlenia, zmiany w polu widzenia i sporadyczne przesłonięcie w materiale wideo. Warto zauważyć, że jeśli nie uwzględni się informacji czasowych z materiału wideo, rozpoznawanie twarzy na podstawie wideo staje się rozpoznawaniem twarzy na podstawie wielu nieruchomych obrazów.
ROZPOZNAWANIE TWARZY NA PODSTAWIE WIDEO
Zgodnie z klasyfikacją przedstawioną w Tabeli 1, cztery scenariusze rozpoznawania twarzy zostaną omówione oddzielnie. Nacisk zostanie położony na rozpoznawanie twarzy "Wideo - Obraz(y)" oraz rozpoznawanie twarzy "Wideo - Wideo". Dla uproszczenia zakłada się, że położenie twarzy na materiale wideo jest znane z góry. Rozpoznawanie twarzy metodą "obraz - obraz(y)" Rozpoznawanie twarzy metodą "obraz - obraz(y)" to tradycyjne rozpoznawanie twarzy oparte na nieruchomych obrazach. W ciągu ostatnich kilku dekad opracowano liczne metody rozpoznawania twarzy oparte na nieruchomych obrazach. Wśród nich, globalne metody dopasowywania cech, takie jak Eigenface , Fisherface i bayesowska ; oraz lokalne metody dopasowywania cech, takie jak Elastic Bunch Graph Matching (EBGM) , są powszechnie stosowanymi metodami rozpoznawania twarzy. Ostatnio do nowych metod należą modele deformowalne 3D oraz Lokalny Wzorzec Binarny (LBP) . Tradycyjne rozpoznawanie twarzy oparte na nieruchomym obrazie jest szeroko stosowane w uwierzytelnianiu biometrycznym, bezpieczeństwie informacji itp.
Rozpoznawanie twarzy "obraz - wideo"
Rozpoznawanie twarzy "obraz - wideo" polega na identyfikacji lub weryfikacji danej twarzy w zapisanych sekwencjach wideo. Rozpoznawanie twarzy "obraz - wideo" jest również nazywane wyszukiwaniem twarzy na podstawie obrazu. Typowe sceny obejmują wyszukiwanie podejrzanych na nagraniu z monitoringu lub wyszukiwanie osoby w filmie lub materiale informacyjnym na podstawie obrazu twarzy. Teoretycznie, system powinien najpierw przeprowadzić wstępne przetwarzanie wideo, takie jak ekstrakcja ujęć. Następnie przeprowadzane jest wykrywanie i śledzenie twarzy w celu uzyskania ujęcia wideo każdej twarzy. Rozpoznawanie twarzy jest przeprowadzane w ostatnim kroku. Ze względu na złożoność scen w takich filmach (film, wiadomości, nagrania z monitoringu), większość literatury koncentruje się na fazie wstępnego przetwarzania wideo . W ostatnich latach niektórzy naukowcy zastosowali model 3D do wyszukiwania osób w telewizji . Rozpoznawanie twarzy metodą "wideo - obraz(y)".Rozpoznawanie twarzy metodą "wideo - obraz(y)" można sformułować następująco: na podstawie ujęcia wideo zidentyfikuj lub zweryfikuj twarz w jego obrębie, korzystając z bazy danych nieruchomych obrazów. Wraz z upowszechnieniem się sprzętu do akwizycji wideo, istnieje wiele sekwencji wideo wykorzystywanych w aplikacjachuwierzytelniania bezpieczeństwa, monitoringu wideo itp. Jednocześnie większość istniejących baz danych to bazy nieruchomych obrazów. Dlatego też, w rzeczywistych zastosowaniach, istotne jest, jak lepiej wykorzystać wejściowy obraz wideo. Tradycyjne podejścia można z grubsza podzielić na dwie kategorie: pierwsza polega na śledzeniu twarzy, dopóki obraz twarzy nie spełni określonych reguł (takich jak rozmiar, pozycja). Następnie stosuje się tradycyjne metody rozpoznawania twarzy oparte na nieruchomych obrazach. Wadami takich podejść są trudności w zdefiniowaniu reguł i niepełne wykorzystanie wszystkich informacji zawartych w nagraniu wideo. Inną wadą jest przeprowadzenie rozpoznawania twarzy na podstawie nieruchomych obrazów dla każdej śledzonej twarzy i połączenie wyników rozpoznawania (z zastosowaniem reguł łączenia, na przykład maksymalnego skumulowanego prawdopodobieństwa lub głosowania większościowego). Wadą takich podejść jest losowość reguł łączenia. W ostatnich latach niektórzy badacze próbują wykorzystać informacje czasowe i przestrzenne w nagraniach wideo. Zhou i inni (2003) zaproponowali bayesowski model rozpoznawania i śledzenia twarzy oparty na schemacie, który próbuje rozwiązać niepewności związane ze śledzeniem i rozpoznawaniem jednocześnie. Do połączenia informacji czasowych wykorzystano model przestrzeni stanu szeregu czasowego, który charakteryzuje kinematykę za pomocą wektora ruchu i tożsamości za pomocą zmiennej tożsamości. Łączny rozkład a posteriori wektora ruchu i zmiennej tożsamości jest szacowany w każdej chwili, a następnie propagowany do następnej chwili. Marginalizacja na wektorze stanu daje solidne oszacowanie rozkładu a posteriori zmiennej tożsamości. Do oszacowania rozkładu a posteriori wykorzystano algorytm sekwencyjnego próbkowania ważności (SIS). SIS aproksymuje funkcję gęstości a posteriori za pomocą zestawu losowych cząstek z powiązanymi wagami. Wyniki eksperymentalne pokazują skuteczność algorytmu. Li i in. (2001, 2002) zastosowali śledzenie cech twarzy i śledzenie twarzy do weryfikacji. Podstawową ideą jest to, że jeśli dane wejściowe są prawdziwą twarzą (odpowiadającą tożsamości w bazie danych), trajektorie śledzenia cech twarzy lub wyglądu twarzy są zasadniczo takie same. Odpowiedni model matematyczny zakłada, że rozkład wektora ruchu będzie miał szczyt, gdy twarz jest prawdziwymi danymi wejściowymi. W przeciwnym razie dane wejściowe są oszustami. SIS jest również stosowany do a posteriori rozkładu prawdopodobieństwa zmiennych stanu. Jednak szacowana gęstość prawdopodobieństwa wymaga dużej liczby cząstek, aby scharakteryzować rozkład. W rezultacie wzrasta złożoność algorytmu.
Rozpoznawanie twarzy "Wideo - Wideo"
Rozpoznawanie twarzy "Wideo - Wideo" odnosi się do przypadków, w których zarówno dane wejściowe, jak i baza danych stanowią ujęcia wideo. W oparciu o wykorzystanie informacji zawartych w wideo, w istniejącej literaturze istnieją następujące metody opisu do reprezentacji ujęcia wideo:
1. Wektor (odpowiadający jednej klatce wideo).
2. Macierz (odpowiadająca wszystkim klatkom wideo).
3. Funkcja gęstości prawdopodobieństwa (PDF).
4. Model dynamiczny.
5. Rozmaitość.
W oparciu o powyższe metody opisu, rozpoznawanie twarzy "Wideo - Wideo" staje się dopasowaniem różnych metod opisu. Tabela 2 przedstawia wszystkie możliwe miary podobieństwa (odległości) między dwiema metodami opisu.

W tabeli 2 d oznacza odległość lub podobieństwo dwóch modeli. f(X) oznacza dodawanie prawdopodobieństwa, M(X) oznacza głosowanie większościowe, D(X) oznacza prawdopodobieństwo a posteriori. Poniżej pokrótce przedstawiono niektóre reprezentatywne metody rozpoznawania twarzy "Wideo - Wideo". Torres i inni (2002) stworzyli specyficzną dla danej osoby podprzestrzeń Analizy Głównych Składowych (PCA) dla każdej twarzy w bazie danych. Pozostała odległość między twarzą w jednej klatce a podprzestrzenią PCA jest używana jako miara podobieństwa do indeksowania wideo. McKenna i inni (1997) zastosowali model mieszanki gaussowskiej (GMM) w zredukowanej podprzestrzeni PCA do opisu każdej klasy twarzy. Obliczane jest prawdopodobieństwo a posteriori każdej twarzy w każdej klatce, a prawdopodobieństwo skumulowane jest używane jako miara podobieństwa. Yamaguchi i inni (1998) stworzyli podprzestrzeń PCA zarówno dla wideo wejściowego, jak i wideo z bazy danych. Odległość między dwiema podprzestrzeniami jest określana przez kąt między dwiema podprzestrzeniami. Aby lepiej radzić sobie ze zmianami oświetlenia, gestami, mimiką twarzy itp., Fukui i Yamaguchi (2003) zaproponowali ponadto podprzestrzeń ograniczeń, która obejmuje tylko efektywny składnik rozpoznawania. Arandjelovi i inni (2005) zastosowali GMM do poznania rozkładu twarzy. Podstawą tego podejścia jest półparametryczna estymacja gęstości prawdopodobieństwa ograniczona do z natury niskowymiarowych, ale wysoce nieliniowych rozmaitości twarzy osadzonych w wielowymiarowej przestrzeni obrazu . Jako miarę podobieństwa przyjęto dywergencję Kullbacka-Leiblera. Zhou i inni (2003) zastosowali model probabilistyczny opisany w poprzedniej sekcji. Do automatycznego wyboru reprezentantów wideo zastosowano uczenie oparte na przykładach. Indeks przykładu jest również wykorzystywany jako wektor stanu. Łączny rozkład gęstości prawdopodobieństwa jest szacowany poprzez sekwencyjne próbkowanie ważności. Na koniec zmienna tożsamości jest obliczana poprzez marginalizację. Liu i Chen (2003) zaproponowali algorytm rozpoznawania twarzy oparty na wideo, oparty na ukrytym modelu Markowa (HMM), który uwzględnia zarówno informacje czasowe, jak i przestrzenne. Lee i in. (2003, 2005) aproksymowali rozmaitości twarzy skończoną liczbą podprzestrzeni liniowych i wykorzystali informacje temporalne do solidnego oszacowania dynamiki podprzestrzeni liniowych. Li i inni (2001a, 2001b) zastosowali rozmaitość do reprezentacji ujęcia wideo. Trójwymiarowy model kształtu budowany jest z obrazów 2D, modelu tekstur niezależnych od kształtu i pozy oraz modelu geometrycznego afinicznego. Następnie przeprowadzana jest analiza dyskryminacyjna jądra (KDA) w celu wyodrębnienia nieliniowych cech dyskryminacyjnych. Na podstawie tych cech konstruowane są powierzchnie identyfikacyjne. Rozpoznawanie twarzy odbywa się poprzez obliczenie odległości trajektorii między trajektoriami wideo wejściowymi a trajektoriami wideo z bazy danych.
PRZYSZŁE TRENDY
Rozpoznawanie twarzy na podstawie wideo jest aktywnie badane w ostatnich latach. Kluczem do sukcesu jest lepsze wykorzystanie informacji przestrzennych i czasowych w sekwencji wideo. Rozmaitość twarzy danej osoby, podlegająca różnym zmianom (takim jak wyraz twarzy, poza, oświetlenie itp.), jest niewypukła i nieliniowa. Kluczem do rozpoznawania twarzy zarówno na podstawie nieruchomych obrazów, jak i wideo, są efektywne cechy, które umożliwiają rozróżnianie różnych klas i tolerują zmiany wewnątrz klas. Kolejnym trendem jest generowanie trójwymiarowego modelu twarzy z wideo. Przykład można znaleźć w publikacji . Trójwymiarowy model twarzy może rozwiązać problem spowodowany dużą zmianą pozycji i oświetlenia. Jednak złożoność modelu trójwymiarowego jest wysoka.
WNIOSKI
W niniejszym artykule, w oparciu o klasyfikację różnych scenariuszy metod rozpoznawania twarzy, dokonano przeglądu czterech grup technik - rozpoznawania twarzy "obraz - obraz(y)", rozpoznawania twarzy "obraz - wideo", rozpoznawania twarzy "wideo - obraz(y)" oraz rozpoznawania twarzy "wideo - wideo". Przeanalizowano większość istniejących metod rozpoznawania twarzy opartych na wideo. Przedstawiono również ich zalety i wady. Podsumowano niektóre trendy w rozpoznawaniu twarzy opartym na wideo. W przyszłości podejścia te będą dalej badane w celu opracowania większej liczby zastosowań.
Stan techniki w identyfikacji pisarza offline
WSTĘP
Współczesny postęp informatyki i upowszechnienie się komputerów we współczesnym społeczeństwie są niepodważalnym faktem. Niemniej jednak, niezmienne znaczenie ortografii i dokumentów pisanych ręcznie również nie budzi wątpliwości. Nowe technologie umożliwiają nam gromadzenie informacji online, ale w naszym społeczeństwie wciąż istnieje duża ilość informacji, które wymagają użycia algorytmów do pobierania próbek offline. Bezpieczeństwo w niektórych aplikacjach wymaga systemów biometrycznych do ich identyfikacji; w szczególności czeki bankowe, testamenty, pocztówki, faktury, recepty lekarskie itp. wymagają weryfikacji tożsamości osoby, która je napisała. Jedynym sposobem na to jest zastosowanie technik rozpoznawania pisma. Ponadto wiele dokumentów pisanych ręcznie jest podatnych na fałszerstwa, zniekształcenia lub kopie, a ogólnie na nielegalne nadużycia. W związku z tym wysoki odsetek prac rutynowych wykonują eksperci i specjaliści w tej dziedzinie, których zadaniem jest poświadczanie i ocena autentyczności lub fałszywości dokumentów pisanych odręcznie (na przykład testamentów) w postępowaniu sądowym. Dlatego obecnie badania nad identyfikacją autorów są prężnie rozwijającym się obszarem. Niektóre narzędzia programowe umożliwiają ekspertom i specjalistom wyświetlanie i wizualizację określonych cech, ale eksperci ci muszą poświęcić dużo czasu na takie badania, zanim będą mogli wyciągnąć wnioski dotyczące danego tekstu. Dlatego narzędzia te nie oszczędzają czasu ani nie zapewniają skrupulatnej analizy tekstu. Muszą oni pracować z papierem milimetrowym i szablonami, aby uzyskać parametry (kąty, wymiary linii, kierunki, równoległości, krzywizny, wyrównania itp.). Ponadto, muszą używać lupy i papieru milimetrowego, aby mierzyć kąty i linie. Niniejsze badania mają na celu ułatwienie tego żmudnego zadania.
TŁO
Identyfikacja autora jest możliwa, ponieważ pismo każdej osoby jest inne, a każdy ma swoje wrodzone cechy. Podstawy naukowe tego założenia wywodzą się z ludzkiego mózgu. Jeśli spróbujemy pisać naszą mniej sprawną ręką, niektóre części lub kreski będą bardzo podobne do pisma, które tworzymy naszą sprawną ręką. Dzieje się tak, ponieważ to mózg wysyła polecenia do wykonania pisania, a nie ręce. Ogólnie rzecz biorąc, efekt ten jest projektowany na pismo przez dwa rodzaje sił, które są:
o Świadome lub znane: ponieważ jest kontrolowane przez własną wolną wolę jednostki.
o Nieświadome: ponieważ wymyka się kontroli własnej wolnej woli jednostki. Dzielą się one na siły mechaniczne i emocjonalne, które są uczuciami behawioralnymi.
Każdy pisze za pomocą mózgu, a jednocześnie impuls pisma odręcznego, który jest symboliką przestrzeni w celu uzyskania wymiarów pisma, jest dostosowywany proporcjonalnie, a rozmiar tekstu jest utrzymywany lub modyfikowany w zależności od tego, czy jednostka jest zmuszona pisać na ograniczonej przestrzeni. Identyfikacja autora stanowi obecnie ogromne wyzwanie, ponieważ badania w tym zakresie nie są tak w pełni rozwinięte, jak identyfikacja oparta na odciskach palców, dłoniach, twarzy czy tęczówce oka (innych technikach biometrycznych), głównie z powodu trudności w sparametryzowaniu pracy mózgu. Z drugiej strony, wspomniane techniki wykorzystują szeroko zbadane informacje biometryczne. Większość zaimplementowanych cech oferuje informacje w płaszczyźnie pionowej i poziomej . Wprowadziliśmy nowy parametr - indeks proporcjonalności - który rzutuje we wszystkich kierunkach, w zależności od wybranych punktów.
SYSTEM IDENTYFIKACJI PISARZA OFF-LINE
Podobnie jak w przypadku większości dotychczasowych prac nad rozpoznawaniem biometrycznym, struktura systemu opiera się na podstawowych krokach przedstawionych na rysunku 1. Akwizycja obrazów jest krokiem poprzedzającym ten system; dlatego system ten jest systemem off-line. Dane muszą zostać zeskanowane lub sfotografowane, aby zbudować naszą bazę danych.
Akwizycja danych
Analiza kryminalistyczna dokumentów pisanych odręcznie wymaga obszernej bazy danych próbek pisma odręcznego znanego pisarza. Dlatego też pobiera się próbki pisma różnych pisarzy, a następnie pobiera się kilka próbek dla każdego z nich ze względu na ich tymczasową niezmienność. Warunki tworzenia bazy danych muszą być znormalizowane dla różnych rodzajów papieru, długopisu i podobnych podpór (do pisania), ponieważ nasza praca koncentruje się na pisaniu i wydajności proponowanych parametrów. W przypadku tych systemów off-line dokumenty zostały wygenerowane, a zatem, aby zbudować bazę danych, system musi zostać zeskanowany lub wykonane zdjęcie o wysokiej rozdzielczości. Rozdzielczość 300 dpi w skali szarości 8 bitów to dobry próg.
Wstępne przetwarzanie i segmentacja obrazu
Pierwszy etap wstępnego przetwarzania obrazu polega na wykorzystaniu metody Otsu (lub innej metody), która pozwala określić niezbędną wartość progową szarości do przeprowadzenia binaryzacji próbek (Otsu, 1979). W wyniku binaryzacji w większości przypadków linia pisma pozostaje nieregularna. Z tego powodu przeprowadzany jest kolejny etap wstępnego przetwarzania, który umożliwia wygładzenie linii, dzięki czemu pozostaje ona dobrze zdefiniowana. Eliminuje to również szumy występujące w obrazach po procesie skanowania. Jako poprzedni etap separacji słów lub powiązanych elementów, przeprowadzane jest wykrywanie i usuwanie znaków interpunkcyjnych (kropek, akcentów, przecinków itp.). Na koniec słowa tworzące linie pisma są segmentowane (linie bazowe), a w tym celu konieczne jest ustalenie granic dla każdego z nich. Do tej estymacji wykorzystano metodę "Zamkniętych Pudełek" (Ha, Haralick i Phillips, 1995), która dostarcza współrzędnych pozwalających na segmentację słów. Zamknięte pudełka definiuje się jako minimalny prostokąt zawierający spójny składnik.
Ekstrakcja cech
Zadaniem eksperta kaligrafii jest zazwyczaj sporządzenie statystycznej listy różnych pomiarów ilościowych i jakościowych przeprowadzonych na danym dokumencie oraz przedstawienie ich jako dowodu w orzeczeniu. Należą do nich: kolejność, czytelność, konstrukcja liter, połączenia, wymiar, pochylenie liter, odstępy między wyrazami i znakami, wyrównanie i pochylenie linii bazowej, początkowa i końcowa kreska, ciągłość kreski, interpunkcja, kontrola i ruch długopisu. Opracowane systemy porównują testowany dokument z próbkami z bazy danych, wykorzystując cyfrowe przetwarzanie obrazu w celu ekstrakcji cech zdefiniowanych przez system. Możemy zdefiniować trzy różne rodzaje cech: lokalne, globalne i tekstury (rysunek 1).

Cechy lokalne badają konstrukcję poszczególnych znaków w celu identyfikacji szczegółów niektórych liter, ponieważ uważa się, że pisarzowi bardzo trudno jest zmienić sposób pisania swoich liter. Jedna z technik polega na podziale obrazów segmentowanych liter na obszary, a następnie dla każdego obszaru oblicza się kierunek gradientu; Opis geometryczny można również uzyskać, analizując obecność narożników, linii przekątnych, pionowych i poziomych, kierunek i kąt krawędzi oraz zawiasy . Innym sposobem opisu liter jest para współrzędnych (x, y) konturu spójnych składowych, a ponieważ każdy piszący jest uważany za generator skończonej liczby podstawowych wzorów tworzonych przez te spójne składowe; można to scharakteryzować za pomocą dyskretnej funkcji gęstości prawdopodobieństwa emisji podstawowego wzoru kresek . Inna podobna metoda wykrywa niezmienniki morfologiczne za pomocą automatycznego klasyfikatora grafemu; w (Bensefia, Pasquet i Heutte, 2002) autorzy wykazali, że zmienność pisma można mierzyć za pomocą tych niezmienników, ponieważ każdy piszący pisze te same litery, używając takich wzorów lub grafemów. Globalne cechy próbują opisać właściwości pisma i są to pomiary statystyczne wyodrębnione z całej próbki ręcznie pisanego dokumentu, akapitów, wierszy i słów w celu identyfikacji . W (Wirotius, Seropia i Vicent, 2003) przeprowadzono badanie rozkładu poziomów szarości w pikselach pociągnięcia, obliczając krzywą ewolucji tych poziomów wzdłuż odcinków pociągnięcia, obserwując, że symetria względem minimum krzywej przedstawia dużą zmienność w zależności od piszącego i sposobu, w jaki długopis jest umieszczony na papierze. W (Srihari, Cha, Arora i Lee, 2002) zmienność poziomów szarości jest wykrywana za pomocą jej entropii, dając pojęcie o nacisku wywieranym podczas pisania. Innym pomiarem, który dostarcza informacji o nacisku, grubości pociągnięcia i rozmiarze pisma, jest zliczenie liczby czarnych pikseli obrazu binarnego, co może również pozwolić na pośrednie oszacowanie ruchu długopisu podczas pisania, za pomocą średniej ilościowej konturów wewnętrznych i zewnętrznych. Ponieważ kontury składają się z połączonych segmentów pikseli, mogą być przechowywane jako reprezentacja Chaincode, gdzie ich pionowe, poziome i przekątne komponenty będą reprezentować formację pociągnięcia. Inne globalne cechy to średnie nachylenie , lokalizacja linii bazowych i ich pochylenie, wysokość wznoszącego się, opadającego i środkowego korpusu pisma , średnia szerokość znaków, zachowanie marginesów, długość słów i odległość między wierszami i słowami. Aby uzyskać cechy tekstury, próbkę pisma postrzega się jako prosty obraz, a nie rękopis, dlatego pismo każdej osoby można rozpatrywać jako odrębną teksturę; stosując do niego na przykład filtry Gabora i macierze współwystępowania . Aby cechy reprezentowały styl pisania, muszą spełniać następujące wymagania: wahania w piśmie danej osoby muszą być jak najmniejsze, podczas gdy wahania między różnymi autorami muszą być jak największe. Każda z tych cech jest oceniana w celu określenia jej wskaźnika dyskryminacji, który pozwala na pomiar przydatności każdej cechy do identyfikacji autorów. Jedną z największych trudności w automatycznej identyfikacji jest radzenie sobie z dużą zmiennością stylów pisania, dlatego też etap ekstrakcji cech wciąż wymaga pracy, ponieważ jego celem jest wykrycie cech różnicujących pismo, które charakteryzują style pisma. Do tej pory większość cech wykorzystywanych przez ekspertów nie została jeszcze zaimplementowana algorytmicznie. W niniejszej pracy stworzono listę parametrów geometrycznych o różnych wymiarach do analizy dokumentów. Aby cechy reprezentowały styl pisania, powinny one spełniać następujący warunek: wahania w piśmie danej osoby powinny być jak najmniejsze, a wahania między różnymi autorami jak największe. Ta cecha znajduje się na liście następujących cech już opracowanych :
o długość słów,
o liczba pikseli w kolorze czarnym,
o oszacowanie szerokości liter,
o wysokość średniej części pisma,
o wysokości liter rosnących i malejących,
o relacja wysokości między literami rosnącymi i średnimi,
o relacja wysokości między literami opadającymi i średnimi,
o relacja wysokości między literami opadającymi i rosnącymi,
o relacja wysokości między literami średnimi a szerokością pisma.
Liczba czarnych pikseli i długich słów pozwoli nam oszacować wymiar i grubość linii, szerokość liter i wysokość liter. Oprócz tego są to charakterystyczne cechy stylu pisma. Oszacowanie szerokości liter przeprowadza się poprzez znalezienie rzędu o największej liczbie przejść między czernią a bielą (od 0 do 1). Liczona jest liczba białych pikseli między każdym przejściem, a wynik jest uśredniany. Aby zmierzyć wysokość środkowej części słów, celem jest określenie górnej i dolnej linii bazowej poprzez wartości maksymalne i minimalne oraz zmierzenie odległości między nimi. Aby zbliżyć się do linii bazowych każdego słowa, postanowiono zastosować korektę minimalnego błędu średniokwadratowego, która opiera się na znalezieniu równania (patrz wyrażenie 1), które najlepiej pasuje do zbioru punktów "n" . Równanie jest następujące:
y =ax + b (1)
gdzie współczynniki "a" i "b" określają liniową regresję wielomianową za pomocą następującego wyrażenia:

Wartości "a" i "b", oparte na współrzędnych minimów lub maksimów wykrytych w konturze słowa, stanowią różne linie bazowe. Minima mają zbliżać się do dolnej linii bazowej, a maksima do górnej linii bazowej. Wyodrębnienie wskaźnika proporcjonalności jest nowym parametrem w naszym systemie i w literaturze. Wybór punktów jest losowy, ale z pewnymi wskazaniami, dlatego też za najbardziej reprezentatywne miejsca uznaliśmy miejsca wstępujące, zstępujące, zakończenia itp. W niniejszym artykule najbardziej reprezentatywne punkty (czerwone punkty) przedstawiono na rysunku 3.

Dla tego samego słowa dla każdego autora oznaczyliśmy te same czerwone punkty. Oznaczone punkty są połączone (patrz rysunek 3), a każda linia między dwoma punktami jest traktowana jako odcinek. Zmierzyliśmy długość euklidesową każdego odcinka, uzyskując średnią i odchylenie standardowe. Są to nowe i nowatorskie parametry, które dostarczają informacji z każdego kierunku słowa.
System klasyfikacji
Problem identyfikacji autorów można rozpatrywać z dwóch różnych punktów (rysunek 4);
,br>

Pierwsze podejście to weryfikacja, która pozwala nam określić, czy dwa dokumenty zostały napisane przez tę samą osobę, czy przez dwie różne osoby. Drugie podejście to identyfikacja polegająca na rozpoznaniu autora wśród zbioru N kandydatów. Ten przypadek można postrzegać jako problem klasyfikacji N klas. Ze względu na potencjalnie dużą liczbę kandydatów, decyzja opiera się na pomiarze najbliższego sąsiada; jego zaletą jest bezpośrednia identyfikacja autora. Oba podejścia opierają się na metodzie pomiaru podobieństwa lub odległości między próbkami; a system musi zostać wytrenowany na zbiorze próbek pisma odręcznego należących do każdego kandydata (klasyfikacja nadzorowana). Najczęściej stosowanymi metodami klasyfikacji są: metoda najbliższych k-sąsiadów , sieć neuronowa , ukryte modele Markowa , modele mieszane Gaussa itd.
TRENDY NA PRZYSZŁOŚĆ
Tendencją na przyszłość jest wykorzystanie grafologii jako fundamentalnego elementu do tworzenia nowych funkcji, ponieważ eksperci lub profesjonaliści mają więcej lat doświadczenia i wiarygodności w tej dziedzinie. Ilościowe wdrożenie tych funkcji zaowocuje pozytywnym wzrostem wskaźników sukcesu.
WNIOSKI
Systemy identyfikacji autorów mogą stać się potężnym narzędziem dla ekspertów kaligrafii, ponieważ pozwolą im skrócić czas poświęcany na analizę niektórych cech pisma, ponieważ system rozwinie zadania wykrywania, ekstrakcji, porównywania, klasyfikacji i rozpoznawania. Logicznie rzecz biorąc, nie zastąpi ich, ponieważ w tym złożonym zastosowaniu nie da się dorównać ludzkiej mocy obserwacyjnej; dlatego zawsze będą istnieć cechy, które będą musiały zostać przeanalizowane przez ekspertów, ponieważ są bardzo trudne do wdrożenia algorytmicznego. Wreszcie, identyfikacja pisarza offline to otwarte pole badawcze, w którym działanie różnych i nowych metod jest udoskonalane i rozpowszechniane pod względem wykorzystania.
Systemy diagnostyki klinicznej oparte na mowie
WSTĘP
Możliwe jest wdrożenie systemów wspomagających diagnostykę zorientowanych na ocenę systemu fonatora za pomocą sygnału mowy, za pomocą technik opartych na systemach eksperckich. Zastosowanie tych technik pozwala na wczesne wykrywanie zmian w systemie fonatora lub tymczasową ocenę pacjentów w trakcie określonego leczenia, by wymienić tylko niektóre przykłady. Procedura pomiaru jakości głosu mówcy na podstawie nagrania cyfrowego polega na kwantyfikacji różnych charakterystyk akustycznych mowy, co umożliwia porównanie jej z pewnymi wzorcami odniesienia, zidentyfikowanymi wcześniej przez "eksperta klinicznego". Pomiar jakości akustycznej mowy oparty na ocenie słuchowej jest bardzo trudny do oceny jako punkt odniesienia porównawczego między różnymi głosami i różnymi ekspertami przeprowadzającymi ocenę lub ewaluację. W niniejszej bibliografii podjęto próby uzyskania obiektywnych miar jakości mowy za pomocą wielowymiarowych pomiarów klinicznych opartych na metodach słuchowych. Znane przykłady to: japońska skala GRBAS i jej rozszerzenie opracowane i stosowane w Europie , szwedzki zestaw cech percepcyjnych i akustycznych , zestaw cech fonetycznych z dodatkowymi informacjami o pobudzeniu aparatu głosowego. Celem tych procedur (pomiarów jakości mowy) jest uzyskanie obiektywnego pomiaru na podstawie subiektywnej oceny. Istnieją różne prace, w których proponuje się obiektywne pomiary jakości mowy uzyskane z nagrania . W tych pracach rejestrowany jest dźwięczny dźwięk podtrzymywany (zwykle samogłoska), a następnie wykorzystywany do obliczania pomiarów jakości mowy. Wykorzystanie dźwięcznego dźwięku podtrzymywanego wynika z faktu, że podczas produkcji tego rodzaju dźwięku system mowy wykorzystuje niemal wszystkie swoje mechanizmy (stały przepływ powietrza przez krtań, ciągłe drgania fałdów głosowych itd.), co pozwala nam wykryć wszelkie anomalie w tych mechanizmach. W tych pracach sugerowane są różne zestawy pomiarów w celu obiektywnej oceny jakości mowy. We wszystkich tych pracach ujawnia się jeden ważny fakt: konieczne jest uzyskanie różnych pomiarów sygnału mowy w celu zestawienia różnych aspektów jego charakterystyki akustycznej.
TŁO
Nagranie mowy daje różne charakterystyki jakości mowy mówcy. Zarejestrowany sygnał mowy może być reprezentowany w różnych domenach. Każda domena prezentuje niektóre cechy mowy w sposób preferencyjny. Główne dziedziny badane w przetwarzaniu mowy to:
o Dziedzina czasu
o Dziedzina widmowa
o Dziedzina cepstralna
o Dziedzina modelu odwrotnego
Większość prac z zakresu cyfrowego przetwarzania sygnałów mowy opiera się na tych dziedzinach. Jednak inne prace wykorzystują nowe dziedziny, wywodzące się z poprzednich. W poniższej sekcji opisano najważniejsze cechy każdej dziedziny.
Domena czasu
Sygnał mowy wysokiej jakości charakteryzuje się bardziej regularną obwiednią niż sygnał mowy niskiej jakości. Fakt ten jest bardziej widoczny w krótkich odstępach czasu. Główne zjawiska, które pozwalają odróżnić mowę wysokiej jakości od mowy niskiej jakości, to:
Energia sygnału mowy w krótkim odstępie czasu zmienia się znacząco między dwoma kolejnymi odstępami w przypadku mowy niskiej jakości, podczas gdy w przypadku mowy wysokiej jakości zmiana energii jest mniejsza. W przypadku mowy niskiej jakości pojawiają się nieperiodyczności (bez periodyczności) w przypadku mowy dźwięcznej.
Domena widmowa
Mowa niskiej jakości (dźwięk dźwięczny) charakteryzuje się następującymi cechami:
o Mniejsza regularność obwiedni widmowej, głównie w niskich częstotliwościach.
o Większy udział energii w niskich częstotliwościach w stosunku do energii całkowitej.
o Bloki energetyczne w wysokich częstotliwościach. Bloki te są spowodowane szumem krtaniowym.
o Duża zmiana widma mocy z ramki w stosunku do ramek sąsiednich.
Mowa wysokiej jakości koncentruje swoją energię wokół określonych formantów, głównie pierwszego i trzeciego formantu, podczas gdy mowa niskiej jakości ma składowe szumu wokół formantów. Mowa wysokiej jakości charakteryzuje się dużym bogactwem widmowym. Mowa niskiej jakości ma jednak niewielką ilość składowej harmonicznej, skoncentrowanej głównie w bardzo niskich częstotliwościach. Ilość bogactwa widmowego jest cechą głosu danego mówcy. Jednakże zmienność bogactwa widmowego w czasie (podczas produkcji dźwięku dźwięcznego) jest rzeczywiście wskaźnikiem mowy niskiej jakości. Inną cechą mowy niskiej jakości (podczas produkcji dźwięku dźwięcznego) są zmiany rytmu wibracji fałdów głosowych, tj. zmienność częstotliwości w częstotliwości wysokości dźwięku.
Domena cepstralna
Cechy oceny jakości mowy można zidentyfikować w domenie cepstralnej: obwiednię widma, bogactwo widmowe, identyfikację składowych harmonicznych i szumu itp. Dźwięk dźwięczny o długości trzykrotnie dłuższej od okresu wysokości dźwięku jest używany w domenie cepstralnej. Bogactwo widmowe sygnału mowy można określić ilościowo za pomocą amplitudy i szerokości składowej cepstralnej częstotliwości dźwięku. Istnienie piku o dużej amplitudzie wskazuje na obecność znacznej energii w tej składowej harmonicznej. Jest to cecha charakterystyczna mowy wysokiej jakości. Zmniejszona szerokość piku cepstralnego odpowiadającego wysokości dźwięku wskazuje na wysoką stabilność częstotliwości dźwięku przez trzy kolejne okresy. Jest to również cecha charakterystyczna mowy wysokiej jakości. Cechy takie jak amplituda i szerokość piku cepstralnego odpowiadającego drugiej harmonicznej mogą być również wykorzystane do rozróżnienia mowy wysokiej i niskiej jakości. Mowa wysokiej jakości posiada pik cepstralny odpowiadający pierwszej harmonicznej węższy niż pik cepstralny odpowiadający drugiej harmonicznej. Szum krtaniowy w sygnale mowy można oszacować za pomocąpoprzez relacje między różnymi obszarami w domenie cepstralnej: składową harmoniczną (składowe cepstralne wysokości dźwięku i jego harmoniczne) i składową szumu (pozostałe składowe cepstralne).
Domena modelu odwrotnego
W tej domenie estymuje się przebieg impulsu powietrza wytwarzanego przez fałdy głosowe podczas wytwarzania dźwięku o przedłużonej dźwięczności. Impuls powietrza nazywany jest również sygnałem resztkowym lub strumieniem krtaniowym. Estymację uzyskuje się za pomocą filtra odwrotnego zastosowanego do sygnału mowy w celu wyeliminowania wpływu na trakt głosowy i efekt promieniowania warg. Jakość mowy można określić ilościowo za pomocą niektórych cech sygnału krtaniowego, takich jak wartości amplitudy, czas, w którym fałdy głosowe zaczynają się otwierać, czas, w którym fałdy głosowe są całkowicie otwarte, czas, w którym rozpoczyna się faza zamykania fałdów głosowych oraz różne zależności między różnymi momentami cyklu krtaniowego: ilorazem otwarcia, ilorazem szybkości, ilorazem zamknięcia itp.
Dziedzina nieliniowa
Główne komercyjne systemy do obiektywnej oceny jakości mowy na podstawie nagrania (Dr Speech (Tiger Elemetric), SSVA (System do analizy pojedynczego głosu), MDVP (Multi-Dimensional Voice Program), EVA (Evaluation Vocal Assistee), CSL (Computerized Speech Laboratory) PRAAT, VISHACSRE (Computerized Speech Research Environment), MEDIVOZ itp.) nie oceniają nieliniowych cech sygnału mowy. Najpopularniejszym modelem charakteryzacji systemu produkcji głosu jest system zmienny w czasie, oparty na liniowych teoriach akustyki. Składa się z modelu źródła/filtra. Istnienie zmian amplitudy widmowej sygnału mowy w częstotliwości podstawowej prowadzi nas do nieliniowego zachowania sygnału mowy. W sygnale mowy zidentyfikowano częstotliwość podstawową (fs) i subharmoniczną (fs/2) . Efektem subharmonicznym jest modulacja amplitudy i/lub modulacja częstotliwości. Inni autorzy wskazują, że 31% mówców z mową patologiczną ma subharmoniczne w mowie. Jednak istnienie subharmonicznych zostało również zidentyfikowane w mowie wysokiej jakości . Szacuje się, że 10,5% mówców ze zdrową mową ma subharmoniczne, co nie jest objawem mowy anomalnej. Istnieją dwie teorie uzasadniające obecność subharmonicznych: teoria Titzy : subharmoniczne wynikają z asymetrii mechanicznej lub geometrycznej między fałdami głosowymi. teoria Sveca : częstotliwość subharmoniczna wynika z połączenia dwóch trybów drgań (bifonacja: obecność dwóch głównych częstotliwości), których częstotliwości pozostają w relacji 3:2. Niemniej jednak obie teorie są takie same według (Neubauer J., Eysholdt P., Eysholdt U., Herzel H., 2001), gdzie autorzy wskazują, że bifonacja jest spowodowana asymetrią między lewymi i prawymi fałdami głosowymi lub desynchronizacją w drganiach posuwisto-zwrotnych . Asymetria i desynchronizacja są spowodowane różnicami w masach i właściwościach lepkosprężystych między fałdami głosowymi. Można to modelować za pomocą nieliniowej fonacji. W (Ayache S., Maurice Ouaknine, Dejonkere P., Prindere P. & Giovanni A., 2004) sugerowane są modele nieliniowe w celu wyjaśnienia wpływu lepkości śluzu na fałdy głosowe (śluz na powierzchni fałdów głosowych generuje napięcie powierzchniowe i powoduje adhezję). W tradycyjnym modelu traktu głosowego zakłada się, że propagacja fali dźwiękowej jest falą prostą. Jednak pomiary ciśnienia akustycznego i pomiary zmian głośności są lepiej dopasowane do nieliniowego modelu dynamiki płynu. Wynika to z turbulencji (a nawet turbulencji okresowych) wytwarzanych przez wnęki między fałdami głosowymi a pozornymi fałdami głosowymi. Turbulencje te pobudzają trakt głosowy w fazie zamykania fałdów głosowych. Niektórzy autorzy badali wymiar fraktalny. Doszli oni do wniosku, że sygnał mowy wysokiej jakości charakteryzuje się niską wymiarowością. Stwierdzono, że ilość aliniowości w systemie mowy jest wskaźnikiem nieprawidłowej fonacji i zasugerowano, że wymiarowość przestrzeni fazowej, wykorzystywana do charakterystyki atraktora, może być powiązana z masą fałdów głosowych.
KWANTYFIKACJA JAKOŚCI MOWY
W poprzedniej sekcji opisano różne cechy sygnału mowy w różnych domenach. Te cechy pozwalają nam ocenić jakość mowy. Każda cecha charakteryzuje zjawisko fizyczne związane z emisją głosu. Zjawisko fizyczne może występować w różnych domenach. W niniejszej pracy zidentyfikowano zbiór zjawisk fizycznych umożliwiających poprawną dokumentację jakości głosu. Cztery zidentyfikowane zjawiska fizyczne to:
Stabilność głosu: to zdolność mówcy do wytworzenia stałego strumienia powietrza o stałym natężeniu w celu pobudzenia fałdów głosowych (podczas wymawiania dźwięku o przedłużonej dźwięczności). To zjawisko fizyczne jest kwantyfikowane na podstawie pomiarów stabilności mowy.
Bogactwo widmowe: to zdolność do generowania okresowego ruchu fałdów głosowych (podczas wymawiania dźwięku o przedłużonej dźwięczności) i wywoływania dźwięcznego pobudzenia toru głosowego z dużą liczbą składowych widmowych. To zjawisko fizyczne jest kwantyfikowane poprzez obliczenie stabilności częstotliwościowej wysokości dźwięku oraz poprzez liczbę harmonicznych o wysokiej energii w różnych pasmach częstotliwości.
Obecność szumu: jest to związane z obecnością szumu krtaniowego w sygnale mowy podczas fonacji dźwięku o przedłużonej dźwięczności. Obecność szumu krtaniowego wynika z problemów w fazie zamykania się fałdów głosowych. To zjawisko fizyczne jest kwantyfikowane poprzez pomiar obecności szumu niestacjonarnego w sygnale mowy.
Nieregularności fałdów głosowych: aliniowości w systemie mowy są spowodowane nieprawidłowym funkcjonowaniem fałdów głosowych. Wynika to z nieregularności mas zaangażowanych w fazę zamykania fałdów głosowych, asymetrycznego ruchu fałdów głosowych oraz czynników związanych ze śluzem fałdów głosowych. Zjawiska te są kwantyfikowane za pomocą nieliniowego zachowania sygnału mowy.
Mowa nieprawidłowa występuje, chyba że jedna z wartości odpowiadających kwantyfikacji czterech zjawisk fizycznych wykracza poza zakres normy. Ta procedura kwantyfikacji jakości mowy pozwala nam zidentyfikować anomalie mowy o różnym pochodzeniu. Te cztery rodzaje zjawisk fizycznych można kwantyfikować w różnych dziedzinach, stosując różne obiektywne pomiary jakości mowy, które pozwalają na kwantyfikowanie pojedynczego zjawiska fizycznego z większą lub mniejszą dokładnością.
TRENDY NA PRZYSZŁOŚĆ
Ogólnie rzecz biorąc, nie jest możliwe zidentyfikowanie patologii w układzie fonatorowym na podstawie samego nagrania mowy. Twierdzą tak różni autorzy. Wynika to z faktu, że charakterystyki akustyczne dwóch osób z różnymi patologiami w układzie fonatorowym mogą być podobne. Nawet podczas oględzin krtani nie można określić tożsamości patologii. Co więcej, współwystępowanie większej liczby patologii w układzie fonatorowym jest również częste. Niemniej jednak, wiele prac koncentruje się na identyfikacji obecności anomalii w układzie fonatorowym. Automatyczny system wykrywania anomalii w systemie mowy ma ten sam schemat, co system rozpoznawania mowy (patrz rysunek 5). Blok "Akwizycja głosu" digitalizuje sygnał mowy. W tym bloku zazwyczaj dokonuje się rozróżnienia sygnału mowy od szumu, a także segmentacji sygnału mowy w ramkach. W bloku "Parametryzacja" jakość mowy jest kwantyfikowana za pomocą różnych pomiarów jakości dla każdej ramki, na którą podzielony jest sygnał mowy. Kwantyfikacja pozwala nam zidentyfikować cechy różnicowe pomiędzy różnymi jednostkami klasyfikacji. W naszym przypadku jednostkami klasyfikacji są mowa zdrowa i patologiczna. W tym bloku każda ramka mowy jest przekształcana w wektor cech (lub wektor pomiarów). Niektóre pomiary uśredniają pewne kwantyfikacje cechy akustycznej lub oceniają jej ewolucję w czasie podczas fonacji. Automatyczna klasyfikacja wektora cech jest przeprowadzana w bloku "klasyfikacja". Systemy klasyfikacji obejmują maszyny wektorów nośnych, sieci neuronowe itp. W naszym przypadku klasyfikacja dla każdego wektora cech dotyczy mowy zdrowej i patologicznej. Proponujemy przeprowadzenie badań klinicznych w celu oceny przydatności automatycznych systemów kwantyfikacji jakości mowy w logopedii, otolaryngologii i foniatrii. Badania te pozwolą na zastosowanie proponowanego protokołu do pomiaru jakości mowy w takich dziedzinach, jak ocena operacji chirurgicznej, dokumentacja przebiegu leczenia, dokumentacja medyczno-prawna i telemedycyna. Możliwe będzie wdrożenie automatycznych systemów klasyfikacji mowy zdrowej i patologicznej z baz danych o różnych cechach mowy, a nawet systemów zdolnych do automatycznego pomiaru poziomu dysfonii. Systemy te mogą być wykorzystywane w badaniach przesiewowych lub w diagnostyce logopedycznej.
WNIOSKI
W niniejszej pracy zidentyfikowano różne zjawiska fizyczne charakteryzujące jakość głosu. Zjawiska te zostały skwantyfikowane w celu uzyskania prawidłowej dokumentacji jakości głosu. Wprowadzono kwantyfikację zachowań nieliniowych w mowie sygnałowej, aby bardziej realistycznie opisać zachowanie fałdów głosowych. Kwantyfikacja jakości głosu pozwala na wdrożenie systemów wspomagających diagnostykę patologii w systemie fonatorowym za pomocą nadzorowanych systemów automatycznego rozpoznawania, takich jak maszyny wektorów nośnych (SVM) lub sieci neuronowe (NN). Postępy w kwantyfikacji głosu zastosowane w dziedzinie syntezy głosu poprawią naturalność produkcji głosów syntetycznych. Rozwój automatycznej detekcji nastroju (np. detekcji smutku, gniewu lub radości) jest możliwy dzięki wykorzystaniu wiedzy zdobytej w pomiarach jakości głosu. Dzięki tym systemom nie będzie można postrzegać mowy werbalnej. Systemy te mogą znaleźć zastosowanie w nowych generacjach interfejsów człowiek-komputer.
Sieci neuronowe na weryfikacji podpisu odręcznego
WSTĘP
Biometria oferuje potencjał automatycznej identyfikacji i weryfikacji osób, w odróżnieniu od innych środków weryfikacji osób; środki biometryczne nie opierają się na posiadaniu czegokolwiek (jak karty) lub znajomości jakichś informacji (jak hasła). Istnieje duże zainteresowanie uwierzytelnianiem biometrycznym opartym na systemach automatycznej weryfikacji podpisu (ASV), ponieważ ASV wykazało wyższość nad wieloma innymi technikami uwierzytelniania biometrycznego, m.in. odciski palców lub wzory siatkówki, które są niezawodne, ale znacznie bardziej inwazyjne i kosztowne. System ASV to system zdolny skutecznie sprostać zadaniu polegającemu na podjęciu decyzji, czy podpis jest autentyczny, czy sfałszowany. Do weryfikacji podpisu zastosowano wiele metod rozpoznawania wzorców. Wśród metod zaproponowanych do rozpoznawania wzorców w ASV można wyróżnić dwie szerokie kategorie: metody oparte na pamięci i metody oparte na parametrach, takie jak sieć neuronowa. Główne podejścia do systemów ASV to podejście dopasowywania szablonów, podejście widma, podejście analizy widma, podejście sieci neuronowych, podejście poznawcze i podejście fraktalne. W proponowanym artykule dokonano przeglądu technik ASV odpowiadających podejściu proponowanym dotychczas w literaturze. Podjęto próbę opisania ważnych technik, szczególnie tych z udziałem sieci NN i oceny ich działania w oparciu o opublikowaną literaturę. W artykule omówiono także możliwe przyszłe obszary badań z wykorzystaniem ASV.
TŁO
Jak każda twórczość ludzka, pismo ręczne podlega wielu zmianom o bardzo różnym pochodzeniu: historycznym, geograficznym, etnicznym, społecznym, psychologicznym itp. ASV jest trudnym problemem, ponieważ próbki podpisów tej samej osoby są podobne ale nie identyczne. Ponadto podpis osoby często zmienia się radykalnie w ciągu jej życia . Chociaż te czynniki mogą mieć wpływ na daną osobę piszącą, styl pisania rozwija się w miarę nauki pisania przez pisarza, podobnie jak zazwyczaj zachowywana konsystencja. Jedną z metod stosowanych przez ekspertów zajmujących się badaniem dokumentów jest próba wykorzystania tych spójności i zidentyfikowanie takich, które są zarówno stabilne, jak i trudne do imitacji. Ogólnie systemy ASV można podzielić na dwa rodzaje: systemy on-line i off-line. W przypadku trybu online użycie urządzeń elektronicznych do przechwytywania dynamiki podpisu pozwala zarejestrować więcej informacji o procesie podpisywania, poprawiając jednocześnie wydajność systemu, w przypadku podejścia offline dla ASV te dynamiczne informacje są tracone i dostępny jest jedynie statyczny obraz. Utrudnia to zdefiniowanie skutecznych cech globalnych lub lokalnych do celów weryfikacji. W systemie ASV zwykle uwzględnia się trzy różne rodzaje fałszerstw: fałszerstwa przypadkowe, powstałe bez znajomości nazwiska podpisującego ani kształtu jego podpisu; proste fałszerstwa, sporządzone ze znajomością nazwiska podpisującego, ale bez wzoru jego podpisu; oraz umiejętne fałszerstwa, wykonane przez ludzi, którzy patrząc na oryginalny egzemplarz podpisu, starają się go jak najdokładniej naśladować. Problem weryfikacji podpisu staje się trudniejszy przy przejściu od przypadkowych do prostych i umiejętnych fałszerstw, przy czym to drugie jest zadaniem tak trudnym, że w kilku przypadkach nawet ludzie popełniają błędy. Należy zauważyć, że kilka zaproponowanych do tej pory systemów, które radziły sobie całkiem dobrze w przypadku jednej kategorii fałszerstw, spadały podczas jednoczesnej pracy ze wszystkimi kategoriami i ogólnie rzecz biorąc, spadek ten był większy, niż można by się spodziewać. Do weryfikacji podpisu zastosowano wiele metod rozpoznawania wzorców . Wśród zaproponowanych metod rozpoznawania wzorców można wyróżnić dwie szerokie kategorie: techniki oparte na pamięci, w których przychodzące wzorce są dopasowywane do (zwykle dużego) słownika szablonów,oraz metody oparte na parametrach, w których wstępnie przetworzone wzorce są wysyłane do możliwego do wytrenowania klasyfikatora, takiego jak sieć neuronowa (Lippmann, 1987). Metody rozpoznawania oparte na pamięci wymagają dużej przestrzeni pamięci do przechowywania szablonów, podczas gdy sieć neuronowa to podejście oparte na parametrach, które wymaga jedynie niewielkiej ilości miejsca w pamięci do przechowywania wag połączeń między neuronami. Mighell i inni byli najwyraźniej pierwszymi, którzy pracowali nad zastosowaniem sieci NN do klasyfikacji podpisów offline. Sabourin i Drouhard zaprezentowali metodę opartą na kierunkowych funkcjach gęstości prawdopodobieństwa wraz z sieciami neuronowymi BackPropagation (BPN) w celu wykrywania przypadkowego fałszerstwa. Qi i Hunt wykorzystali cechy globalne i siatkowe z prostym euklidesowym klasyfikatorem odległości. Sansone i Vento zaproponowali sekwencyjny, trzyetapowy system wielu ekspertów, w którym pierwszy ekspert eliminuje przypadkowe i proste fałszerstwa, drugi izoluje wykwalifikowane fałszerstwa, a trzeci wydaje ostateczną decyzję, łącząc decyzje z poprzednich etapów wraz z szacunkami wiarygodności. Baltzakis i Papamarkos opracowali dwustopniową sieć neuronową, w której pierwszy etap pobiera decyzje z sieci neuronowych i euklidesowych klasyfikatorów odległości dostarczonych przez cechy globalne, siatkowe i teksturowe, a drugi łączy cztery decyzje przy użyciu sieci neuronowej z funkcją radialną (RBF).
GŁÓWNY TEMAT
Jak wspomniano powyżej, głównymi podejściami do systemów weryfikacji podpisów są podejście dopasowywania szablonów, podejście widma, podejście analizy widma, podejście sieci neuronowych, podejście poznawcze i podejście fraktalne. Sztywne dopasowanie szablonu, najprostsze i najwcześniejsze podejście do rozpoznawania wzorców, może skutecznie wykryć przypadkowe fałszerstwa prawdziwych podpisów, ale nie może skutecznie wykryć fałszerstw. Podejście statystyczne, obejmujące HHM, Bayesa i tak dalej, może wykryć przypadkowe fałszerstwa, a także umiejętne fałszerstwa od prawdziwych. Podejście strukturalne wykazuje dobrą skuteczność w wykrywaniu prawdziwych podpisów i fałszerstw. Jednak takie podejście może skutkować kombinatoryczną eksplozją możliwości do zbadania, wymagającą dużych zbiorów treningowych i bardzo dużych wysiłków obliczeniowych. Podejście oparte na analizie widma można zastosować do różnych języków, w tym angielskiego i chińskiego. Ponadto można go zastosować do systemów weryfikacji on-line lub off-line. Podejście oparte na sieciach neuronowych ma kilka zalet, takich jak ujednolicone podejście do ekstrakcji i klasyfikacji cech oraz elastyczne procedury znajdowania dobrych, umiarkowanie nieliniowych rozwiązań. Kiedy jest używany do weryfikacji podpisu on-line lub offline, wykazuje również rozsądną wydajność.
Sieci neuronowe w ASV
Sieci neuronowe z wielowarstwowym perceptronem (MLP) należą do najczęściej używanych klasyfikatorów w przypadku problemów z rozpoznawaniem wzorców. Pomimo swoich zalet, mają one pewne bardzo poważne ograniczenia, które w przypadku niektórych problemów uniemożliwiają ich użycie. Pierwszym ograniczeniem jest wielkość sieci neuronowej. W przypadku bardzo dużych sieci neuronowych bardzo trudno jest je wytrenować. W miarę wzrostu ilości danych szkoleniowych trudność ta staje się poważną przeszkodą w procesie uczenia. Druga trudność polega na tym, że geometria, rozmiar sieci, zastosowana metoda uczenia i parametry uczenia zależą w dużej mierze od ilości danych uczących. Ponadto, aby określić strukturę i wielkość sieci neuronowej, należy z góry poznać liczbę klas, z którymi sieć neuronowa będzie musiała sobie poradzić. Niestety, jeśli mówimy o użytecznym ASV, wiedza aprioryczna na temat liczby podpisów i liczby właścicieli podpisów nie jest dostępna . W przypadku BPN stosuje się prawo uczenia się do modyfikowania wartości wag w oparciu o wyjściowy sygnał błędu propagowany z powrotem w sieci. Z losowych wartości początkowych wagi są zmieniane zgodnie z prawem uczenia się, które wykorzystuje szybkość uczenia się i szybkość wygładzania, co czasami pozwala na szybszą zbieżność fazy uczenia. Faza szkolenia jest krytyczna, zwłaszcza gdy dane podlegające klasyfikacji nie są wyraźnie rozróżnialne i gdy nie ma wystarczającej liczby przykładów do przeprowadzenia szkolenia. W takim przypadku faza szkolenia może być bardzo długa, a uzyskanie akceptowalnych wyników może być nawet niemożliwe. Zwykle definiuje się kryterium zatrzymania fazy szkoleniowej. Następnie ocenia się kilka metod odrzucania, aby poprawić decyzję podjętą przez tego rodzaju klasyfikator. Na koniec liczba neuronów w warstwie ukrytej BPN jest dostosowywana w celu zwiększenia globalnej wydajności pierwszego etapu ASV . Ciekawym aspektem BPN jest to, że podczas naukiprocesu ukryte warstwy tworzą wewnętrzną reprezentację danych wejściowych, która jest przydatna do wytworzenia wyniku . (Fleming. 1990) zastosował dwustopniową sieć NN z taką samą liczbą neuronów dla warstwy wejściowej i wyjściowej oraz mniejszą liczbą jednostek dla warstwy ukrytej. To zmusza sieć do kodowania danych wejściowych w przestrzeni o mniejszych wymiarach, zachowując większość istotnych informacji w sposób równoważny metodzie analizy głównych składowych (PCA). Sieci tej klasy nazywane są sieciami kompresyjnymi. Ważną właściwością sieci kompresyjnych jest to, że mogą one działać jako pamięci autoasocjacyjne lub pamięci adresowalne treściowo . Oznacza to, że sieci te są w stanie w akceptowalny sposób zrekonstruować zdegradowany wzór, gdy na wejściu podawany jest szum, lub uzupełnić niekompletny wzór wejściowy . Jakość wyników będzie zależała od liczby ukrytych jednostek sieci kompresyjnej. Z drugiej strony syntaktyczne sieci NN mogą modelować gramatyki stochastyczne i niestochastyczne. Uczenie się jest zatem procesem wnioskowania gramatycznego, a rozpoznawanie procesem analizowania. Zauważ, że ma to dużą ogólność; zmieniając gramatykę, możemy uwzględnić szeroką gamę modeli rozpoznawania wzorców. Sieci stochastyczne są odpowiednio probabilistyczne i są potężnymi dyskryminatorami; niestochastyczne są mniej wydajne, ale mają prostą implementację krzemową w istniejącej technologii. Uczenie się w sieciach syntaktycznych może przebiegać pod nadzorem lub bez nadzoru .
Połączone podejścia klasyfikatorów
(Baltzakis, 2001) przedstawia inną technikę rozpoznawania i weryfikacji podpisów off-line. Propozycja stawia czoła wyżej wymienionym problemom BPN poprzez skrócenie czasu obliczeń uczących (osiąga się to, ponieważ każda sieć neuronowa odpowiada tylko jednemu właścicielowi sygnatury) i rozmiaru używanych sieci neuronowych (zestaw funkcji jest podzielony na trzy różne grupy, tj. cechy globalne, cechy siatki i cechy tekstury). Dla każdego z tych zestawów funkcji zaimplementowano specjalną dwustopniową strukturę klasyfikacji Perceptron OCON (jedna klasa-jedna sieć). W pierwszym etapie klasyfikator łączy wyniki decyzji sieci neuronowych z odległością euklidesową uzyskaną przy użyciu trzech zbiorów cech. Wyniki klasyfikatora pierwszego stopnia zasilają strukturę sieci neuronowej drugiego etapu radialnej funkcji bazowej (RBF), która podejmuje ostateczną decyzję. Aby skutecznie weryfikować umiejętne fałszerstwa, rozmyta sieć neuronowa zwana Fuzzy Neural Network oparta na pseudoproduktach zewnętrznych (POPFNN) jest zintegrowana z systemem weryfikacji podpisów opisanym w (Zhou, 1996). Jako hybryda systemów rozmytych i sieci neuronowych, POPFNN posiada wiele zalet, takich jak wysokie możliwości obliczeniowe i zdolność uczenia się w porównaniu z innymi technikami stosowanymi w systemach weryfikacji podpisów. Jako hybrydowe inteligentne systemy, rozmyte sieci NN mają zalety zarówno sieci NN, jak i systemów rozmytych opartych na regułach i są szczególnie skuteczne w radzeniu sobie ze złożonymi, nieliniowymi i nieprecyzyjnymi problemami, takimi jak ASV. Poza tym funkcje członkostwa i niejasne zasady zidentyfikowane w POPFNN zapewniają większą przejrzystość procesu decyzyjnego. Te zalety sprawiają, że proponowany system weryfikacji podpisów oparty na rozmytej sieci neuronowej jest szczególnie wydajny i solidny, nawet w przypadku wprawnych fałszerstw. W (Zhou, 1996) POPFNN działa w dwóch podstawowych trybach: trybie uczenia się i trybie klasyfikacji. W trybie uczenia się zbiór próbek sygnatur szkoleniowych jest używany do uczenia POPFNN. Wektory cech wyodrębnione z próbek sygnatur szkoleniowych są wykorzystywane do inicjowania i dostosowywania parametrów POPFNN, w tym funkcji członkostwa, reguł rozmytych i wag łączy. W trybie klasyfikacji POPFNN wykonuje czystą klasyfikację bez samomodyfikacji. Wektory cech wyodrębnione z nieznanych sygnatur są wprowadzane do POPFNN, a odpowiednie dane wyjściowe są uzyskiwane w warstwie wyjściowej POPFNN. (Bromley, 1994) przedstawia algorytm oparty na nowatorskiej sieci NN, zwany "syjamską" siecią neuronową. Sieć ta ma dwa pola wejściowe do porównywania dwóch wzorców i jedno wyjście, którego wartość odpowiada podobieństwu między dwoma wzorcami. Podczas uczenia dwie podsieci wyodrębniają cechy z dwóch sygnatur, podczas gdy łączący się neuron mierzy odległość między dwoma wektorami cech. Szkolenie przeprowadzono z wykorzystaniem zmodyfikowanej wersji BP. Można było nauczyć się wszystkich wag, ale obie podsieci miały identyczne wagi.
PRZYSZŁE TENDENCJE
Pomimo ogromnej pracy wykonanej w dziedzinie weryfikacji podpisów, kilka kwestii pozostaje nadal nierozwiązanych. Nowe rozwiązania tych problemów określą warunki, w jakich będą rozwijane systemy weryfikacji podpisów najbliższej przyszłości. Wybór najbardziej odpowiedniego zestawu cech dla podpisującego jest jedną z istotnych kwestii otwartych, a zastosowanie nowych podejść do klasyfikacji nadal pozostaje otwartym problemem. Ostatnio wykorzystuje się w tym celu algorytmy genetyczne (GA)). Kolejny obiecujący obszar badań dotyczy weryfikacji wieloeksperckiej, która łączy decyzję twardą (Dimauro, 1997) i miękką (Plamondon, 1992), opartą na strategiach równoległych (Qi, 1995), szeregowych (Cardot, 1991) lub hybrydowych (Cordella, 2000). W ramach aplikacji do rozpoznawania tekstu pisanego odręcznie (Heutte, 2004) opracowali system wieloagentowy umożliwiający zarządzanie interakcją pomiędzy różnymi poziomami kontekstowymi interpretacji pisma ręcznego. Środowisko EMAC (Hernoux, 1999) zostało określone na podstawie ograniczeń nałożonych przez system interpretacji pisma ręcznego. W tej pracy przedstawiono tę platformę jako pomoc we wdrażaniu określonych schematów współpracy lub współpracy pomiędzy agentami, którzy przynoszą wyznaczają nowe trendy w automatycznym czytaniu tekstów pisanych odręcznie i mogą zostać wdrożone w systemach automatycznej weryfikacji podpisów. (Balkrishana, 2007) przedstawili niedawno algorytm kodu kolorów, który zajmuje się rozpoznawaniem podpisu, ponieważ rozpoznawaniem podpisu zajmuje się zwykle człowiek. Stąd algorytm symuluje ludzkie zachowanie, aby osiągnąć doskonałość i umiejętności dzięki sztucznej inteligencji. Logika decydująca o zakresie ważności podpisu musi uwzględniać rozpoznawanie wzorców sztucznej inteligencji to nauka zajmująca się opisem lub klasyfikacją pomiarów, zwykle w oparciu o model bazowy. W przyszłości system można skonfigurować przy użyciu sieci neuronowych i bazy reguł Fuzzy Rule, gdzie możliwe jest szkolenie w zakresie rozpoznawania online. Listę firm zajmujących się produkcją systemów weryfikacji podpisów podano w (Kalenova, 2004) wraz z krótkim opisem dostępnych produktów. Choć weryfikacja podpisu nie należy do najbezpieczniejszych rozwiązań biometrycznych, to wykorzystanie jej w praktyce biznesowej już tak nadal uzasadnione. Przede wszystkim ze względu na fakt, że podpis jest de facto środkiem potwierdzenia tożsamości osoby, a zatem zapewni znacznie mniej uciążliwą migrację do zaawansowanej technologii niż jakakolwiek inna możliwość biometryczna. Zatem weryfikacja podpisu ma bardzo duże znaczenie obiecująca przyszłość.
WNIOSEK
Automatyczna weryfikacja podpisu jest bardzo atrakcyjnym problemem dla badaczy. W artykule przedstawiono przegląd podejść do automatycznej weryfikacji podpisu z wykorzystaniem sieci neuronowych. Omówiono główne aspekty związane z procesem szkoleniowym. Chociaż w przypadku niektórych podejść współczynnik fałszywych odrzuceń i fałszywych akceptacji wynosi od 2% do 5%, twórcy systemów nie mogą porównywaćich wyników ze względu na brak powszechnie akceptowanego protokołu badań eksperymentalnych, a także brak dużych, publicznych baz sygnatur. Dla zainteresowanych czytelników udostępniono także przydatną bibliografię
Sieci neuronowe i HOS do oceny jakości energii
WSTĘP
Wykrywanie i klasyfikacja zdarzeń związanych z jakością energii (PQ) zyskuje na znaczeniu ze względu na ogólnoświatowe stosowanie delikatnych urządzeń elektronicznych. Wyładowania atmosferyczne, duże obciążenia przełączające, nieliniowe naprężenia obciążenia, nieodpowiednie lub nieprawidłowe okablowanie i uziemienie lub wypadki z udziałem linii elektrycznych mogą powodować problemy dla wrażliwego sprzętu, jeśli jest on zaprojektowany do pracy w wąskich granicach napięcia lub jeśli nie obejmuje możliwości filtrowania wahań zasilania elektrycznego . Rozwiązanie problemu PQ wymaga gromadzenia i monitorowania długich rekordów danych z systemu dystrybucji energii, wraz ze strategią automatycznego wykrywania i klasyfikacji, która pozwala zidentyfikować przyczynę tych anomalii napięcia. Narzędzia do przetwarzania sygnałów są szeroko stosowane w tym celu i opierają się głównie na analizie widmowej i transformacjach falkowych. Te metody drugiego rzędu, najbardziej znane społeczności naukowej, opierają się na niezależności składowych widmowych i ewolucji widma w dziedzinie czasu. Inne narzędzia to algorytmy oparte na progach, klasyfikatory liniowe i sieci Bayesa. Celem analizy przetwarzania sygnałów jest uzyskanie z badanego zbioru danych wektorów cech, które stanowią dane wejściowe do modułu inteligencji obliczeniowej, którego zadaniem jest klasyfikacja. Niektóre najnowsze prace przynoszą inną strategię, opartą na statystyce wyższego rzędu (HOS), w radzeniu sobie z analizą stanów nieustalonych w ramach analizy PQ i innych dziedzin nauki . Bez zakłóceń kształt fali napięcia o częstotliwości 50 Hz wykazuje zachowanie Gaussa. Odchylenia od Gaussa można wykryć i scharakteryzować za pomocą HOS. Procesy niegaussowskie wymagają charakteryzacji statystycznej trzeciego i czwartego rzędu, aby można je było rozpoznać. Innymi słowy, momenty i kumulanty drugiego rzędu nie mogą być zdolne do różnicowania zdarzeń niegaussowskich. Opisana sytuacja odpowiada problemowi rozróżnienia pomiędzy stanem przejściowym o długim czasie trwania, zwanym uszkodzeniem (w okresie sygnału), a stanem przejściowym o krótkim czasie trwania (25% cyklu). Ten może również natychmiastowo doprowadzić napięcie 50 Hz do zerai ogólnie dramatycznie wpływa na sinusoidę. Wręcz przeciwnie, długotrwały stan przejściowy można uznać za sygnał modulujący (nośną jest sygnał 50 Hz). Te stany nieustalone są z natury niestacjonarne, dlatego w celu uzyskania wiarygodnej charakterystyki niezbędny jest zestaw obserwacji (rejestry próbek). Główny wkład tej pracy polega na zastosowaniu kumulantów centralnych wyższego rzędu do scharakteryzowania zdarzeń PQ, wraz z wykorzystaniem warstwy konkurencyjnej jako narzędzia klasyfikacji. Wyniki pokazują, że na wykresie 2D można rozpoznać dwa różne skupienia powiązane z obydwoma typami stanów nieustalonych. Pomyślne wyniki pozwalają wysnuć wniosek, że fizyczne procesy leżące u podstaw analizowanych stanów nieustalonych generują różnego rodzaju odchylenia od typowych efektów, jakie szum powoduje w sinusoidalnym przebiegu napięcia 50 Hz. Artykuł ma następującą strukturę: Sekcja dotycząca kumulantów wyższego rzędu podsumowuje główne równania kumulantów użyte w artykule. Następnie przypominamy sobie podstawy warstwy konkurencyjnej wraz z zasadą uczenia się Kohonena. Następnie opisuje się doświadczenie i wyciąga wnioski.
KUMULANTY WYŻSZEGO PORZĄDKU
Statystyki wyższego rzędu, zwane kumulantami, służą do wnioskowania o nowych właściwościach danych procesów niegaussowskich . Zależność pomiędzy kumulantami r sygnałów stochastycznych, {x,sub>i}i?[1,r], a ich momentami porządku p, p ≤ r, można obliczyć, korzystając ze wzoru Leonowa-Shiriajewa . Dla stacjonarnego procesu losowego r-tego rzędu {x(t)} kumulant r-tego rzędu definiuje się jako łączną kumulantę r-tego rzędu zmiennych losowych x(t), x(t+τ1), …, x(t+τr-1),

Biorąc pod uwagę ?1=?2=?3=0 w równaniu. (1), mamy kilka szczególnych przypadków:

Równania (2) są pomiarami wariancji, skośności i kurtozy rozkładu statystycznego w kategoriach kumulantów przy zerowych opóźnieniach. Będziemy używać i odnosić się do wielkości znormalizowanych, ponieważ są one niezmienne w zakresie przesunięcia i skali.
WARSTWY KONKURENCYJNE
Neurony w warstwie konkurencyjnej rozdzielają się, aby rozpoznać często prezentowane wektory wejściowe. Funkcja transferu konkurencyjnego przyjmuje wektor wejściowy netto p dla warstwy (każdy neuron konkuruje, aby odpowiedzieć na p) i zwraca na wyjściu wartość 0 dla wszystkich neuronów z wyjątkiem zwycięzcy, który jest powiązany z najbardziej dodatnim elementem wejścia netto. W przypadku obciążenia zerowego neuron, którego wektor wag jest najbliższy wektorowi wejściowemu, ma najmniej ujemne wejście netto i dlatego wygrywa konkurencja, która wyprowadzi liczbę 1. Po przedstawieniu tego zwycięski neuron zbliży się do wejścia. Wagi zwycięskiego neuronu są dostosowywane za pomocą reguły uczenia się Kohonena. Jeśli na przykład wygra i-neuron, elementy i-tego wiersza macierzy wag wejściowych (IW) są korygowane, jak pokazano w równaniu(3):

gdzie p jest wektorem wejściowym, q jest chwilą czasu, a ? jest szybkością uczenia się. Reguła Kohonena pozwala ósemkom neuronu uczyć się wektora wejściowego, dlatego jest przydatna w zastosowaniach rozpoznawania. Zwycięski neuron ma większe szanse wygrać konkurs, gdy następnym razem zostanie zaprezentowany podobny wektor. W miarę prezentowania coraz większej liczby danych wejściowych każdy neuron w warstwie znajdującej się najbliżej grupy wektorów wejściowych wkrótce dostosowuje swój wektor wag w kierunku tych danych wejściowych. Ostatecznie, jeśli jest wystarczająca liczba neuronów, w każdym skupieniu podobnych wektorów wejściowych będzie znajdował się neuron, który po zaprezentowaniu wektora w klastrze wyświetli na wyjściu wartość "1".
WYNIKI EKSPERYMENTALNE
Celem jest rozróżnienie dwóch klas zdarzeń PQ, zwanych długoterminowymi i krótkotrwałymi. Eksperyment składa się z dwóch etapów. Etap ekstrakcji cech opiera się na obliczeniu kumulantów. Współrzędna każdego wektora odpowiada lokalnej maksimum i minimum kumulanty centralnej czwartego rzędu. Po drugie, etap klasyfikacji polega na zastosowaniu warstwy konkurencyjnej do wektorów cech. Używamy dwuneuronowej warstwy konkurencyjnej, która podczas uczenia sieci otrzymuje dwuwymiarowe wejściowe wektory cech. Na etapie ekstrakcji cech analizujemy 16 1000-punktowych rejestrów rzeczywistych. Przed obliczeniami kumulantów, przeprowadzono dwa działania wstępnego przetwarzania próbek sygnałów. Po pierwsze, zostały one znormalizowane, ponieważ wykazują bardzo różne poziomy napięcia. Po drugie, górnoprzepustowy filtr cyfrowy (model Butterwortha piątego rzędu o częstotliwości charakterystycznej 150 Hz) eliminuje składowe o niskiej częstotliwości, które nie są obiektem eksperymentu. To, nawiasem mówiąc, zwiększa niegaussowskie charakterystyki sygnałów, które w rzeczywistości znajdują odzwierciedlenie w kumulantach wyższego rzędu. Na rysunku 1 przedstawiono porównanie obu typów zdarzeń.

Po wstępnej obróbce obliczana jest bateria przesuwających się kumulantów centralnych (2., 3. i 4. rzędu). Każda kumulanta jest obliczana na podstawie 50 punktów; Długość tego okna (50 punktów) została dobrana tak, aby nie była zbyt długa, aby pokryć cały sygnał, ani zbyt krótka. Algorytm oblicza 3 kumulacje centralne na 50 punktów, a następnie przechodzi do kolejnego punktu początkowego; w efekcie mamy w 98% nakładające się okna przesuwne (49/50=0,98). Każde obliczenie zakończoneokno (zwane segmentem) wyświetla 3 kumulanty. Analiza przetwarzania sygnału wskazuje, że sekwencja kumulacyjna drugiego rzędu (wariancja) wyraźnie wskazuje na obecność zdarzenia. Oba typy stanów nieustalonych wykazują rosnącą wariancję w sąsiedztwie zdarzenie PQ, które mają ten sam kształt, ale tylko z jednym maksimum. Wielkość tego maksimum jest zresztą jedyną dostępną cechą, którą można wykorzystać do rozróżnienia różnych zdarzeń z punktu widzenia drugiego rzędu. W wyniku etapu klasyfikacji dwuwymiarowa reprezentacja (2-wymiarowe wektory cech) sugeruje bardzo zrozumiałe wykresy 2-D dla czwartego rzędu. Diagramy trzeciego rzędu nie pokazują zupełnie różnych skupień, ponieważ maksima i minima są podobne. Możliwe jest rozróżnienie zdarzeń PQ z perspektywy trzeciego rzędu, jeśli weźmiemy pod uwagę więcej cech w wektorze wejściowym (być może wektory cech 3-D), takich jak liczba ekstremów (maksima i minima) oraz kolejność, w jakiej maksima i minima pojawiają się wraz ze wzrostem czasu. Przesuwające się kumulanty czwartego rzędu wykazują wyraźne różnice, nie tylko pod względem kształtu wykresów w dziedzinie czasu, ale także różnej lokalizacji minimów, co sugeruje grupowanie punktów w przestrzeni cech 2-D. Rysunek 2 przedstawia przykład porównania sekwencji kumulacyjnej czwartego rzędu dla dwóch typów stanów nieustalonych.

Dla każdego rejestru próbki (rekordu danych) obliczana jest sekwencja przesuwających się kumulantów czwartego rzędu (jak na rysunku 2). Dla każdego rekordu danych wykrywane jest maksimum i minimum i wybierane jako punkt w przestrzeni cech. Na rysunku 3 przedstawiono wyniki etapu treningu z wykorzystaniem reguły Kohonena.

Oś pozioma (pionowa) odpowiada wartościom maksymalnym (minimalnym). Każdy krzyżyk na diagramie odpowiada wektorowi wejściowemu, a okręgi wskazują ostateczną lokalizację wektora wag (po nauczeniu) dla dwóch neuronów warstwy konkurencyjnej. Przed treningiem oba wektory wag wskazywały na gwiazdkę, która jest punktem inicjującym (środkiem interwałów wejściowych). Separacja pomiędzy klasami (odległość międzyklasowa) jest dobrze zdefiniowana. Obydwa typy zdarzeń PQ są grupowane. Prawidłową konfigurację klastrów potwierdzamy podczas symulacji sieci neuronowej, w której uzyskaliśmy przybliżoną dokładność klasyfikacji na poziomie 97 proc. Podczas symulacji nowe sygnały (wybrane losowo z naszej bazy danych) zostały przetworzone przy użyciu tej metodologii. Dokładność wyników klasyfikacji wzrasta wraz z liczbą danych. Aby ocenić wiarygodność statystyk, przeprowadzono test istotności. W rezultacie liczba pomiarów jest znacząco poprawna.
WNIOSEK
W tym artykule zaproponowaliśmy automatyczną metodę wykrywania i klasyfikacji dwóch stanów nieustalonych PQ, nazwanych krótkim i długim. Metoda składa się z dwóch etapów. Pierwsza obejmuje przetwarzanie wstępne (normalizację i filtrowanie) i generuje wektory cech 2-D, z których każda współrzędna odpowiada maksimum i minimum kumulantów centralnych. Drugi etap wykorzystuje sieć neuronową do klasyfikacji sygnałów na dwie grupy. Etap ten ma inny charakter niż ten stosowany w (Gerek i in., 2006) składający się z klasyfikatorów kwadratowych. Konfiguracja klastrów oceniana jest podczas symulacji sieci, w której uzyskaliśmy akceptowalną dokładność klasyfikacji.
System sterowania neuronowego dla pojazdów autonomicznych
WSTĘP
Sieci neuronowe znalazły zastosowanie w wielu zastosowaniach robotycznych , w tym zarówno w manipulatorach, jak i robotach mobilnych. Typowym podejściem jest wykorzystanie sieci neuronowych do nieliniowego modelowania systemów, w tym na przykład uczenia się przednich i odwrotnych modeli instalacji, eliminacji szumów i innych form sterowania nieliniowego . Alternatywnym podejściem jest rozwiązanie konkretnego problemu poprzez zaprojektowanie wyspecjalizowanej architektury sieci neuronowej i/lub reguły uczenia się . Jest oczywiste, że mózgi biologiczne, choć wykazują pewien stopień jednorodności, opierają się na wielu wyspecjalizowanych obwodach zaprojektowanych do rozwiązywania określonych problemów. Interesuje nas zrozumienie, w jaki sposób zwierzęta są w stanie rozwiązywać złożone problemy, takie jak nauka poruszania się w nieznanym środowisku, w celu zastosowania wiedzy z biologii do sterowania robotami . W szczególności w artykule przedstawiono architekturę neuronową, która umożliwia integrację kinematycznego adaptacyjnego neurokontrolera do śledzenia trajektorii i adaptacyjnego neurokontrolera unikania przeszkód dla nieholonomicznych robotów mobilnych. Kinematyczny adaptacyjny neurokontroler działa w czasie rzeczywistym i nie jest nadzorowany sieć neuronowa, która uczy się sterować nieholonomicznym robotem mobilnym w niestacjonarnym środowisku, nazywana siecią samoorganizującego się mapowania kierunku (SODMN) i łączy uczenie asocjacyjne z uczeniem się wektorowej mapy asocjacyjnej (VAM) w celu generowania transformacji pomiędzy współrzędnymi przestrzennymi i prędkościowymi . Transformacje uczone są w fazie uczenia się bez nadzoru, podczas której robot porusza się pod wpływem losowo wybranych prędkości kół. Neurokontroler adaptacyjny do unikania przeszkód to sieć neuronowa, która uczy się kontrolować zachowania unikające w robocie mobilnym w oparciu o formę uczenia się zwierząt znaną jako warunkowanie instrumentalne. Uczenie się, które nie wymaga nadzoru, odbywa się podczas poruszania się robota po zagraconym otoczeniu z przeszkodami. Sieć neuronowa nie wymaga wiedzy o geometrii robota ani o jakości, liczbie czy konfiguracji jego czujników. Skuteczność proponowanej architektury neuronowej jest testowana eksperymentalnie za pomocą robota mobilnego o napędzie różnicowym.
TŁO
Zaproponowano kilka podejść heurystycznych opartych na sieciach neuronowych (NN) do identyfikacji i adaptacyjnego sterowania nieliniowymi układami dynamicznymi . W kołowych robotach mobilnych (WMR) problem śledzenia trajektorii przy zbieżności wykładniczej został rozwiązany teoretycznie przy użyciu sprzężenia zwrotnego stanu zmieniającego się w czasie w oparciu o technikę backsteppingu w . Do śledzenia trajektorii wykorzystano dynamiczną linearyzację ze sprzężeniem zwrotnym stabilizacja postawy systemów robotów mobilnych w formie łańcuchowej . Badanie zachowań autonomicznych stało się aktywnym obszarem badawczym w dziedzinie robotyki. Nawet najprostsze organizmy są zdolne do zachowań niewyobrażalnych dla najbardziej wyrafinowanych maszyn. Kiedy zwierzę musi działać w nieznanym środowisku, musi w jakiś sposób nauczyć się przewidywać konsekwencje własnych działań. Organizmy biologiczne są wyraźnym przykładem tego, że brak uczenia się jest możliwy pomimo trudności, które z inżynierskiego punktu widzenia wydają się nie do pokonania: hałaśliwych czujników, nieznanej kinematyki i dynamiki, statystyk niestacjonarnych i tak dalej. Pokrewną formą uczenia się jest znany jako operant warunkowanie . Chang i Gaudiano (1998) wprowadzają sieć neuronową do unikania przeszkód opartą na modelu warunkowania klasycznego i instrumentalnego. Psychologowie zidentyfikowali warunkowanie klasyczne i instrumentalne jako dwie podstawowe formy uczenia się, które umożliwiają zwierzętom nabycie struktury przyczynowej środowisko. W klasycznym paradygmacie warunkowania uczenie się następuje poprzez wielokrotne łączenie bodźca warunkowego (CS), który zwykle nie ma szczególnego znaczenia dla zwierzęcia, z bodźcem bezwarunkowym (UCS), który ma znaczenie dla zwierzęcia i zawsze powoduje reakcję bezwarunkową (UCR). Reakcja, która pojawia się w CS po warunkowaniu klasycznym, znana jest jako reakcja warunkowa (CR) . Zatem warunkowanie klasyczne jest domniemanym uczeniem się proces umożliwiający zwierzętom rozpoznawanie bodźców informacyjnych w środowisku. W przypadku warunkowania instrumentalnego zwierzę uczy się konsekwencji swoich działań. Mówiąc dokładniej, zwierzę uczy się częściej wykazywać zachowanie, które w przeszłości doprowadziło do nagrody, i rzadziej przejawiać zachowanie, które doprowadziło do kary. W dziedzinie badań sieci neuronowych często sugeruje się, że sieci neuronowe oparte na prawach uczenia się asocjacyjnego mogą modelować mechanizmy warunkowania klasycznego, podczas gdy sieci neuronowe oparte na prawach uczenia się przez wzmacnianie mogą modelować mechanizmy warunkowania instrumentalnego . Uczenie się przez wzmacnianie służy nabywaniu umiejętności nawigacji dla pojazdów autonomicznych i jednocześnie aktualizuje zarówno model pojazdu, jak i optymalne zachowanie . W artykule proponujemy architekturę neuronową inspirowaną neurobiologią, aby pokazać, jak organizm, w tym przypadku robot, może bez nadzoru uczyć się rozpoznawania prostych bodźców w swoim otoczeniu i kojarzenia ich z różnymi działaniami.
ARCHITEKTURA NEURALNEGO SYSTEMU KONTROLI
Rysunek 1 (a) ilustruje proponowaną przez nas architekturę neuronową.

Sterowanie śledzeniem trajektorii bez przeszkód jest realizowane przez SODMN, a sieć neuronowa zachowań biologicznych realizuje zachowanie polegające na unikaniu przeszkód.
Sieć mapowania kierunku samoorganizacji (SODmN)
Transformację kierunków przestrzennych na prędkości kątowe kół wyrażono w formie odwzorowania liniowego i pokazano na rys. 1(b). Błąd przestrzenny jest obliczany w celu uzyskania wektora kierunku przestrzennego (DV). DV jest przekształcany przez elementy sieci mapowania kierunku Viko odpowiedniego wektora kierunku silnika (DVm). Z drugiej strony, jako pole kontekstu zaimplementowano zestaw tonicznie aktywnych komórek hamujących, które otrzymują szeroko zakrojone dane wejściowe określające kontekst działania motorycznego. Pole kontekstowe wybiera elementy Vik na podstawie konfiguracji prędkości kątowych kół. Sygnał GO sterujący prędkością działa jak niespecyficzna bramka multiplikatywna i kontroluje ogólną prędkość ruchu. Sygnał GO jest sygnałem wejściowym z ośrodka decyzyjnego w mózgu i rozpoczyna się od zera przed ruchem, a następnie płynnie rośnie do wartości dodatniej w miarę rozwoju ruchu. Podczas uczenia sygnał GO jest nieaktywny. Aktywność komórek DV i DVm jest reprezentowana w
sieci neuronowej odpowiednio przez wielkości (S1, S2, …, Sm) i (R1, R2,…, Rn). Mapowanie kierunku tworzone jest za pomocą pola komórek z aktywnościami Vik. Każda komórka Vik otrzymuje pełny zestaw wejść przestrzennych Sj, j = 1, …, m, ale łączy się tylko z jedną komórką Ri. Komórki mapujące kierunek (V ∈ Rnxk) obliczają różnicę aktywności pomiędzy wektorami kierunku przestrzennego i motorycznego poprzez informację zwrotną z DVm. Podczas uczenia się różnica ta wpływa na dostosowanie ciężarków. Podczas działania różnica steruje aktywnością DVm do wartości zakodowanej w wyuczonym mapowaniu. Komórka pola kontekstu zatrzymuje się, gdy rozpoznaje na swoich wejściach określony stan prędkości (tj. konfigurację prędkości) i w ten sposób odhamowuje komórki docelowe. Komórki docelowe (komórki mapujące kierunek) są całkowicie wyłączone, gdy ich komórki kontekstu są aktywne (patrz rys. 1 (b)). Każda komórka pola kontekstu rzutuje na zestaw komórek mapujących kierunek, po jednej dla każdej składowej wektora prędkości. Z każdą składową wektora prędkości jest powiązany zestaw komórek mapujących kierunek, po jednej dla każdego kontekstu. Komórka jest "wyłączona" dla zwartego obszaru przestrzeni prędkości. Dla uproszczenia zakłada się, że w danym momencie "wyłączana" jest tylko jedna komórka pola kontekstu. Środkowa komórka pola kontekstu jest "wyłączona", gdy prędkości kątowe znajdują się w środkowym obszarze przestrzeni prędkości. Komórka kontekstu "wyłączona" włącza podzbiór komórek mapujących kierunek poprzez zmienną hamowania ck, podczas gdy komórki kontekstu "włączonego" wyłączają inne podzbiory. Uczenie się uzyskuje się poprzez zmniejszenie wag w proporcji do iloczynu aktywności presynaptycznej i postsynaptycznej. Trening odbywa się poprzez generowanie przypadkowych ruchów i wykorzystanie uzyskanych prędkości kątowych i zaobserwowanych prędkości przestrzennych robota mobilnego jako wektorów szkoleniowych dla sieci mapowania kierunków.
Sieć neuronowa dla zachowań unikających (NNAB)
Grossberg zaproponował model warunkowania klasycznego i instrumentalnego, który został zaprojektowany w celu uwzględnienia różnorodnych danych behawioralnych dotyczących uczenia się u kręgowców . Nasza implementacja opiera się na obwodzie kondycjonowania Grossberga, który jest bardzo podobny do obwodu Grossberga i Levine′a (1987) oraz Changa i Gaudiano (1998) i jest pokazany na rysunku 2.

W tym modelu bodźce sensoryczne (zarówno CS, jak i UCS) są przechowywane w pamięci krótkotrwałej (STM) w populacji oznaczonej S, która obejmuje interakcje konkurencyjne, aby zapewnić wzmocnienie kontrastu najbardziej znaczących wskazówek i przechowywanie ich w STM, podczas gdy mniej istotne sygnały są stłumiony. Populacja S jest modelowana jako powtarzające się pole konkurencyjne w uproszczonej wersji dyskretnej, która usuwa nieodłączny szum, skutecznie normalizuje i zwiększa kontrast po aktywacji czujników ultradźwiękowych. W prezentowanym modelu węzły CS odpowiadają aktywacji z czujników ultradźwiękowych robota. W sieci Ii reprezentuje wartość czujnika, która koduje obiekty bliższe o dużych wartościach i obiekty odległe o małych wartościach. Sieć nie wymaga znajomości geometrii robota mobilnego ani jakości, liczby czy rozmieszczenia czujników w ciele robota. Węzeł napędowy D odpowiada Nagrodzie/Kara - element warunkowania instrumentalnego (zwierzę/robot uczy się konsekwencji swoich własnych działań). Uczenie się może nastąpić tylko wtedy, gdy węzeł napędowy jest aktywny. Aktywacja węzła napędowego D jest określana na podstawie sumy ważonej wszystkich wejść CS plus wejścia UCS, które, jak się zakłada, ma dużą, stałą siłę połączenia. Węzeł napędowy D jest aktywny w momencie zderzenia robota z przeszkodą. Wówczas bodźcowi bezwarunkowemu (USC) odpowiada w tym przypadku kolizja wykryta przez robota mobilnego. Aktywacja węzła napędowego i węzłów czuciowych zbiega się w populacji komórek poliwalentnych P. Komórki poliwalentne wymagają zbieżności dwóch rodzajów sygnałów wejściowych, aby stać się aktywne. W szczególności każda komórka wielowartościowa otrzymuje sygnał wejściowy tylko z jednego węzła czuciowego, a wszystkie komórki wielowartościowe otrzymują również sygnał wejściowy z węzła napędowego D. Wreszcie neurony (xmi) reprezentują odpowiedź warunkową lub nieuwarunkowaną, a zatem są połączone z układem motorycznym. Populacja motoryczna składa się z węzłów (tj. neuronów) kodujących pożądane prędkości kątowe unikania. Podczas kierowania robotem aktywacja rozkłada się w sposób Gaussa ze środkiem na żądaną prędkość kątową unikania. Zastosowanie Gaussa prowadzi do płynnych przejść prędkości kątowej nawet przy niewielkiej liczbie węzłów. Wynikiem populacji prędkości kątowej jestrozkładane przez SODMN na prędkości kątowe lewego i prawego koła. Do określenia maksymalnej możliwej prędkości można zastosować człon wzmocnienia. W NNAB czujniki zbliżeniowe początkowo nie przekazują aktywności do populacji silników, ponieważ początkowe wagi są małe lub zerowe. Robot jest szkolony poprzez umożliwienie mu wykonywania przypadkowych ruchów w zagraconym otoczeniu. Ilekroć robot podczas jednego z tych ruchów zderzy się z przeszkodą (lub zbliży się bardzo blisko niej), aktywne będą węzły odpowiadające największym (najbliższym) pomiarom czujnika zbliżeniowego tuż przed kolizją. Aktywacja węzła napędowego D pozwala na dwa różne rodzaje uczenia się: uczenie się, które łączy węzły czuciowe (podczerwień lub ultradźwięki) z węzłem napędowym (kolizja) oraz poznanie wzorca prędkości kątowej istniejącego tuż przed zderzeniem. Pierwszy typ uczenia się opiera się na prawie uczenia się asocjacyjnego z zanikiem. Podstawowym celem tego schematu uczenia się jest zapewnienie, że uczenie nastąpi tylko dla tych węzłów CS, które były aktywne w pewnym oknie czasowym przed kolizją (UCS). Drugi rodzaj uczenia, który również ma charakter asocjacyjny, ale ma charakter hamujący, służy do mapowania aktywacji czujników na mapę prędkości kątowej. Korzystając z prawa uczenia się hamującego, komórka wielowartościowa odpowiadająca każdemu węzłowi sensorycznemu uczy się generować wzór hamowania odpowiadający profilowi aktywności aktywnemu w momencie zderzenia. Po zakończeniu uczenia się mapa prędkości kątowej jest aktywowana przez dwie składowe (rysunek 3).

Składowa pobudzająca, generowana bezpośrednio przez układ sensoryczny, odzwierciedla prędkość kątową niezbędną do dotarcia do danego celu przy braku przeszkód. Druga składowa hamująca, generowana przez model kondycjonujący w odpowiedzi na wykryte przeszkody, odsuwa robota od przeszkód w wyniku aktywacji sygnałów sensorycznych w obwodzie kondycjonującym.
WYNIKI EKSPERYMENTALNE
Zaproponowany algorytm sterowania zaimplementowano na robocie mobilnym z Politechniki w Kartagenie (UPCT) o nazwie "CHAMAN". Platforma posiada dwa koła napędowe (z tyłu) osadzone na tej samej osi oraz dwa pasywne koła podporowe (w calach przód) o swobodnej orientacji. Dwa koła napędowe są niezależnie napędzane przez dwa silniki prądu stałego, aby zapewnić ruch i orientację. Algorytmy sterujące wysokiego poziomu (SODMN i NNAB) są napisane w VC++ i uruchamiane z czasem próbkowania 10 ms na zdalnym serwerze (procesor Pentium IV). Warstwa kontrolna niższego poziomu jest odpowiedzialna za wykonywanie poleceń prędkości wysokiego poziomu. Składa się z cyfrowego procesora sygnałowego (DSP) Texas Instruments TMS320C6701. Rysunek 4 przedstawia zachowania związane z podejściem i śledzenie trajektorii przez robota mobilnego względem trajektorii odniesienia. Rysunek 5 ilustruje działanie robota mobilnego w obecności kilku przeszkód.


Robot mobilny rozpoczyna pracę od pozycji początkowej oznaczonej X i osiąga żądaną pozycję. Podczas ruchów, kiedykolwiek robot mobilny zbliża się do przeszkody, profil hamowania z obwodu kondycjonującego (NNAB) zmienia wybraną prędkość kątową i powoduje, że robot mobilny odwraca się od przeszkody.
PRZYSZŁE TENDENCJE
Systemy sterowania robotami mają tendencję do rozumienia i naśladowania sposobu, w jaki systemy biologiczne uczą się i ewoluują, aby rozwiązywać złożone problemy w nieznanym środowisku. Badane są proste zwierzęta (np. kraby, owady, skorpiony i inne) w celu sformalizowania solidnych modeli neuronowych układu lokomocyjnego robotów. U ludzi zdekodowane zachowania neuronowe związane z aktywnością neuronalną układu korowego zwykle mają zastosowanie w protezach robotycznych do kontroli ruchu. Sieci neuronowe i inne techniki biomimetyczne z naciskiem na nawigację i kontrolę są wykorzystywane do działania w czasie rzeczywistym przy jedynie minimalnych założeniach dotyczących robotów lub środowiska, a które w razie potrzeby mogą się uczyć przy niewielkim lub żadnym nadzorze zewnętrznym. W tym artykule zaproponowany system sterowania neuronowego może zostać zastosowany w zastosowaniach podwodnych. W takim przypadku czujniki ultradźwiękowe zastąpią czujniki sonarowe. Zaproponowana architektura neuronowa uczy się prowadzenia reaktywnej i adaptacyjnej nawigacji w środowiskach niestacjonarnych.
WNIOSEK
W tym artykule zaimplementowaliśmy architekturę neuronową do śledzenia trajektorii i zachowań unikających robota mobilnego. Opracowano inspirowaną biologią sieć neuronową do śledzenia zasięgu przestrzennego. Ta sieć neuronowa jest zaimplementowana jako kinematyczny adaptacyjny neurokontroler. SODMN wykorzystuje pole kontekstowe do uczenia się mapowania kierunku pomiędzy współrzędnymi prędkości przestrzennej i kątowej. Wydajność tej sieci neuronowej została z powodzeniem zademonstrowana w wynikach eksperymentów dotyczących śledzenia trajektorii i zasięgu robota mobilnego. Zachowania polegające na unikaniu przeszkód zostały zaimplementowane przez sieć neuronową, która opiera się na formie uczenia się zwierząt zwanej warunkowaniem instrumentalnym. Robot mobilny o napędzie różnicowym przetestował eksperymentalnie skuteczność proponowanej sieci neuronowej w zakresie zachowań unikowych.
Selekcja cech
WSTĘP
Wiele dyscyplin naukowych wykorzystuje procesy i techniki modelowania i symulacji w celu wdrożenia nieliniowego odwzorowania między zmiennymi wejściowymi i wyjściowymi dla badanego systemu. Każda zmienna, która pomaga rozwiązać problem, może być traktowana jakodane wejściowe. Idealnie, każdy klasyfikator lub regresor powinien być w stanie wykryć ważne cechy i odrzucić cechy nieistotne, a co za tym idzie, etap wstępnego przetwarzania w celu redukcji wymiarowości nie powinien być konieczny. Niemniej jednak, w wielu przypadkach redukcja wymiarowości problemu ma pewne zalety , takie jak:
o Poprawa wydajności. Złożoność większości algorytmów uczenia się zależy od liczby próbek i cech (przekleństwo wymiarowości). Zmniejszając liczbę cech, zmniejsza się również wymiarowość, co może zaoszczędzić zasoby obliczeniowe - takie jak pamięć i czas - oraz skrócić czas uczenia i testowania.
o Kompresja danych. Nie ma potrzeby pobierania i przechowywania niepotrzebnej cechy.
o Zrozumienie danych. Redukcja wymiarowości ułatwia zrozumienie i wizualizację danych.
o Prostota. Prostsze modele są zazwyczaj bardziej odporne na błędy w przypadku małych zbiorów danych.
Istnieją dwie główne metody redukcji wymiarowości: ekstrakcja cech i selekcja cech. W tym rozdziale proponujemy przegląd różnych algorytmów selekcji cech (FS), w tym ich głównych podejść: filtrowania, wrapperowania i hybrydowego - połączenia filtra i wrappera.
TŁO
Ekstrakcja cech i selekcja cech to główne metody redukcji wymiarowości. W ekstrakcji cech celem jest znalezienie nowego zestawu r wymiarów, który jest kombinacją n wymiarów oryginalnych. Najbardziej znaną i najczęściej stosowaną metodą ekstrakcji cech bez nadzoru jest analiza głównych składowych (PCA); powszechnie stosowanymi metodami nadzorowanymi są liniowa analiza dyskryminacyjna (LDA) i metoda najmniejszych kwadratów cząstkowych (PLS). W selekcji cech, podzbiór r istotnych cech jest wybierany ze zbioru n, którego pozostałe cechy są ignorowane. Jeśli chodzi o zastosowaną funkcję oceny, podejścia FS można głównie sklasyfikować jako modele filtrujące lub modele wrapperowe . Modele filtrujące opierają się na ogólnych cechach danych treningowych w celu wybrania cech, podczas gdy modele wrapperowe wymagają z góry określonego algorytmu uczenia się w celu zidentyfikowania cech do wybrania. Modele wrapperowe zazwyczaj dają lepsze wyniki, ale gdy liczba cech jest duża, modele filtrujące są zazwyczaj wybierane ze względu na ich wydajność obliczeniową. Aby połączyć zalety obu modeli, niedawno zaproponowano algorytmy hybrydowe .
SELEKCJA CECH
Zalety opisane we Wprowadzeniu wskazują na znaczenie redukcji wymiarowości. Selekcja cech jest również przydatna, gdy zostaną przyjęte następujące założenia:
o Istnieją dane wejściowe, które nie są wymagane do uzyskania danych wyjściowych.
o Istnieje wysoka korelacja między niektórymi cechami wejściowymi.
Algorytm selekcji cech (FSA) poszukuje optymalnego zestawu cech, a w konsekwencji paradygmatem opisującym FSA jest przeszukiwanie heurystyczne. Ponieważ każdy stan przestrzeni przeszukiwania jest podzbiorem cech, FSA można scharakteryzować za pomocą następujących czterech właściwości :
o Stan początkowy. Może to być pusty zbiór cech, cały zbiór lub dowolny stan losowy.
o Strategia przeszukiwania. Chociaż wyczerpujące przeszukiwanie prowadzi do optymalnego zbioru cech, związane z nim koszty obliczeniowe i czasowe są wysokie, gdy liczba cech jest duża. W związku z tym stosuje się różne strategie przeszukiwania, aby zidentyfikować dobry zbiór cech w rozsądnym czasie.
o Funkcja oceny używana do określenia jakości każdego zestawu cech. Jakość podzbioru cech zależy od miar. Zgodnie z literaturą, zastosowano następujące miary: miary informacji, miary odległości, miary zależności, miary spójności i miary dokładności.
o Kryterium zatrzymania. Należy ustalić punkt końcowy; na przykład proces powinien się zakończyć, jeśli funkcja oceny nie ulegnie poprawie po dodaniu/usunięciu nowej cechy. Pod względem złożoności metod wyszukiwania istnieją trzy główne podgrupy :
o Strategie wykładnicze obejmujące wyczerpujące przeszukiwanie wszystkich dopuszczalnych rozwiązań. Wyczerpujące przeszukiwanie gwarantuje identyfikację optymalnego podzbioru cech, ale charakteryzuje się wysokim kosztem obliczeniowym. Przykładami są algorytmy rozgałęzienia i ograniczeń.
o Strategie sekwencyjne oparte na lokalnym przeszukiwaniu rozwiązań zdefiniowanych przez bieżący stan rozwiązania. Przeszukiwanie sekwencyjne nie gwarantuje optymalnego wyniku, ponieważ optymalne rozwiązanie może znajdować się w obszarze przestrzeni wyszukiwania, który nie jest przeszukiwany.
Jednak w porównaniu z wyszukiwaniem wykładniczym, strategie sekwencyjne charakteryzują się znacznie niższym kosztem obliczeniowym. Najbardziej znanymi strategiami są sekwencyjny wybór w przód i sekwencyjny wybór wstecz (odpowiednio SFS i SBS). SFS rozpoczyna od pustego zestawu cech i dodaje je pojedynczo, podczas gdy SBS rozpoczyna od pełnego zestawu i usuwa je pojedynczo. Cechy są dodawane lub usuwane na podstawie ulepszeń funkcji oceny. Podejścia te nie uwzględniają interakcji między cechami,tj. cecha sama w sobie może nie redukować błędu, ale poprawę można osiągnąć poprzez powiązanie jej z inną cechą. Wyszukiwanie zmienne rozwiązuje ten problem częściowo, ponieważ liczba cech uwzględnianych i/lub usuwanych na każdym etapie nie jest stała. Inne podejście (Sánchez i in., 2006) wykorzystuje wskaźniki wrażliwości (znaczenie każdej cechy jest wyrażane w postaci wariancji) do kierowania procesem eliminacji wstecznej, w którym kilka cech jest odrzucanych w jednym kroku.
o Algorytmy losowe, które wykorzystują losowość, aby uniknąć lokalnych rozwiązań optymalnych i umożliwić tymczasowe przejście do innych stanów z gorszymi rozwiązaniami. Przykładami są symulowane wyżarzanie i algorytmy genetyczne. Najpopularniejsza klasyfikacja FSA, która odnosi się do funkcji oceny, uwzględnia trzy (Blum i Langley, 1997) lub dwie ostatnie (Kohavi i John, 1997) grupy, jak następuje:
o Metody wbudowane. Algorytm indukcji jest jednocześnie FSA. Przykładami tej metody są drzewa decyzyjne, takie jak drzewa klasyfikacyjne i regresyjne (CART) oraz sztuczne sieci neuronowe (ANN).
o Metody filtrowania. Selekcja jest przeprowadzana jako etap wstępnego przetwarzania bez algorytmu indukcji (rysunek 1).

Ogólne charakterystyki danych uczących są wykorzystywane do selekcji cech (na przykład odległości między klasami lub zależności statystycznych). Model ten jest szybszy niż podejście opakowujące (opisane poniżej) i zapewnia lepszą generalizację, ponieważ działa niezależnie od algorytmu indukcji. Jednakże ma on tendencję do selekcji podzbiorów o dużej liczbie cech (nawet wszystkich cech), dlatego do wyboru podzbioru wymagany jest próg.
o Metody opakowujące. Modele wrapperowe wykorzystują algorytm indukcji do oceny każdego podzbioru cech, tj. algorytm indukcji jest częścią funkcji oceny w modelu wrapperowym, co oznacza, że model ten jest dokładniejszy niż model filtru. Uwzględnia on również techniki, takie jak walidacja krzyżowa, które zapobiegają nadmiernemu dopasowaniu. Modele wrapperowe są jednak bardzo czasochłonne, co ogranicza ich zastosowanie w przypadku niektórych zbiorów danych. Co więcej, chociaż mogą dawać dobre wyniki z wbudowanym algorytmem indukcji, mogą działać słabo z algorytmem alternatywnym.
,br>
Metody hybrydowe łączące metody filtrowania i wrapperowe cieszą się ostatnio dużym zainteresowaniem w literaturze dotyczącej systemów FS . Chociaż kolejne sekcje tego rozdziału poświęcone są głównie metodom filtrowania i wrapperowym, zawarto w nich również krótki przegląd najnowszych metod hybrydowych.
Metody filtrowania
W literaturze opisano szereg reprezentatywnych algorytmów filtrowania, takich jak statystyka ?2, zysk informacji czy selekcja cech oparta na korelacji (CFS). Dla pełnego obrazu odniesiemy się do dwóch klasycznych algorytmów (FOCUS i RELIEF) oraz opiszemybardzo niedawno opracowane metody filtrowania (FCBF i INTERACT). Wyczerpujące omówienie metod filtrowania znajduje się w pracy Guyon i in. (2006) - w tym metody takie jak Lasy Losowe (RF), zespół klasyfikatorów drzew.
FOCUS
W metodzie FOCUS oceniane są wszystkie podzbiory cech o rosnącej wielkości, aż do znalezienia odpowiedniego podzbioru. Podzbiór cech q jest uważany za odpowiedni, jeśli nie istnieje para przykładów o różnych wartościach klas i takich samych wartościach dla wszystkichcech w q. Następcą tego algorytmu jest FOCUS_2 , który przycina przestrzeń poszukiwań, oceniając w ten sposób tylko obiecujące podzbiory. FOCUS_2 jest zatem znacznie szybszy niż FO-CUS. Jednak użycie obu algorytmów w domenach o dużej liczbie cech może być obliczeniowo niewykonalne. W związku z tym heurystyki wyszukiwania są stosowane w różnych wersjach algorytmu, co prowadzi do dobrych, ale niekoniecznie optymalnych rozwiązań.
RELIEF
Algorytm RELIEF szacuje jakość atrybutów na podstawie tego, jak dobrze ich wartości rozróżniają instancje znajdujące się blisko siebie. W tym celu, biorąc pod uwagę losowo wybraną instancję xs={x1s,x2s,…xns}, RELIEF wyszukuje dwóch najbliższych sąsiadów: jednego z tej samej klasy, zwanego najbliższym trafieniem H, i drugiego z innej klasy, zwanego najbliższym pominięciem M. Następnie aktualizuje oszacowanie jakości dla wszystkich cech, w zależności od wartości xs, M i H. RELIEF może obsługiwać cechy dyskretne i ciągłe, ale jest ograniczony do problemów dwuklasowych. Rozszerzenie - ReliefF - nie tylko radzi sobie z problemami wieloklasowymi, ale jest również bardziej odporne i zdolne do radzenia sobie z niekompletnymi i zaszumionymi danymi. ReliefF został następnie zaadaptowany do problemów klas ciągłych (regresji), co zaowocowało powstaniem algorytmu RReliefF .
FCBF i INTERAKCJA
Metoda szybkiego filtru opartego na korelacji (FCBF) opiera się na symetrycznej niepewności (SU), którą definiuje się jako stosunek zysku informacyjnego do entropii dwóch cech, x i y:

Metoda ta została opracowana dla danych o dużej liczbie wymiarów i okazała się skuteczna w usuwaniu zarówno cech nieistotnych, jak i redundantnych. Nie uwzględnia ona jednak interakcji między cechami. Algorytm INTERACT wykorzystuje tę samą miarę dobroci, SU, ale uwzględnia również wkład spójności (wkład c). Dzięki temu może obsługiwać interakcję cech i skutecznie wybierać cechy istotne.
Metody opakowujące
Ideą podejścia opakowujące jest wybór podzbioru cech za pomocą algorytmu uczącego się jako części funkcji oceny (rysunek 2).

Zamiast wykorzystywania wystarczalności podzbioru, entropii lub innej jawnie zdefiniowanej funkcji oceny, do kierowania wyszukiwaniem używana jest funkcja typu "czarna skrzynka". Funkcja oceny dla każdego kandydującego podzbioru cech zwraca oszacowanie jakości modelu, które jest indukowane przez algorytm uczący się. Może to być dość czasochłonne, ponieważdla każdego kandydującego podzbioru cech ocenianego podczas wyszukiwania, algorytm uczenia docelowego jest zazwyczaj stosowany kilka razy (np. w przypadku 10-krotnej walidacji krzyżowej używanej do oszacowania jakości modelu). Poniżej krótko opisujemy kilka algorytmów wyboru podzbioru cech - opracowanych w uczeniu maszynowym - opartych na podejściu wrapperowym. Literatura w tym obszarze jest obszerna, dlatego skupimy się tylko na najbardziej reprezentatywnych modelach wrapperowych. Interesujące badanie podejścia wrapperowego przeprowadzili Kohavi i John (1997). Oprócz wprowadzenia pojęcia silnej i słabej istotności cech, autorzy ci pokazali wyniki osiągnięte przez różne algorytmy indukcyjne (ID3, C4.5 i naiwny Bayes) w kilku metodach wyszukiwania (najlepszy pierwszy, wspinaczka górska itp.). Aha i Bankert (1995) zastosowali podejście wrapperowe w uczeniu opartym na instancjach i zaproponowali nową strategię wyszukiwania, która wykonuje przeszukiwanie wiązek przy użyciu pewnego rodzaju eliminacji wstecznej; Oznacza to, że zamiast zaczynać od pustego podzbioru cech, wyszukiwanie losowo wybiera ustaloną liczbę podzbiorów cech i rozpoczyna od najlepszego z nich. Caruana i Freitag (1994) opracowali metodę selekcji podzbioru cech typu wrapper do indukcji drzewa decyzyjnego, proponując dwukierunkową wspinaczkę po wzniesieniach dla przestrzeni cech - jako bardziej skuteczną niż selekcja w przód lub w tył. Algorytmy genetyczne zostały szeroko przyjęte do wyszukiwania najlepszego podzbioru cech w sposób wrapper . Metody selekcji cech wykorzystujące maszyny wektorów nośnych (SVM) przyniosły zadowalające rezultaty . SVM są również łączone z innymi technikami w celu implementacji selekcji cech . Kim i inni (2003) wykorzystują sztuczne sieci neuronowe (ANN) do predykcji zachowań klientów oraz algorytm ELSA (Ewolucyjny Algorytm Selekcji Lokalnej) do wyszukiwania obiecujących podzbiorów cech.
Metody hybrydowe
Podczas gdy koszt obliczeniowy związany z modelem wrapperowym sprawia, że jest on niewykonalny w przypadku dużej liczby cech, to w przypadku modelu filtrującego jego wydajność jest niezadowalająca. Model hybrydowy stanowi dobre połączenie obu podejść, które rozwiązuje te problemy. Metody hybrydowe wykorzystują filtr do generowania uszeregowanej listy cech. Na podstawie tak zdefiniowanej kolejności, zagnieżdżone podzbiory cech są generowane i obliczane przez maszynę uczącą się, tj. zgodnie z podejściem wrapperowym .Główne cechy modelu hybrydowego przedstawiono na rysunku 3.

Jednym z pierwszych zaproponowanych podejść hybrydowych było podejście Yuan i in. z 1999 roku. Od tego czasu model hybrydowy skupił uwagę społeczności badawczej i do tej pory opracowano wiele modeli hybrydowych, które rozwiązują różnorodne problemy, takie jak wykrywanie włamań, kategoryzacja tekstu itp. Jako połączenie modeli filtrów i opakowań, istnieje wiele metod hybrydowych, dlatego nie jest możliwe uwzględnienie ich wszystkich, dlatego odniesiemy się do kilku interesujących. Niektóre metody hybrydowe wykorzystujące SVM przedstawiono w Guyon (2006), rozdziały 20 i 22. Shazzad i Park (2005) badają szybką metodę hybrydową - połączenie selekcji cech opartej na korelacji, maszyny wektorów nośnych i algorytmu genetycznego - w celu określenia optymalnego zestawu cech. Model selekcji cech oparty zarówno na teorii informacji, jak i testach statystycznych przedstawiono przez Sebbana i Nocka (2002). Zhu (2007) włącza metodę rankingu filtrów do algorytmu genetycznego w celu poprawy wydajności klasyfikacji i przyspieszenia procesu wyszukiwania.
PRZYSZŁE TRENDY
Selekcja cech to obszerny temat, którego nie sposób omówić w krótkim rozdziale. Aby wskazać nowe zagadnienia w tym obszarze, odsyłamy czytelnika do sugestii Guyona i in. (2006), podsumowanych następująco:
o Selekcja zmiennych bez nadzoru. Chociaż niniejszy rozdział koncentruje się na nadzorowanej selekcji cech, kilku autorów podjęło próby wdrożenia selekcji cech w zastosowaniach klastrowania . W przypadku zadań uczenia nadzorowanego, można wstępnie przefiltrować zbiór najbardziej istotnych zmiennych względem kryterium, które nie wykorzystuje y, aby zminimalizować problem nadmiernego dopasowania.
o Wybór przykładów. Błędnie oznaczone przykłady mogą prowadzić do wyboru niewłaściwych zmiennych, dlatego korzystniejszy może być wspólny wybór zarówno zmiennych, jak i przykładów.
o Inżynieria wsteczna systemu. Niniejszy rozdział koncentruje się na problemie wyboru cech użytecznych do zbudowania dobrego predyktora. Wyjaśnienie zależności przyczynowych między zmiennymi i inżynieria wsteczna systemu, który wygenerował dane, to znacznie trudniejsze zadanie, wykraczające poza zakres tego rozdziału .
WNIOSKI
Selekcja cech do klasyfikacji i regresji jest ważnym tematem badań w uczeniu maszynowym. Obejmuje wiele różnych dziedzin, takich jak na przykład kategoryzacja tekstu, wykrywanie włamań i dane z mikromacierzy. W niniejszym badaniu dokonano przeglądu kluczowych algorytmów stosowanych do wyboru cech, w tym podejść filtrujących, wrapperowych i hybrydowych. Przegląd ten nie ma charakteru wyczerpującego i ma jedynie na celu przedstawienie aktualnego stanu wiedzy w tej dziedzinie. Większość algorytmów selekcji cech prowadzi do znacznej redukcji wymiarowości danych bez utraty wydajności uzyskanych modeli. Wybór między podejściami zależy od rozpatrywanego problemu. Zastosowanie podejścia filtrującego jest akceptowalne obliczeniowo, ale bardziej złożone podejście typu wrapper zazwyczaj zapewnia większą dokładność wyniku końcowego. Podejście filtrujące jest bardzo elastyczne, ponieważ można użyć dowolnego algorytmu uczenia się celu. Jest ono również szybsze niż podejście typu wrapper. To drugie z kolei jest bardziej zależne od algorytmu uczenia się, ale proces selekcji jest lepszy. Podejście hybrydowe daje nadzieję na poprawę wyników pod względem dokładności klasyfikacji, a także identyfikacji istotnych atrybutów do analizy.
Systemy interaktywne i źródła niepewności
WSTĘP
Współczesne środowisko e-commerce wymaga, aby systemy interaktywne wykazywały takie zdolności, jak autonomia, adaptacyjne i oparte na współpracy zachowania oraz zdolność wnioskowania. Zdolności te opierają się na wiedzy o użytkownikach i zadaniach, które mają oni do wykonania. Aby dostosować dane wejściowe i zadania użytkowników, system interaktywny musi być w stanie ustalić zbiór założeń dotyczących profili użytkowników i charakterystyki zadań, które często określa się mianem modeli użytkowników. Jednak, aby opracować model użytkownika, system interaktywny musi analizować dane wejściowe użytkowników i rozpoznawać zadania oraz ostateczne cele, które użytkownicy próbują osiągnąć, co może wiązać się z dużą ilością niepewności. Niepewność odnosi się do zbioru wartości dotyczących danego założenia, którego nie można określić podczas sesji dialogowej. W rzeczywistości problem niepewności w procesach wnioskowania jest złożony i trudny. Informacje dostępne do budowy i wnioskowania modelu użytkownika są często niepewne, niekompletne, a nawet niejasne. Propagacja takich danych w modelu wnioskowania jest również trudna do przewidzenia i kontrolowania. Dlatego umiejętność radzenia sobie z niepewnością ma kluczowe znaczenie dla sukcesu każdego systemu zarządzania wiedzą. Obecnie toczy się ożywiona debata na temat tego, jak najlepiej reprezentować i przetwarzać niepewność w systemach opartych na wiedzy. Debata ta ma ogromne znaczenie, ponieważ dotyczy nie tylko konstrukcji systemów opartych na wiedzy, ale także koncentruje się na ludzkim myśleniu, w którym większość decyzji podejmowana jest w warunkach niepewności. Niniejszy rozdział przedstawia i omawia niepewność w kontekście modelowania użytkowników w systemach interaktywnych. Przedstawiono podstawowe rozróżnienia między różnymi rodzajami niepewności. Celem jest przedstawienie analitycznego przeglądu i perspektywy dotyczącej tego, jak i gdzie powstają niepewności oraz głównych metod radzenia sobie z nimi.
Źródła niepewności
Interaktywne systemy oparte na modelu użytkownika borykają się z problemami niepewności w odniesieniu do reguły odniesienia, faktów i języków reprezentacji. Nie ma powszechnie akceptowanej definicji dotyczącej obecności niepewności w modelowaniu użytkownika. Jednak naturę niepewności w modelu użytkownika można zbadać poprzez jej pochodzenie. Niepewność może wynikać z różnych źródeł. Wielu autorów podkreśliło potrzebę rozróżnienia rodzajów i źródeł niepewności. Niektóre z głównych źródeł to:
(1) Nieprecyzyjne i niekompletne informacje uzyskane z danych wprowadzonych przez użytkownika. Ten typ źródła jest związany z wiarygodnością informacji, która obejmuje następujące aspekty:
o Niepewne lub nieprecyzyjne informacje występują w wiedzy faktograficznej . Zawartość modelu użytkownika obejmuje czynniki niepewne. Na przykład system może chcieć stwierdzić: "Jest mało prawdopodobne, aby ten użytkownik był początkującym programistą". Tego rodzaju stwierdzenie można traktować jako element wiedzy. Jednakże jest to niepewne i wydaje się trudne do znalezienia liczbowego opisu niepewności w tym stwierdzeniu (tj. brak odpowiedniej przestrzeni prób, w której można by nadać temu stwierdzeniu znaczenie statystyczne, jeśli rozważy się metodę statystyczną do uchwycenia niepewności).
o Domyślne informacje często wprowadzają niepewne czynniki do procesów wnioskowania . Na przykład system stereotypów niesie ze sobą rozległe domyślne założenia dotyczące użytkownika. Niektóre założenia mogą ulegać zmianom w miarę postępu interakcji.
o Niepewność pojawia się w wyniku źle zdefiniowanych pojęć w obserwacjach lub z powodu niedokładności i niskiej wiarygodności pomiaru. Na przykład szybkość pisania użytkownika może być traktowana jako miara umiejętności edycji plików przez użytkownika. Jednak w niektórych zastosowaniach może to być wątpliwe.
o Niepewny wyjątek od ogólnych założeń dotyczących wykonywania pewnych czynności w pewnych okolicznościach może powodować konflikty w procesach wnioskowania.
(2) Niedokładny język, za pomocą którego przekazywane są informacje. Drugim źródłem niepewności jest inherentna niedokładność lub nieścisłość języków reprezentacji. Niedokładność ta występuje zarówno w językach naturalnych, jak i w językach reprezentacji wiedzy. Zaproponowano klasyfikację trzech rodzajów niedokładności w języku naturalnym . Pierwszym jest ogólność, w której słowo odnosi się do wielości obiektów w danym obszarze lub odniesieniu. Na przykład słowo "stół" może odnosić się do obiektów różniących się rozmiarem, kształtem, materiałem i funkcjami. Drugim rodzajem dokładności językowej jest dwuznaczność, która pojawia się, gdy ograniczona liczba alternatywnych znaczeń ma tę samą formę fonetyczną (np. bank). Trzecim jest niejasność, w której nie ma precyzyjnych granic znaczenia słowa (np. stary, bogaty). W językach reprezentacji wiedzy stosowanych w systemach modelowania użytkowników, jeśli reguły nie są wyrażone w języku formalnym, ich znaczenia zazwyczaj nie można dokładnie zinterpretować. Problem ten został częściowo rozwiązany przez teorię rozumowania przybliżonego. Zasadniczo, twierdzenie (np. fakt, zdarzenie) jest niepewne, jeśli dotyczy zmiennej ciągłej. Należy zauważyć, że dokładne założenie może być niepewne (np. użytkownik jest w stanie nauczyć się tego pojęcia), a założenie absolutnie pewne może być językowo niedokładne (np. użytkownik zna to pojęcie).
(3) Agregacja lub podsumowanie informacji. Trzeci rodzaj źródła niepewności wynika z agregacji informacji z różnych źródeł wiedzy lub ekspertyzy . Agregacja informacji niesie ze sobą kilka potencjalnych problemów, które omówiono w (Chen i Nocio 1997).
(4) Deformacja podczas transferu wiedzy. Może nie być semantycznej zgodności między jednym językiem reprezentacji a drugim. Możliwe jest nawet, że nie ma odpowiedniej reprezentacji dla określonej wiedzy, na przykład pomiaru obciążenia psychicznego użytkownika. To sprawia, że deformacja transformacji jest nieunikniona. Ponadto czynniki ludzkie w znacznym stopniu wpływają na procedurę tłumaczenia informacji. Przedstawiono kilka narzędzi wykorzystujących modele poznawcze do pozyskiwania wiedzy .
WNIOSKI
Ogólnie rzecz biorąc, niepewność wpływa na wydajność interfejsu adaptacyjnego w następujących aspektach i oczywiście zarządzanie niepewnością musi uwzględniać wszystkie z nich .
o Jak określić stopień spełnienia przesłanki danej reguły.
o Jak zweryfikować stopień spełnienia ograniczeń zewnętrznych.
o Jak rozprzestrzenić ilość niepewnych informacji poprzez aktywację danej reguły.
o Jak podsumować i ocenić wyniki uzyskane za pomocą różnych reguł lub wiedzy specjalistycznej.
o Jak wykryć ewentualne niespójności między różnymi źródłami oraz
o Jak uszeregować różne alternatywy lub cele
Silniki reguł i systemy oparte na agentach
WSTĘP
Systemy eksperckie są z powodzeniem stosowane w wielu dziedzinach. Często zbudowane na ogólnych systemach opartych na regułach, mogą również wykorzystywać zoptymalizowane algorytmy. Z drugiej strony, bazując na luźno powiązanych komponentach i infrastrukturach peer-to-peer do asynchronicznego przesyłania komunikatów, systemy wieloagentowe zapewniają mobilność kodu, adaptowalność, łatwość wdrażania i rekonfiguracji, dostosowując się tym samym do rozproszonych i dynamicznych środowisk. Ponadto, zapewniają one dobre wsparcie dla ontologii specyficznych dla danej dziedziny, co jest ważną cechą przy modelowaniu wiedzy ekspertów. Możliwość uzyskania najlepszych cech obu technologii jest wyraźnie widoczna poprzez integrację JBoss Rules, silnika reguł efektywnie implementującego algorytm Rete-OO, z JADE, systemem wieloagentowym zgodnym ze standardem FIPA.
TŁO
Silniki reguł
Zalety systemów opartych na regułach w porównaniu ze środowiskami programowania proceduralnego są powszechnie znane i szeroko wykorzystywane, przede wszystkim w kontekście aplikacji biznesowych. Praca z regułami pomaga oddzielić logikę od kodu aplikacji: może być ona modyfikowana przez osoby niebędące programistami, a scentralizowana w jednym miejscu, umożliwia jej analizę i walidację. Silniki reguł są często dobrze zoptymalizowane, co pozwala na efektywne zmniejszenie liczby reguł do dopasowania do zaktualizowanej bazy wiedzy. Systemy oparte na regułach można również rozszerzyć o pomysły i techniki opracowane w innych dziedzinach badań, co prowadzi na przykład do rozmytych systemów opartych na regułach, które wykorzystują logikę rozmytą do radzenia sobie z niedokładnością i niepewnością dotyczącą bazy wiedzy. Co więcej, czasami systemy te są łączone z algorytmami genetycznymi i programowaniem ewolucyjnym w celu generowania złożonych klasyfikatorów. Jednym z najbardziej znaczących zastosowań systemów opartych na regułach są systemy eksperckie, w których zestaw reguł stanowi reprezentację wiedzy eksperta. W takich systemach sztuczna inteligencja (AI) ma działać podobnie do eksperta, gdy zostanie wystawiona na działanie tych samych danych. Spośród różnych mechanizmów implementacji silnika reguł, algorytm Rete zyskuje coraz większą popularność, głównie dzięki wysokiemu stopniowi optymalizacji, jaki można uzyskać. W Centrum Kosmicznym NASA im. Johnsona algorytm Rete został zaimplementowany w całej generacji silników reguł. OPS5 został wkrótce zastąpiony przez swojego następcę, ART, a w 1984 roku przez bardziej znany CLIPS. Obecnie jednym z najpowszechniejszych silników implementujących Rete jest Jess , pierwotnie opracowany jako port CLIPS w Javie w Sandia National Laboratories pod koniec lat 90. Jess został również szeroko przyjęty przez społeczność agentów do realizacji systemów agentowych opartych na regułach . Innym, ale obiecującym silnikiem reguł jest JBoss Rules (Proctor, Neale, Frandsen, Griffith i Tirelli, 2007), dawniej Drools. Jest to całkiem nowe, ale już dobrze znane, darmowe narzędzie implementujące tzw. algorytm Rete-OO. Dostępność kodu źródłowego (open source) stanowi wyraźną przewagę nad Jess, ale jeszcze większą zaletą jest implementacja konkretnej adaptacji algorytmu Rete dla świata obiektowego, a nie dosłownej. W ten sposób znacznie zmniejsza się obciążenie związane z integracją silnika reguł i reguł aplikacji z istniejącymi obiektami zewnętrznymi. W rzeczywistości JBoss Rules wykorzystuje zwykłe obiekty Java do reprezentacji reguł i faktów, które można modyfikować za pomocą ich publicznych metod i właściwości. Reguły można określić za pomocą odpowiedniej składni lub struktur XML, a ich warunki i konsekwencje można wyrazić za pomocą różnych języków skryptowych, takich jak Python, Groovy i Java. Zamiast tego Jess akceptuje tylko reguły napisane w języku CLIPS, co wymaga od programistów nauki nowego języka podobnego do Lispa i włożenia dodatkowych wysiłków w dostosowanie go do ich obiektowego środowiska programistycznego.
Systemy oparte na agentach
Systemy wieloagentowe (MAS) wykazują pewne uzupełniające się cechy, które mogą być przydatne w wielu aplikacjach opartych na regułach, przede wszystkim w asynchronicznych protokołach interakcji i językach semantycznych. W systemach wieloagentowych w rzeczywistości wielu inteligentnych agentów wchodzi ze sobą w interakcje. Agenci są uważani za autonomiczne byty, a ich interakcje mogą mieć charakter kooperacyjny lub egoistyczny (tj. mogą dzielić wspólny cel, jak na linii produkcyjnej, lub realizować własne interesy, jak na otwartym rynku). Fundacja Inteligentnych Agentów Fizycznych (FIPA, 2002) opracowuje otwarte specyfikacje, aby wspierać interoperacyjność między agentami i aplikacjami opartymi na agentach. Specyfikacje infrastruktury obejmują język komunikacji dla agentów, usługi dla agentów oraz przewidują zarządzanie ontologiami specyficznymi dla danej dziedziny. Określono również zestaw dziedzin aplikacji, w tym osobistą pomoc w podróżach, zarządzanie siecią, handel elektroniczny i dystrybucję mediów audiowizualnych. Podstawą modelu FIPA jest komunikacja między agentami; W szczególności opisuje, w jaki sposób agenci mogą wymieniać semantycznie znaczące wiadomości w celu wykonania czynności wymaganych przez całą aplikację. Istnieją różne implementacje platform zgodnych ze standardem FIPA (FIPA implementations, 2003). Wśród nich, JADE zyskał na popularności na przestrzeni lat, a jednocześnie rozwijano coraz więcej podstawowych funkcjonalności i wtyczek firm trzecich. Obecnie obsługuje on większość specyfikacji FIPA związanych z infrastrukturą, takich jak protokoły transportowe, kodowanie wiadomości oraz agenci białych i żółtych stron. Ponadto oferuje różne narzędzia ułatwiające debugowanie i zarządzanie agentami. Możliwość wykorzystania reguł do realizacji systemów agentowych wydaje się obiecująca. Z jednej strony wykazano, że reguły nadają się do definiowania abstrakcyjnych i rzeczywistych architektur agentów i zostały wykorzystane do realizacji tzw. "agentów opartych na regułach", czyli agentów, których zachowanie i/lub wiedza są wyrażane za pomocą reguł . Z drugiej strony, biorąc pod uwagę, że reguły są łatwym i odpowiednim sposobem realizacji zadań rozumowania, uczenia się i zdobywania wiedzy, reguły zostały wykorzystane w tzw. "agentach wzmocnionych regułami", czyli agentach, których zachowanie nie jest normalnie wyrażane za pomocą reguł, ale które wykorzystują silnik reguł jako dodatkowy komponent do wykonywania określonych zadań rozumowania, uczenia się lub zdobywania wiedzy. Oba podejścia mają pewne zalety i wady. Agenci bazujący na regułach zapewniają wszystkie zalety systemów opartych na regułach i jednolity sposób ich programowania, ale ich wydajność jest niewystarczająca dla niektórych rodzajów aplikacji. Agenci z ulepszonymi regułami pozwalają na wykorzystanie różnych paradygmatów programowania; w związku z tym możliwe jest użycie najodpowiedniejszego paradygmatu do realizacji różnych zadań, zarówno w celu uproszczenia rozwoju, jak i spełnienia wymagań wydajnościowych, ale wiąże się to z dodatkowymi kosztami zarządzania integracją/synchronizacją takich heterogenicznych zadań. W przypadku agentów opartych na zachowaniach, takich jak w JADE, silnik reguł można zintegrować z agentem jako zachowanie. Takie podejście może alternatywnie zagwarantować zalety agentów w pełni opartych na regułach lub agentów z ulepszonymi regułami. W rzeczywistości, zarówno zachowania proceduralne, jak i oparte na regułach można bezproblemowo dodać do każdego wdrożonego agenta, zgodnie z funkcjami i wymaganiami aplikacji.
Mobilność i bezpieczeństwo kodu
Kod mobilny okazuje się użyteczny w wielu kontekstach dzięki swojej zdolności do pokonywania opóźnień sieciowych, redukcji obciążenia sieci, umożliwienia asynchronicznego wykonywania i autonomii, dynamicznej adaptacji, działania w środowiskach heterogenicznych oraz zapewnienia solidnych i odpornych na błędy zachowań. Technologie kodu mobilnego obejmują aplety i inne mechanizmy dynamicznego pobierania kodu, a także pełne systemy agentów mobilnych, oparte na modelach takich jak kod na żądanie, zdalna ewaluacja czy agenci mobilni. Gdy silnik reguł jest zintegrowany z systemem wieloagentowym, możliwe są dwa różne przypadki: poproszenie zdalnego agenta o wykonanie zadania lub zastosowanie nowej reguły do jego bazy wiedzy. Podczas gdy reguły mobilne należą do klasy żądań asynchronicznych z odroczonym wykonaniem, zadania mobilne należą do klasy synchronicznej. W obu przypadkach przenoszona jednostka jest fragmentem kodu, który ma zostać zinterpretowany przez silnik skryptowy na agencie docelowym, a nie kompletnym wątkiem wykonania. Należy również przeanalizować różne zagrożenia bezpieczeństwa, z którymi może się zetknąć system kodu mobilnego, oraz odpowiednie środki zaradcze, które można by zastosować. W pracy zidentyfikowano dwie różne klasy ataków, w zależności od celu: ataki na środowisko wykonawcze kodu mobilnego oraz ataki na sam kod. O ile fakt, że kod mobilny może stanowić zagrożenie dla środowiska, w którym jest hostowany, jest powszechnie akceptowany, o tyle często nie bierze się pod uwagę możliwości narażenia się na zagrożenia dla hostowanego kodu. Wynika to z pewnością z braku skutecznych środków zaradczych zapobiegających kradzieży danych i algorytmów z kodu mobilnego przez środowisko hostujące, zbyt wolnemu wykonywaniu kodu, zakłócaniu jego przepływu lub zatrzymywaniu jego wykonywania. Istnieją eksperymentalne algorytmy, które przynajmniej wykrywają "a posteriori" tego typu zagrożenia, w tym częściową enkapsulację wyników, wzajemne rejestrowanie tras, rejestrowanie tras z replikacją i głosowaniem oraz śledzenie wykonania. Niektóre algorytmy próbują nawet zapobiegać pewnym typom ataków na kod hostowany w złośliwych środowiskach, ale ich rzeczywista skuteczność nie została jeszcze udowodniona; należą do nich generowanie kluczy środowiskowych, obliczenia z zaszyfrowanymi funkcjami i zaciemniony kod (czasami nazywany czarną skrzynką o ograniczonym czasie działania). Z drugiej strony, potencjalne zagrożenia stwarzane przez hostowany kod obejmują maskaradę, odmowę usługi, podsłuch i modyfikację. Dostępne środki bezpieczeństwa chroniące środowisko wykonawcze przed potencjalnie złośliwym kodem mobilnym często opierają się na algorytmach zapobiegających atakom, takich jak programowa izolacja błędów, bezpieczna interpretacja kodu, certyfikaty autoryzacji i atrybutów oraz kod z dowodami. Inne techniki koncentrują się na wykrywaniu ataków na środowisko i śledzeniu ich źródła; obejmują one ocenę stanu, podpisany kod i historię ścieżek. Systemy oparte na Javie mogą wykorzystywać środki bezpieczeństwa zapewniane przez maszynę wirtualną i rozszerzać je w razie potrzeby. W szczególności możliwe jest zdefiniowanie precyzyjnych domen ochrony na podstawie certyfikatów autoryzacji . Certyfikaty te, dołączone do kodu mobilnego, zawierają zestaw przyznanych uprawnień i są podpisywane przez lokalnych menedżerów zasobów. Prawa dostępu mogą być również delegowane do innych agentów, aby umożliwić im wykonanie żądanych zadań lub osiągnięcie wyznaczonych celów . Wreszcie, zagrożenia związane z podszywaniem się i modyfikacją można zapobiegać poprzez ustanowienie uwierzytelnionych, podpisanych i szyfrowanych kanałów między zdalnymi komponentami systemu.
INTEGRACJA REGUŁ I AGENTÓW
Spośród różnych implementacji systemów wieloagentowych z ulepszonymi regułami, analiza Drools4JADE (Drools4JADE) może być szczególnie interesująca, ponieważ system powstał w wyniku oceny istniejących technologii w różnych dziedzinach. W rzeczywistości celem tego projektu nie było zaczynanie od zera, opracowanie całkowicie nowej platformy agentowej, ale zamiast tego rozbudowa istniejących rozwiązań, które okazały się solidną warstwą, do której można było dodać bardziej zaawansowane funkcjonalności. W tym przypadku wybranym systemem agentowym jest JADE . Jego udana implementacja w dużych projektach międzynarodowych, takich jak Agenticities, openNet i Tech-Net , dowiodła jego wyższości nad innymi rozwiązaniami dzięki swojej prostocie, elastyczności, skalowalności i solidności. Jak już wspomniano, w wielu kontekstach jego integracja z obiektowym silnikiem reguł open source, takim jak JBossRules, jest preferowana w porównaniu z bardziej tradycyjnym rozwiązaniem JADE-Jess.
Interfejs FIPA do silnika reguł
Do bogatych funkcji JBoss Rules, środowisko agenta może dodać przede wszystkim obsługę komunikacji za pośrednictwem komunikatów ACL (Agent Communication Language), typowych dla agentów FIPA. Reguły mogą odwoływać się do komunikatów ACL zarówno w polach warunków wstępnych, jak i konsekwencji. Ponadto możliwe jest pełne wsparcie dla manipulowania faktami i regułami w agentach z rozszerzonymi regułami za pośrednictwem komunikatów ACL. W środowisku JBoss Rules reguła jest reprezentowana przez instancję klasy Rule: określa ona wszystkie dane samej reguły, w tym warunki wstępne, które sprawiają, że reguła jest ważna, oraz działania, które mają zostać wykonane w konsekwencji reguły. Gdy reguła jest zaplanowana do wykonania, tj. wszystkie jej warunki wstępne są spełnione przez potwierdzone fakty, silnik tworzy nową instancję osadzonego środowiska skryptowego, ustawia w niej niezbędne zmienne i wywołuje interpreter w celu wykonania kodu zawartego w sekcji konsekwencji reguły. W Drools4JADE agenci z ulepszonymi regułami udostępniają kompletne API, umożliwiające manipulowanie ich wewnętrzną pamięcią roboczą poprzez żądania ACL. Ich ontologia definiuje żądania dodawania reguł, potwierdzania, modyfikowania i wycofywania faktów. Wszystkie te żądania muszą być połączone z certyfikatem autoryzacji. Tylko autoryzowani agenci, tj. ci, którzy posiadają certyfikat zawierający listę wszystkich wymaganych uprawnień, mogą wykonywać żądane działania. Co więcej, zaakceptowane reguły będą ograniczone do określonej domeny ochrony, tworzonej zgodnie z ich własnym certyfikatem autoryzacji.
Kwestie bezpieczeństwa
Mobilność reguł i kodu między agentami toruje drogę dla prawdziwie adaptacyjnych aplikacji, ale nie można jej w pełni wykorzystać, jeśli problemy bezpieczeństwa nie zostaną odpowiednio rozwiązane. Środki bezpieczeństwa zaimplementowane w Drools4JADE w znacznym stopniu korzystają z istniejącej infrastruktury zapewnianej przez platformę Java i JADE. Model bezpieczeństwa JADE opiera się na tradycyjnych koncepcjach zorientowanych na użytkownika, takich jak zleceniodawcy, zasoby i uprawnienia. Ponadto zapewnia on środki umożliwiające delegowanie praw dostępu między agentami oraz implementację precyzyjnych domen ochrony za pomocą certyfikatów autoryzacyjnych. W ramach bezpieczeństwa JADE zleceniodawca reprezentuje dowolną jednostkę, której tożsamość można uwierzytelnić. Zleceniodawcy są powiązani z pojedynczymi osobami, działami, firmami lub innymi jednostkami organizacyjnymi. Również pojedynczy agenci są powiązani z zleceniodawcą; w odniesieniu do swoich agentów użytkownik stanowi zleceniodawcę nadrzędnego, umożliwiając w ten sposób nadawanie określonych uprawnień wszystkim agentom uruchomionym przez pojedynczego użytkownika. Zasoby, którymi zajmuje się model bezpieczeństwa JADE, obejmują te już zapewniane przez model bezpieczeństwa Java (tj. system plików, połączenia sieciowe, zmienne środowiskowe, połączenia z bazą danych). Zasoby typowe dla systemów wieloagentowych, które mają być chronione przed nieautoryzowanym dostępem, obejmują samych agentów i ich środowisko wykonawcze. Uprawnienie reprezentuje możliwość wykonywania działań na zasobach systemowych. Aby podjąć decyzję podczas próby dostępu do zasobu, funkcje kontroli dostępu porównują uprawnienia przyznane użytkownikowi z uprawnieniami wymaganymi do wykonania działania; dostęp jest dozwolony, jeśli wszystkie wymagane uprawnienia są posiadane. Gdy agent jest proszony o zaakceptowanie nowej reguły lub zadania, pierwsza ochrona dostępu obejmuje uwierzytelnienie osoby żądającej i sprawdzenie uprawnień do wykonania działania; tj. czy agent rzeczywiście może dodać nową regułę lub przesłać zadanie do wykonania w jego imieniu? Aby wykonać te zadania, osoba żądająca potrzebuje określonych uprawnień. Co więcej, aby w pełni wykorzystać potencjał delegowania zadań i mobilności reguł, agent docelowy powinien mieć możliwość ograniczenia zestawu zasobów udostępnianych kodowi mobilnemu. Agenci powinni mieć możliwość delegowania nie tylko zadań, ale nawet praw dostępu niezbędnych do ich wykonania. Jest to możliwe dzięki pakietowi bezpieczeństwa JADE, w którym rozproszone polityki bezpieczeństwa mogą być sprawdzane i egzekwowane na podstawie podpisanych certyfikatów autoryzacji. W tego typu systemach każda żądana akcja może być opatrzona certyfikatem podpisanym przez lokalnego menedżera zasobów, zawierającym listę uprawnień przyznanych wnioskodawcy. Uprawnienia można uzyskać bezpośrednio z pliku polityki lub za pośrednictwem procesu delegowania. Dzięki temu procesowi agent może dodatkowo delegować zestaw uprawnień innemu agentowi, jeśli udowodni, że posiada te uprawnienia. Ostateczny zestaw uprawnień otrzymany w komunikacie żądania może zostać ostatecznie wykorzystany przez agenta pomocniczego do utworzenia nowej domeny ochrony, która otoczy kod mobilny podczas jego wykonywania, chroniąc dostęp do zasobów systemu i aplikacji.
PRZYSZŁE TRENDY
Architektura systemu oparta na silnikach reguł i systemach wieloagentowych stanowi dobry punkt wyjścia do zbudowania w pełni rozproszonego środowiska, w którym rozproszona wiedza może obejmować zarówno dane, jak i kod. Na przykład może być wykorzystana do realizacji systemów rozproszonej obsługi sygnałów i alarmów, zarządzania siecią itp. Rozwój zaawansowanych funkcji sieciowych, takich jak transparentne i rekonfigurowalne funkcje dynamicznego równoważenia obciążenia, dystrybucji faktów i reguł między zdalnymi silnikami, wykrywania i odzyskiwania po awarii, może dodać systemowi jeszcze większej wartości, torując drogę do rozwoju rozproszonych środowisk obliczeniowych opartych na sieciach agentów i platform FIPA.
WNIOSKI
Integracja obiektowego silnika reguł i silnika skryptowego w ramach platformy programistycznej agentów może przynieść wiele korzyści. Powstały system łączy solidność platformy dla rozproszonych systemów wieloagentowych z ekspresyjną mocą reguł i zdolnością adaptacji do zmieniających się warunków, jaką zapewnia kod mobilny. Oczywiście, rozwój rzeczywistych aplikacji stawia poważne wymagania bezpieczeństwa, którym można sprostać za pomocą szczegółowych polityk bezpieczeństwa i delegowania uprawnień za pomocą podpisanych certyfikatów. Obszary zastosowań obejmują między innymi e-learning, e-biznes, komponowanie usług i zarządzanie sieciami.
System Neuro-Fuzzy oparty na zbiorach przybliżonych
WSTĘP
Hybrydyzacja Neuro-Fuzzy to najstarsza i najpopularniejsza metodologia w informatyce miękkiej . Hybrydyzacja Neuro-Fuzzy jest znana w literaturze jako Fuzzy Neural Networks lub Neuro-Fuzzy Systems (NFS) . NFS umożliwia abstrakcję modelu rozmytego z danych przykładów liczbowych za pomocą technik uczenia neuronowego, co pozwala na formułowanie dokładnych predykcji na podstawie niewidzianych próbek. Model rozmyty wykorzystuje ludzki styl rozumowania rozmytego poprzez model lingwistyczny, który składa się z reguł rozmytych typu "jeśli-to" oraz terminów lingwistycznych opisanych funkcjami przynależności. Zatem główną zaletą NFS w modelowaniu danych jest uniwersalna aproksymacja z możliwością pozyskiwania interpretowalnych reguł rozmytych typu "jeśli-to" . Jednak modelowanie danych z wykorzystaniem NFS wiąże się ze sprzecznymi wymaganiami interpretowalności i dokładności. Przeważnie NFS, który koncentrował się na dokładności, wykorzystywał optymalizację, która skutkowała funkcjami przynależności, które odbiegały od terminów lingwistycznych interpretowalnych przez ludzi, lub wykorzystywał dużą liczbę reguł rozmytych typu "jeśli-to" w przypadku danych wielowymiarowych, które przekraczały możliwości interpretacji na poziomie ludzkim. Niniejszy artykuł przedstawia nowatorski hybrydowy, inteligentny system neurorozmyty (RNFS) oparty na zbiorach przybliżonych. RNFS synergizuje słuszną koncepcję redukcji wiedzy z teorii zbiorów przybliżonych z NFS. RNFS wzmacnia siłę NFS, wykorzystując techniki oparte na zbiorach przybliżonych do przeprowadzania redukcji atrybutów i reguł, poprawiając w ten sposób interpretowalność bez uszczerbku dla dokładności abstrakcyjnego modelu rozmytego.
TŁO
Głównym problemem w obliczeniach miękkich jest zniwelowanie luki między wiedzą subiektywną a danymi obiektywnymi . Istnieją dwa podejścia do rozwiązania tego problemu: modelowanie danych, w którym funkcja jest budowana tak, aby dokładnie naśladować dane, oraz abstrahowanie danych, w którym system jest budowany w celu generowania wiedzy artykułowanej, najlepiej w formie języka naturalnego . Pierwsze podejście kładzie nacisk na zdolność do odtworzenia tego, co zostało zaobserwowane. Sieci neuronowe z ich wybitnymi zdolnościami uczenia się inspirowanymi systemami biologicznymi,są bardzo odpowiednie w tym podejściu. Z drugiej strony, drugie podejście kładzie nacisk na zdolność do wyjaśniania danych w sposób zrozumiały dla człowieka. Systemy rozmyte, które potrafią modelować terminy lingwistyczne będące wyrażeniami języka ludzkiego, są również bardzo skuteczne w tym podejściu. W systemach rozmytych wyrażenia lingwistyczne są formułowane na podstawie wiedzy jawnej w postaci reguł rozmytych typu "jeśli-to", gdzie terminy lingwistyczne poprzedników i następników są zbiorami rozmytymi. Jednak parametry tych wyrażeń lingwistycznych są czasami trudne do określenia i muszą być ręcznie dostrajane. W przeciwieństwie do tego, chociaż sieci neuronowe są zdolne do uczenia się na podstawie danych, są modelami typu "czarna skrzynka", a zatem pozyskiwanie wiedzy od sieci neuronowych nie jest prostym zadaniem. Zatem sieć neuronowa jest zdolna do modelowania danych, ale użytkownik nie może się z nich uczyć. Z drugiej strony, użytkownik może uczyć się od systemu rozmytego, ale system ten nie jest zdolny do uczenia się na podstawie danych. Hybrydyzacja neuro-rozmyta synergizuje te dwie techniki, łącząc ludzki styl rozumowania systemów rozmytych z uczeniem się i strukturą koneksjonistyczną sieci neuronowych. Zatem systemy neuro-rozmyte (NFS) to modele typu "szara skrzynka", które są zdolne do abstrahowania modelu rozmytego z podanych przykładów numerycznych za pomocą technik uczenia neuronowego. Zatem system neuro-rozmyty uczy się, a jednocześnie użytkownik może się z niego uczyć. Jednak zastosowanie NFS do abstrahowania danych wiąże się z dwoma sprzecznymi wymaganiami w modelowaniu rozmytym: interpretowalność kontra dokładność (Casillas, Cordón, Herrera i Magdalena, 2003). W praktyce przeważa tylko jedna z tych dwóch właściwości. W związku z tym można je sklasyfikować jako lingwistyczne NFS, skoncentrowane na interpretowalności, głównie z wykorzystaniem modelu Mamdaniego ; oraz precyzyjne NFS, skoncentrowane na dokładności, głównie z wykorzystaniem modelu Takagi-Sugeno-Kanga. Dominujące badania nad modelowaniem danych z wykorzystaniem lingwistycznego modelu NFS koncentrowały się na maksymalnym zwiększeniu dokładności, ale zaniedbywały interpretowalność . Istniejące lingwistyczne modele NFS, takie jak FALCON , wykorzystują hybrydowe podejście uczenia się do abstrakcyjnego modelowania na podstawie danych numerycznych. W tym podejściu, klasteryzacja jest wykorzystywana w pierwszym etapie do generowania funkcji przynależności, a uczenie konkurencyjne służy do identyfikacji reguł rozmytych if-then; następnie następuje uczenie nadzorowane, które wykorzystuje propagację wsteczną w ostatnim etapie do optymalizacji funkcji przynależności. Nieograniczona optymalizacja w ostatnim etapie zwiększa dokładność abstrakcyjnego modelu, ale prowadzi do powstania funkcji przynależności, które są oderwane od terminów lingwistycznych interpretowanych przez człowieka . Chociaż definicja interpretowalności i jej kryteria są przedmiotem kontrowersyjnych dyskusji, interpretowalne zmienne lingwistyczne często wiążą się z kształtem i wzajemnym nakładaniem się funkcji przynależności . Niemniej jednak zaproponowano formalną definicję semantycznych właściwości interpretowalnych zmiennych lingwistycznych , a mianowicie: pokrycie, znormalizowanie, wypukłość i uporządkowanie. Interpretowalność jest kluczowa dla NFS w modelowaniu danych, ponieważ zaniedbanie ich prowadzi do przekształcenia się w modele czarnej skrzynki, w których tracą one przewagę nad innymi metodami, takimi jak sieci neuronowe . Dlatego abstrahowanie modelu rozmytego, który nie jest interpretowalny dla człowieka, podważa fundamentalny cel stosowania NFS. Ponadto, do modelowania danych wielowymiarowych wymagana jest duża liczba reguł rozmytych if-then, co z kolei przekracza ludzkie możliwości interpretacyjne .Ten problem interpretowalności dużej liczby reguł if-then motywuje redukcję złożoności NFS. Jest to podobne do problemów napotykanych przez techniki numeryczne oparte na danych w eksploracji danych . Techniki te opierają się na heurystykach, które kierują lub redukują przestrzeń wyszukiwania poziomo lub pionowo. Redukcja pozioma jest realizowana przez scalanie identycznych krotek danych lub kwantyzację ciągłych wartości liczbowych, podczas gdy redukcja pionowa jest realizowana za pomocą metod selekcji cech. W lingwistycznym NFS pierwsza odpowiada konwersji numerycznych danych wejściowych z zakresu ciągłego na skończoną liczbę terminów lingwistycznych przy użyciu funkcji przynależności, podczas gdy druga odpowiada przycinaniu i redukcji za pomocą rozmytych reguł if-then. W niektórych istniejących lingwistycznych systemach neuro-rozmytych, redukcja pionowa jest stosowana poprzez identyfikację mniejszej liczby reguł rozmytych typu "jeśli-to" przy użyciu określonego progu heurystycznego lub poprzez zastosowanie przycinania opartego na współczynnikach pewności . Jednakże, jeśli liczba reguł typu "jeśli-to" jest ograniczona w praktyce poprzez zastosowanie progów heurystycznych, wówczas traci się uniwersalną właściwość aproksymacji . Ostatnio teoria zbiorów przybliżonych , jedna z metodologii w miękkich obliczeniach, wykazała, że zapewnia skuteczne techniki znajdowania ukrytych wzorców w danych. Metody oparte na zbiorach przybliżonych wykazały potencjał wykonalnej selekcji cech z możliwością znacznej redukcji wymiarowości wzorców w sieciach neuronowych. To motywuje do synergii metod opartych na zbiorach przybliżonych z NFS w celu zwiększenia interpretowalności abstrakcyjnego modelu bez obniżania dokładności.
SYSTEM NEURO-Fuzzy OPARTY NA ZBIORACH SZORSTKICH
W niniejszym artykule przedstawiono hybrydowy, inteligentny system neuro-rozmyty oparty na zbiorach szorstkości (RNFS) , który łączy w sobie solidną koncepcję redukcji wiedzy w teorii zbiorów szorstkości z ludzkim stylem rozumowania systemów rozmytych oraz uczącą się i koneksjonistyczną strukturą sieci neuronowych. Szczegóły dotyczące architektury i procesu uczenia się systemu RNFS opisano w kolejnych sekcjach.
Architektura systemu RNFS
Architektura systemu RNFS to pięciowarstwowa sieć neuronowa przedstawiona na rysunku 1. Jej architektura została opracowana z wykorzystaniem rozmytej sieci neuronowej opartej na pseudoprodukcie zewnętrznym, wykorzystującej kompozycyjną regułę wnioskowania i fuzzyfikator singletonowy (POPFNN-CRI(S)) jako podstawę. Dla uproszczenia przedstawiono jedynie połączenia dla wyjścia ym. Każda warstwa w RNFS wykonuje określoną operację rozmytą, dlatego węzły i operacje każdej warstwy są oznaczone w celu przejrzystości indeksem górnym od I do V. Wejścia i wyjścia RNFS są reprezentowane odpowiednio jako wektor nierozmyty X = [x1, x2, … ,xi,…,xn1n1] i wektor nierozmyty Y = [y1, y2,…,ym,…,yn5]. Rozmycie wejść i defuzyfikacja wyjść są odpowiednio wykonywane przez warstwy lingwistyczne wejścia i wyjścia, podczas gdy mechanizm wnioskowania jest zbiorczo wykonywany przez warstwy warunku, reguły i konsekwencji. Każdy węzeł reguły RkIII na rysunku 1 jest połączony tylko z jednym węzłem etykiety wejściowej z każdego węzła wejściowego i tylko z jednym węzłem etykiety wyjściowej z każdego węzła wyjściowego.

Połączenia węzłów reguł z poprzednikiem w warstwie warunku i następnikiem w warstwie konsekwencji są matematycznie oznaczone jako zbiór (CI,DV). Poprzednik węzłów reguł jest reprezentowany przez zbiór CI = {c1,c2,…,ci,…,cn1}, gdzie ci jest zmienną warunkową taką, że ci ∈ ILiII. Zbiór etykiet warunków, które może przyjąć ci, jest semantycznie reprezentowany przez zbiór węzłów etykiet wejściowych
ILiII = { ILi,1II, ILi,2II,… ILi,jII… ILiJiII}?
?ale w tym artykule użyto notacji obliczeniowej ILiII = {1,2,…,j,…,Ji}. Podobnie, następnik węzłów reguł jest reprezentowany przez zbiór DV = {d1,d2,…,dm,.
…,dn5}, gdzie dm jest zmienną następnika taką, żedm∈ OLm. Zbiór etykiet następnika, które może przyjąć dm, jest semantyczno-etycznie reprezentowane przez zbiór węzłów etykiet wyjściowych
OLmIV = { OLm,1IV, OLm,2IV,… OLm,lIV … OLm,LmIV}
ale w tym artykule zastosowano notację obliczeniową OL,sub>mIV = {1, 2, …, l,…,Lm}. Konkretne powiązania węzła reguły RkIII z (CkI,DkV)
Nowatorskimi cechami RNFS są:
o Redukcja pionowa reguł rozmytych if-then - jest przeprowadzana w RNFS, w którym algorytm pseudoproduktu zewnętrznego (RSPOP) oparty na zbiorach przybliżonych jest używany do identyfikacji reguł rozmytych if-then, redukcji atrybutów i redukcji reguł z wykorzystaniem redukcji wiedzy opartej na zbiorach przybliżonych. Ten proces redukcji pionowej jest przeprowadzany autonomicznie, bez polegania na zdefiniowanych przez użytkownika progach heurystycznych w celu identyfikacji mniejszej liczby reguł rozmytych if-then.
o Uczenie nadzorowane - jest stosowane w RNFS, w którym algorytm SPSEC (Supervised Pseudo Self-Evolving Cerebellar) jest używany do generowania funkcji przynależności, a algorytm RSPOP jest używany do identyfikacji reguł uzzy if-then, zamiast stosowania propagacji wstecznej lub hybrydowego podejścia do uczenia.
o Zautomatyzowana abstrakcja modelu - jest realizowana przez RNFS bez konieczności stosowania parametrów zdefiniowanych przez użytkownika w algorytmach uczenia neuronowego, które generują funkcje przynależności i identyfikują reguły rozmyte if-then. Dzięki temu nie wymaga specjalistycznych umiejętności ani wiedzy.
Proces uczenia się pod nadzorem w RNFS
RNFS wykorzystuje nowatorskie podejście uczenia się pod nadzorem, które składa się głównie z dwóch algorytmów: SPSEC , który generuje funkcje przynależności, oraz RSPOP , który identyfikuje reguły rozmyte if-then. Rysunek 2 ilustruje proces uczenia się neuronów algorytmu generowania funkcji przynależności w Supervised Pseudo Self-Evolving Cerebellar (SPSEC).

Rysunek 2(a) przedstawia kroki 1-2, w których SPSEC konstruuje strukturę móżdżkową z m regularnie rozmieszczonymi neuronami, obejmującą przestrzeń wejściową, w której móżdżek jest częścią mózgu zaangażowaną w naukę umiejętności motorycznych i zapewnia precyzyjną koordynację kontroli motorycznej części ciała . Te kroki modelują pierwszy etap procesu rozwoju naszego układu nerwowego, w którym podstawowa architektura i zgrubne wzorce połączeń są tworzone bez żadnych procesów zależnych od aktywności . Rysunek 2(b) przedstawia kroki 3-4, w których SPSEC przeprowadza uczenie strukturalne, wykonując jednoprzebiegowe uczenie wagowe z wykorzystaniem gaussowskiego uczenia się sąsiedztwa w celu określenia rozkładu danych treningowych, a następnie pseudosamodzielnie ewoluuje tę strukturę móżdżkową, identyfikując neurony o wysokim współczynniku troficznym, których wagi tworzą szczyt, podczas gdy pozostałe neurony są usuwane. Te kroki modelują drugi etap procesu rozwoju naszego układu nerwowego, w którym początkowa architektura jest udoskonalana w sposób zależny od aktywności (Kandel i in., 1995). Rysunek 2(c) przedstawia krok 5, w którym wagi neuronów ocalałych są parametrami wynikowej funkcji przynależności gaussowskiej, które są zgodne z semantyką interpretowalnych zmiennych lingwistycznych. Algorytm SPSEC jest w stanie generować efektywne funkcje przynależności, które są zgodne z semantyką interpretowalnych zmiennych lingwistycznych, a mianowicie: pokrycia, znormalizowanego, wypukłego i uporządkowanego (Mikut i in., 2005). Wygenerowane funkcje przynależności nie wymagają dalszego procesu optymalizacji stosowanego w hybrydowym podejściu uczenia się w celu zwiększenia dokładności modelu abstrakcyjnego. Wyeliminowanie obciążenia związanego z dalszym procesem optymalizacji gwarantuje, że wygenerowane funkcje przynależności nie odbiegają od terminów interpretowalnych przez człowieka. Rysunek 3 ilustruje proces redukcji wiedzy oparty na zbiorze przybliżonym algorytmu identyfikacji reguł rozmytych typu if-then opartego na zbiorze przybliżonym (RSPOP) .

Rysunek 3(a) przedstawia przykład zbioru wpływowych reguł rozmytych typu if-then zidentyfikowanych w krokach identyfikacji reguł RSPOP z wykorzystaniem uczenia Hebba . Rysunek 3(b) przedstawia reguły rozmyte warunkowe typu "jeśli-to", które są redukowane przez kroki redukcji atrybutów RSPOP z wykorzystaniem redukcji wiedzy opartej na zbiorach przybliżonych . Rysunek 3(c) przedstawia reguły rozmyte warunkowe typu "jeśli-to", które są dodatkowo redukowane przez kroki redukcji reguł RSPOP z wykorzystaniem redukcji wiedzy opartej na zbiorach przybliżonych . Liczby od 0 do 4 na rysunku 3, które reprezentują etykiety warunku i następnika na rysunku 1, nie wskazują, że zidentyfikowane reguły rozmyte warunkowe typu "jeśli-to" są interpretowalne. Aby zilustrować intuicyjność zidentyfikowanych reguł rozmytych warunkowych typu "jeśli-to", w Tabeli przedstawiono przykład mapowania etykiet semantycznych na każdy warunek i następnik.

Przykład na rysunku 3 i w tabeli 1 pokazuje, że algorytm RSPOP jest w stanie zidentyfikować mniej, ale skutecznych reguł rozmytych warunkowych typu "jeśli-to", co ułatwia interpretację przez człowieka. Mniejsza liczba zidentyfikowanych reguł rozmytych warunkowych
PRZYSZŁE TRENDY
Proponowana architektura RNFS opiera się na synergii solidnej koncepcji redukcji wiedzy w teorii zbiorów przybliżonych z NFS . Istniejące NFS nie są w stanie abstrahować dokładnych i interpretowalnych modeli z danych wielowymiarowych bez uprzedniej selekcji cech w celu redukcji wymiarowości danych do łatwego w zarządzaniu poziomu. Synergia redukcji wiedzy opartej na zbiorach przybliżonych wzmacnia i rozszerza możliwości NFS, umożliwiając potencjalne zastosowanie w danych wielowymiarowych, takich jak ekspresja genów na mikromacierzach i obrazowanie funkcji metodą rezonansu magnetycznego (fMRI). W związku z tym należy przeprowadzić dalsze badania nad adekwatnością abstrahowania danych wielowymiarowych za pomocą RNFS i porównać je z innymi, powszechnie stosowanymi metodami. Ponadto, istniejące NFS opierały się na parametrach zdefiniowanych przez użytkownika, aby uniknąć nadmiernego dopasowania danych treningowych, aby umożliwić dobrą generalizację na niewidzianych danych testowych. Problem ten jest znany w literaturze poświęconej rozpoznawaniu wzorców jako unikanie nadmiernego dopasowania (overfitting Avoiding) i brzytwa Ockhama . Chociaż system RNFS jest zdolny do autonomicznego abstrahowania modelu z danych liczbowych bez konieczności stosowania parametrów zdefiniowanych przez użytkownika, wstępne badania wykazały, że system RNFS może potencjalnie abstrahować model, który nadmiernie dopasowuje się do danych treningowych. Dlatego należy przeprowadzić dalsze badania nad tym, jak uniknąć nadmiernego dopasowania danych treningowych przez system RNFS bez polegania na parametrach zdefiniowanych przez użytkownika.
WNIOSKI
W niniejszym artykule przedstawiono system neuronowo-rozmyty oparty na zbiorach przybliżonych (RNFS), który jest hybrydowym inteligentnym systemem, który synergizuje słuszną koncepcję redukcji wiedzy w teorii zbiorów przybliżonych z ludzkim stylem rozumowania systemów rozmytych oraz uczeniem się i strukturą koneksjonistyczną sieci neuronowych. Główną zaletą hybrydyzacji neuro-rozmytej jest uniwersalna aproksymacja z możliwością pozyskiwania interpretowalnych reguł rozmytych typu "jeśli-to" . Hybrydyzacja neuro-rozmyta oparta na zbiorach przybliżonych dodatkowo ją wzmacnia, poprawiając interpretowalność, a także dokładność istniejącej hybrydyzacji neuro-rozmytej. Ostatnio podejście neuro-rozmyte oparte na zbiorach przybliżonych, polegające na abstrahowaniu modeli z danych, zostało z powodzeniem zastosowane w różnych zastosowaniach, takich jak prognozowanie przepływu ruchu , handel akcjami oraz klasyfikacja danych biomedycznych . W związku z tym potencjał RNFS jest ekscytujący, ponieważ poprawia interpretowalność NFS bez obniżania dokładności wyabstrahowanego modelu.
Sieci RBF do weryfikacji topologii systemu elektroenergetycznego
WSTĘP
Warunkiem koniecznym monitorowania i sterowania systemem elektroenergetycznym (SEE) jest posiadanie wiarygodnego modelu tego systemu. Model SEE na potrzeby dyspozytorów w krajowym centrum sterowania jest tworzony w czasie rzeczywistym. Ważnym elementem takiego modelu jest model topologii. Weryfikacja topologii SEE (SEE) stanowi istotny problem w inżynierii SEE. Często problem ten jest rozwiązywany jednocześnie z estymacją stanu SEE.Metody umożliwiające takie rozwiązanie problemu są zaawansowane i zazwyczaj czasochłonne. Wymagają one skutecznej estymacji stanu, ale w przypadku pewnych błędów topologii (TE) mogą wystąpić problemy ze zbieżnością. Dlatego też, przed estymacją stanu, pożądana jest solidna metoda dla SEE.
TŁO
Obecnie obserwuje się wzrost zastosowania sztucznych sieci neuronowych (ANN) w niektórych dziedzinach sztucznej inteligencji (PS) . Jednym z takich obszarów jest PSTV. Można ją traktować jako problem rozpoznawania wzorców, a następnie uwzględnić wykorzystanie techniki ANN do rozwiązania PSTV . Istnieje wiele publikacji opisujących PSTV z wykorzystaniem ANN. W pracy (Tian, Zhu i Zhang, 1995) przedstawiono wykorzystanie ANN jako części systemu ekspertowego do ekstrakcji reguł. Jedna z pierwszych metod PSTV zakładała wykorzystanie jednej ANN dla całej PSTV . W przypadku tej metodyzłożoność struktury SSN gwałtownie rośnie wraz z rozmiarem sieci elektroenergetycznej. W przypadku dużych sieci SSN występują problemy z procesem uczenia i klasyfikacji. W innych próbach rozwiązania problemu PSTV z wykorzystaniem SSN można zaobserwować wykorzystanie dodatkowej wiedzy o sieciach SSN . Takie podejście pozwala na zmniejszenie rozmiaru wykorzystywanych sieci SSN. Proces uczenia i klasyfikacji staje się bardziej efektywny, a metoda weryfikacji - wydajniejsza. Rozważane podejście jest również stosowane w przypadku metody, która zostanie przedstawiona dalej.
OPIS ROZWAŻANEGO ROZWIĄZANIA
Aby zapewnić, że w opisywanej metodzie zostanie wykorzystana większa wiedza o sieciach SSN niż w innych metodach dla PSTV, wprowadzono tzw. wskaźniki asymetrii. Biorąc pod uwagę charakter rozwiązywanego problemu oraz w celu osiągnięcia najlepszych cech sieci PSTV, wykorzystuje się sieci o radialnych funkcjach bazowych (RBFN).
Model systemu elektroenergetycznego
Elementami modelu topologii sieci elektroenergetycznej są węzły (reprezentujące węzły elektryczne) i gałęzie (reprezentujące linie energetyczne, transformatory, obciążenia itp.). Przyjęto założenie, że każda gałąź w modelu sieci elektroenergetycznej jest modelowana jako obwód równoważny ? (rys. 1). Zakłada się, że istnieje dostępny, wiarygodny zbiór danych pomiarowych takich wielkości, jak: przepływy mocy czynnej i biernej na końcach każdej gałęzi, moc wejściowa, obciążenia i wartości napięcia w każdym węźle. Zazwyczaj, jeśli gałąź nie jest uwzględniona w modelu sieci elektroenergetycznej, dane pomiarowe dotyczące tej gałęzi nie są uwzględniane w przeprowadzanych analizach.
Wskaźniki asymetrii
Korzystając z praw Kirchhoffa i Ohma, asymetrię można opisać wieloma zależnościami między wielkościami mierzonymi. Jeśli nie występują asymetrie TE, wszystkie te zależności są spełnione. W przypadku wystąpienia asymetrii TE niektóre z nich stają się niespełnione. Należy podkreślić, że jeśli gałąź nie jest uwzględniona w modelu asymetrii, zależności dla tej gałęzi nie są uwzględniane, ponieważ nie są uwzględniane dane pomiarowe dla niej. W opisanym podejściu, aby umożliwić badanie zależności dla wszystkich węzłów i gałęzi niezależnie od ich poprawnego lub błędnego uwzględnienia w modelu asymetrii,wprowadzono tzw. wskaźniki asymetrii dla węzłów i gałęzi . Wskaźniki te przedstawiono w tabeli

Należy zauważyć, że przy obliczaniu wskaźników asymetrii gałęzi uwzględniane są węzłowe wskaźniki asymetrii, a nie dane pomiarowe przepływu mocy. Fakt ten pozwala na uwzględnienie wskaźników asymetrii gałęzi niezależnie od poprawnego lub błędnego uwzględnienia gałęzi w modelu asymetrii. Wskaźniki asymetrii tworzą charakterystyczne zestawy wartości dla różnych przypadków modelowania sieci elektroenergetycznej (PS). Jeżeli model topologiczny jest poprawny i nie występują błędy obciążające dane pomiarowe, wszystkie węzłowe wskaźniki asymetrii są równe zeru, a wskaźniki asymetrii gałęzi są również bliskie zeru. Podobnie jest, gdy istnieje gałąź, która jest faktycznie wyłączona z eksploatacji, ale jest uwzględniona w modelu topologicznym (błąd włączenia). Jeżeli gałąź jest faktycznie w eksploatacji w sieci elektroenergetycznej (PS), ale nie jest uwzględniona w modelu topologicznym (błąd wykluczenia), to: (i) wskaźniki asymetrii dla węzłów końcowych tej gałęzi znacznie różnią się od zera, (ii) wskaźniki asymetrii dla rozpatrywanej gałęzi są równe zeru, (iii) wartości bezwzględne wskaźników asymetrii dla innych gałęzi, które dotyczą węzłów wymienionych w punkcie (i), mają szczególnie duże wartości. Należy podkreślić, że zachowanie wskaźników asymetrii dla mocy czynnej i biernej jest takie samo dla tej samej wartości TE. Analizując wskaźniki asymetrii dla węzłów i gałęzi można zaobserwować, że błąd wykluczenia gałęzi j nie ma wpływu na: (i) wskaźniki asymetrii dla węzłów, które nie są węzłami końcowymi gałęzi j, (ii) wskaźniki asymetrii dla gałęzi, które nie są incydentne z węzłami końcowymi gałęzi j. Ta obserwacja wskazuje na istnienie lokalnego efektu TE. W tej sytuacji można wnioskować o poprawności modelowania wyróżnionej gałęzi j na podstawie badań wskaźników asymetrii dla określonych obszarów sieci elektroenergetycznej: Ajk ,Ajl , gdzie: k, l to numery węzłów końcowych gałęzi j. Axj ∈ {k, l} to obszar, w którym występuje gałąź j z węzłem centralnym x. Obszar Axjobejmuje: (i) węzeł x (będący jednym z węzłów końcowych gałęzi j), (ii) gałąź j i wszystkie pozostałe gałęzie incydentne z węzłem x, (iii) wszystkie węzły połączone z węzłem x gałęziami wymienionymi w punkcie (ii).
Konieczność wykorzystania sieci neuronowych
Wcześniejsze rozważania dotyczące wskaźników asymetrii odnoszą się do sytuacji idealnej. W sytuacjach rzeczywistych dane pomiarowe są obarczone błędami, a ponadto może wystąpić wiele TE. W takich sytuacjach opisane wcześniej skutki TE, skutki wystąpienia błędów pomiarowych i TE innych niż ten, który niepoprawnie modeluje rozpatrywaną gałąź, nakładają się na siebie. W sytuacjach rzeczywistych problem PSTV jest problemem złożonym. Biorąc pod uwagę analizę zachowania wskaźników asymetrii, można stwierdzić, że w opisanej sytuacji problem PSTV można traktować jako problem rozpoznawania wzorców, a następnie wykorzystanie sieci neuronowych (SN) można uznać za właściwy pomysł rozwiązania problemu PSTV. Na podstawie wcześniejszych rozważań można stwierdzić, że cały proces PSTV można rozłożyć na wiele prostszych procesów PSTV. Jeden taki proces można ograniczyć do obszaru jxA. Jeśli założymy wykorzystanie sieci neuronowych, to dla każdego z wyróżnionych procesów należy zbudować osobną sieć neuronową. Pożądane są możliwie proste i szybko uczące się sieci neuronowe (SN), dlatego zwrócono uwagę na sieci neuronowe RBFN .
Zasada metody
Proponowana metoda weryfikacji topologii składa się z następujących kroków:
o obliczenie wskaźników asymetrii dla węzłów i gałęzi,
o wstępne przetwarzanie wskaźników asymetrii (standaryzacja przed przetwarzaniem),
o klasyfikacja lokalna,
o klasyfikacja globalna.
Standaryzacja przed przetwarzaniem
Standaryzacja przed przetwarzaniem każdego wskaźnika asymetrii jest realizowana z wykorzystaniem modułu Radialnej Funkcji Bazowej (RBF) z funkcją przejścia Gaussa:
f(w) = exp(-w2/2σ2) (1)
gdzie: w jest wartością rozpatrywanego wskaźnika asymetrii, σ jest parametrem szerokości. Jeśli wskaźnik asymetrii jest bliski zeru, wyjście modułu RBF jest bliskie jedności. Jeżeli wskaźnik niewyważenia znacząco różni się od zera, moc wyjściowa jednostki RBF jest bliska zeru. Standaryzacja wstępnego przetwarzania pozwala na utrzymanie wartości wejściowych dla klasyfikatorów lokalnych (w kolejnym kroku metody) w zakresie (0; 1). Parametr σ dla wskaźnika WPk oblicza się następująco (przyjmuje się niezależność błędów):

gdzie σPkl jest odchyleniem standardowym danych przepływu mocy czynnej Pkl; a jest współczynnikiem korekcji dobranym eksperymentalnie. Parametr szerokości dla wskaźnika asymetrii gałęzi WPkl jest dany wzorem:

Parametry szerokości dla wskaźników asymetrii mocy biernej oblicza się w podobny sposób. Przyjęto a = 2 dla wskaźników asymetrii mocy czynnej i a = 1,8 dla Wskaźniki asymetrii mocy biernej.
Klasyfikacja lokalna
Celem rozważanego kroku metody jest klasyfikacja poprawności modelowania gałęzi sieci elektroenergetycznej. W trakcie opisywanego kroku uwzględniany jest lokalny wpływ elementów skończonych. Każdy klasyfikator lokalny to RBFN. Jeden klasyfikator lokalny odpowiada jednemu węzłowi rozważanej sieci elektroenergetycznej. Jeżeli rozpatrywany węzeł ma numer k, to wejścia dla klasyfikatora lokalnego odpowiadającego temu węzłowi są wynikami wstępnego przetwarzania wskaźników asymetrii mocy czynnej i biernej dla: (i) węzła k, (ii) węzłów o numerach ze zbioru Ik, (iii) każdej gałęzi łączącej węzeł k i węzeł l, przy założeniu, że l ∈ Ik. Liczba wyjść klasyfikatora lokalnego jest równa liczbie gałęzi łączących węzeł k z węzłami o numerach ze zbioru Ik. Kryterium podejmowania decyzji o poprawności modelowania gałęzi jest następujące:

gdzie: Dl jest decyzją, Yl jest wartością wyjściową odpowiadającą gałęzi między węzłem k a węzłem l.
Klasyfikacja globalna
Jednostka decyzyjna globalna przetwarza decyzje klasyfikacji lokalnych i generuje ostateczne decyzje dotyczące poprawności modelowania gałęzi PS. Aby podjąć ostateczną decyzję o poprawności modelowania wybranej gałęzi, brane są pod uwagę wyniki dwóch klasyfikatorów lokalnych. Klasyfikatory te odpowiadają węzłom końcowym rozważanej gałęzi. Jeżeli decyzje lokalnych klasyfikatorów są różne i żadna z nich nie jest decyzją neutralną lub każdy z lokalnych klasyfikatorów generuje decyzję neutralną, to ostateczna decyzja jest decyzją neutralną. W innych przypadkach ostateczna decyzja jest inna niż decyzja neutralna.
Przykład obliczeniowy
Przedstawioną metodę zaimplementowano w środowisku MATLAB. Metodę przetestowano z wykorzystaniem systemu testowego IEEE 14-bus .

Założono, że: (i) wszystkie gałęzie są faktycznie uruchomione, (ii) brane są pod uwagę pojedyncze i wielokrotne elementy transmisyjne (TE), (iii) dane pomiarowe są obarczone małymi błędami (szum gaussowski), (iv) uwzględniono szeroki zakres zmian krzywej obciążenia. Uczenie każdego lokalnego klasyfikatora (będącego siecią RBFN) przeprowadzono za pomocą algorytmu ortogonalnych najmniejszych kwadratów (OLS) . Zbiory uczenia (200-400 wzorców uczenia) utworzono oddzielnie dla każdego sieci RBFN. Zawierały one wyniki wstępnego przetwarzania wskaźników niewyważenia i odpowiednich decyzji weryfikacyjnych. Uczenie sieci RBFN zostało zatrzymane, gdy błąd sumy kwadratów (SSE) osiągnął poziom 10-4. Dla wyróżnionej sieci RBFN liczba ukrytych jednostek zależy od liczby gałęzi incydentalnych do odpowiedniego węzła. Dla poszczególnych węzłów systemu testowego wytrenowano i przetestowano wiele różnych topologii sieci RBFN. Charakterystykę lokalnych klasyfikatorów o najlepszej wydajności przedstawiono w tabeli 2. Testowanie lokalnych klasyfikatorów przeprowadzono z wykorzystaniem zbioru testowego zawierającego około 2000 wzorców, które nie zostały użyte w fazie uczenia. Rozważono przypadki z pojedynczymi i podwójnymi TE. W przypadkach z pojedynczymi TE wygenerowano tylko poprawne decyzje. W przypadkach z podwójnymi TE zaobserwowano poprawne i neutralne decyzje. Tabela 3 przedstawia prawdopodobieństwo podjęcia neutralnej decyzji pn w procesie weryfikacji dla różnych gałęzi systemu testowego, gdy występują podwójne TE. Na etapie testów wystąpiły pewne przypadki wątpliwe, a dla gałęzi o numerach 19 i 20 podjęto decyzje neutralne. W tych przypadkach nie było możliwości stwierdzenia poprawności rozpatrywanej gałęzi w systemie testowym. Powodem był stosunkowo niski poziom przepływów mocy w tych gałęziach. Uzyskane wyniki wskazują na bardzo wysoką wydajność klasyfikatorów RBF.
TRENDY NA PRZYSZŁOŚĆ
Wykorzystanie sieci neuronowych (SSN) do rozwiązania problemu PSTV wydaje się bardzo obiecujące. Jednak aktualne metody nie dają satysfakcjonujących rezultatów we wszystkich możliwych przypadkach rzeczywistych. Analizy wykazały, że zastosowanie czystych modeli neuronowych nie jest zbyt efektywne. Wykorzystanie SSN i dodatkowa wiedza na temat PSTV może prowadzić do znacznie bardziej wydajnych rozwiązań. Należy również podkreślić, że połączenie różnych technik sztucznej inteligencji może dać interesujące rozwiązania z punktu widzenia wydajności i czasu realizacji procesu PSTV.
WNIOSKI
Przedstawiona metoda pozwala na przeprowadzenie PSTV niezależnie od estymacji stanu. Łączy wiedzę na temat PS i wykorzystania sieci RBFN. Wykorzystuje lokalny wpływ TE. Cały proces PSTV obejmuje wiele procesów lokalnych realizowanych za pomocą klasyfikatorów przypisanych do węzłów sieci elektroenergetycznej. Pozwala to uniknąć konstruowania dużej i złożonej sieci neuronowej (SSN) dla całej sieci elektroenergetycznej, jak to ma miejsce w (Vinod Kumar, Srivastava, Shah i Mathur, 1996). Biorąc pod uwagę rozkład procesu PSTV, opisana metoda jest zbliżona do metody z (Garcia-Lagos, Joya, Marin i Sandoval, 1998, 2003), a także do metody z (Delimar, Hebel i Pavić, 2001, 2002, 2003). Jednakże scharakteryzowana metoda wykorzystuje szerszą wiedzę na temat PS niż metoda z (Garcia-Lagos, Joya, Marin i Sandoval, 2003) czy metoda z (Delimar, Hebel i Pavić, 2001, 2002, 2003a, 2003b). Konsekwencją tego faktu jest zmniejszenie rozmiarów sieci neuronowych (ANN), których wykorzystanie jest zakładane przez rozważaną tu metodę, w porównaniu z metodą z (Garcia-Lagos, Joya, Marin i Sandoval, 2003) lub metodą z (Delimar, Hebel i Pavić, 2001, 2002, 2003). Metoda zakłada, że lokalnymi klasyfikatorami są sieci RBFN. Ich proces uczenia jest stosunkowo krótki w porównaniu z wielowarstwowymi sieciami neuronowymi z jednokierunkowym sprzężeniem zwrotnym. Zastosowanie algorytmu OLS zapewnia szybką zbieżność uczenia. Należy jednak podkreślić, że sieci RBFN mają znacznie większą liczbę jednostek ukrytych w porównaniu z wielowarstwowymi sieciami neuronowymi z jednokierunkowym sprzężeniem zwrotnym. Opisana metoda jest w stanie obsłużyć pojedyncze i wiele TE. Pozwala to na przeprowadzenie bardzo wydajnej PSTV. Kolejną zaletą metody jest niska wrażliwość jakości procesu PSTV na zmiany krzywej obciążenia sieci PS.
Szacowanie z zachowaniem prywatności
WSTĘP
Eksploracja danych rozwinęła się z potrzeby zrozumienia ogromnych ilości danych generowanych przez organizacje. Jednak eksploracja danych niesie ze sobą pewne koszty, w tym potencjalne zagrożenia dla poufności i prywatności osób fizycznych. Niniejszy rozdział przedstawia tło eksploracji danych z zachowaniem prywatności (PPDM) i pokrewnej dziedziny ograniczania ujawniania danych statystycznych (SDL). Następnie skupiamy się na szacowaniu z zachowaniem prywatności (PPE) i potrzebie podejścia zorientowanego na dane (DCA) w PPDM. Rozdział kończy się przedstawieniem niektórych możliwych przyszłych trendów.
TŁO
Dojrzałość technologii informatycznych, telekomunikacyjnych, pamięci masowej i baz danych umożliwiła gromadzenie, przesyłanie i przechowywanie ogromnych ilości surowych danych, niewyobrażalnych jeszcze kilka lat temu. Aby surowe dane mogły zostać wykorzystane, muszą zostać przetworzone i przekształcone w informacje i wiedzę, które mają wartość dodaną, na przykład pomagając w skuteczniejszym i wydajniejszym wykonywaniu zadań. Techniki i algorytmy eksploracji danych starają się wspomagać podejmowanie decyzji poprzez analizę przechowywanych danych w celu znalezienia użytecznych wzorców i zbudowania modeli wspomagających podejmowanie decyzji. Wyekstrahowane wzorce i modele pomagają zmniejszyć niepewność w środowiskach decyzyjnych. Często dane mogą zawierać poufne informacje o wcześniej przebadanych osobach. Rodzi to wiele pytań dotyczących prywatności i poufności osób ). Czasami te obawy skutkują odmową udostępniania danych osobowych lub, co gorsza, podawaniem błędnych danych. Wiele przepisów podkreśla znaczenie prywatności i określa granice legalnego wykorzystania zebranych danych. Na przykład w dziedzinie opieki zdrowotnej Departament Zdrowia i Opieki Społecznej Stanów Zjednoczonych (DHHS) dodał nowe standardy i regulacje do ustawy o przenoszalności i odpowiedzialności w ubezpieczeniach zdrowotnych z 1996 r. (HIPAA) w celu ochrony "prywatności niektórych danych osobowych umożliwiających identyfikację pacjenta" (HIPAA, 2003). Grupe i inni wymienia kilkanaście aktów prawnych dotyczących prywatności, wydanych w Stanach Zjednoczonych w latach 1970-2000. Z drugiej strony, te akty i obawy ograniczają, prawnie i/lub etycznie, udostępnianie zbiorów danych do legalnych badań lub w celu uzyskania przewagi konkurencyjnej w sektorze biznesowym. Urzędy statystyczne stoją przed dylematem konfliktu prawnego, czyli tym, co można nazwać "wojną czynów". Chociaż muszą chronić prywatność osób w swoich zbiorach danych, są również prawnie zobowiązane do ich rozpowszechniania. Sprzeczne cele Ustawy o Prywatności z 1974 r. i Ustawy o Wolności Informacji (Freedom of Information Act) to tylko jeden z przykładów tego dylematu . Doprowadziło to do ewolucji w dziedzinie ograniczania ujawniania danych statystycznych (SDL), znanego również jako kontrola ujawniania danych statystycznych (SDC). Metody SDL starają się znaleźć równowagę między użytecznością danych (wiarygodne wyniki analityczne) a bezpieczeństwem danych (prywatność i poufność osób). Ogólnie rzecz biorąc, metody te dążą do (a) ograniczenia dostępu do wartości atrybutów wrażliwych (głównie na poziomie indywidualnym) lub (b) zamaskowania wartości atrybutów poufnych w zbiorach danych, przy jednoczesnym zachowaniu ogólnych cech statystycznych zbiorów danych (takich jak średnia, odchylenie standardowe i macierz kowariancji). Metody perturbacji danych dla mikrodanych stanowią jedną z klas metod maskowania .
Eksploracja danych a analiza statystyczna
Statystycy i badacze przeprowadzają ankiety i gromadzą zbiory danych, które są uznawane za duże, gdy zawierają kilkaset rekordów. Tradycyjne techniki statystyczne są głównymi (i najodpowiedniejszymi) narzędziami do analizy tych zbiorów danych w celu wnioskowania i szacowania parametrów populacji. W przypadku dużych zbiorów danych tradycyjne techniki analizy statystycznej mogą nie być odpowiednimi narzędziami . Po pierwsze, tradycyjna analiza statystyczna może być nieodpowiednia, ponieważ prawie każda niewielka różnica w dużym zbiorze danych staje się statystycznie istotna. Po drugie, duże zbiory danych mogą sugerować, że dane nie zostały zebrane w celu wnioskowania (szacowania parametrów) na temat populacji. Po trzecie, w przedsiębiorstwach znaczna ilość danych jest generowana w wyniku nieplanowanych działań (np. transakcyjnych baz danych), a nie działań zaplanowanych (np. eksperymentów lub badań ankietowych). Dlatego w przypadku dużych zbiorów danych eksploracja danych staje się bardziej odpowiednia. Przykładów dużych zbiorów danych jest wiele. MarketTouch, firma z siedzibą w Georgii w USA, wspiera marketing bezpośredni danymi i narzędziami analitycznymi . Posiada sześcioterabajtową bazę danych o nazwie Real America Database (RADBO), która dostarcza informacji o ponad 93 milionach gospodarstw domowych i 200 milionach osób. Jest ona aktualizowana co miesiąc o ponad 20 milionów rekordów. Urzędy statystyczne również doświadczają tego zjawiska szybkiego wzrostu zbiorów danych. Amerykańskie Biuro Spisowe podało, że dane ze Spisu Powszechnego z 2000 roku składają się z "informacji o 115,9 milionach jednostek mieszkalnych i 281,4 milionach osób w Stanach Zjednoczonych". Tak duże rozmiary sugerują potrzebę narzędzi analitycznych odpowiednich dla dużych zbiorów danych i ponownie, narzędzia eksploracji danych naturalnie wchodzą do gry. W związku z tym Biuro udostępnia programom narzędzia do eksploracji danych, takie jak DataFerrett (Federated Electronic Research, Review, Extraction and Tabulation Tool), które mogą być używane do analizy i ekstrakcji danych z TheDataWeb - repozytorium zbiorów danych obejmujących ponad 95 obszarów tematycznych.
Motywacja do eksploracji danych z zachowaniem prywatności (PPDM)
Techniki eksploracji danych mogą prowadzić do poważniejszych zagrożeń dla prywatności i poufności niż analiza statystyczna. Domingo-Ferrer i Torra (2003) łączą metody eksploracji danych z niektórymi narzędziami sztucznej inteligencji (AI) do eksploracji danych i sugerują, że zagrożenia związane z ujawnieniem i ponowną identyfikacją mogą być zwielokrotnione. Narzędzia DM mogą być używane do agregacji lub łączenia zamaskowanych kopii określonego oryginalnego zestawu danych w celu odwrócenia maskowania i odbudowania oryginalnego zestawu danych, co stwarza problem poufności. Jest to szczególnie istotne w przypadku stosowania nieskomplikowanych technik SDL i udostępniania wielu zamaskowanych kopii. Narzędzia DM mogą być również wykorzystywane do egzekwowania integralności i spójności danych w rozproszonych zbiorach danych poprzez ponowną identyfikację różnych rekordów należących do tej samej osoby, co stwarza problem prywatności. Obawy dotyczące prywatności i poufności w przypadku korzystania z narzędzi DM doprowadziły do powstania eksploracji danych z zachowaniem prywatności (PPDM). Głównym celem PPDM jest znajdowanie użytecznych wzorców i budowanie dokładnych modeli na podstawie zbiorów danych bez dostępu do precyzyjnych, oryginalnych wartości osób w rekordach zbiorów danych .
Prace pokrewne w zakresie eksploracji danych z zachowaniem prywatności (PPDM)
Podobnie jak w przypadku klasyfikacji technik eksploracji danych (DM) zaproponowanej przez Berry′ego i Linoffa (2004), techniki eksploracji danych z zachowaniem prywatności (PPDM) można podzielić na: (a) ukierunkowane techniki PPDM: estymację z zachowaniem prywatności i klasyfikację z zachowaniem prywatności oraz (b) niekierowane techniki PPDM: reguły asocjacyjne z zachowaniem prywatności i klasteryzacja z zachowaniem prywatności. Ukierunkowane techniki PPDM próbują modelować relację między zmienną zależną a innymi (niezależnymi) zmiennymi w zamaskowanych zbiorach danych. Estymacja dotyczy ciągłych zmiennych zależnych, a klasyfikacja - zmiennych zależnych kategorycznych lub binarnych. Modele uzyskane z zamaskowanych danych za pomocą ukierunkowanych technik PPDM muszą być takie same (lub podobne) do modeli z oryginalnego zbioru danych na poziomie agregacji, jednocześnie chroniąc prywatność i poufność na poziomie indywidualnym. W niekierowanej PPDM nie występuje pojęcie zmiennej zależnej. Zamiast tego celem jest znalezienie nieznanych wzorców i reguł. Klastrowanie służy do odkrywania (i zazwyczaj profilowania) jednorodnych podzbiorów rekordów danych i często jest wykorzystywane jako narzędzie do wstępnego przetwarzania (na przykład do segmentacji bazy klientów) przed zastosowaniem innej techniki DM . Reguły asocjacyjne służą do odkrywania, które elementy pasują do siebie (są skojarzone). Ponownie, celem PPDM jest uzyskanie podobnych wzorców zarówno z danych zamaskowanych, jak i oryginalnych.
SZACOWANIE Z ZACHOWANIEM PRYWATNOŚCI (PPE)
Koncentrujemy się na szacowaniu z zachowaniem prywatności (PPE) (nazywanym również regresją z zachowaniem prywatności). PPE jest wciąż w powijakach w porównaniu z innymi metodami PPDM, a niektóre podejścia wydają się obiecujące. Sanil i inni zaproponowali algorytm obliczania dokładnych współczynników regresji liniowej wielokrotnej dla rozproszonego pionowo (lub podzielonego) zbioru danych bez udostępniania oryginalnych wartości. Zakłada się, że zbiór danych zawiera pojedynczą wspólną, niepoufną zmienną zależną. Nieudostępniane poufne zmienne niezależne należą do więcej niż dwóch stron (agentów) zaangażowanych w proces szacowania. Wykorzystuje on algorytm bezpiecznego sumowania do udostępniania podsumowania statystycznego (sumy), częściowo wypełnionego przez każdą ze stron, bez ujawniania, jaki jest wkład każdej ze stron w tę statystykę. Suma ta jest potrzebna do iteracyjnego szacowania współczynników regresji. Dzięki temu każda ze stron może dokładnie obliczyć współczynniki zmiennych, których jest właścicielem, i udostępnić je innym stronom. Karr i inni proponują dwa podejścia do budowania wielokrotnej regresji liniowej na podstawie sumy poziomo rozproszonego zbioru danych. Pierwsze podejście (bezpieczna integracja danych) integruje poziomo rozproszone zbiory danych od wielu stron (agentów) w jeden zbiór danych, chroniąc jednocześnie tożsamość źródła danych. Każda ze stron może lokalnie przeprowadzić analizę regresji liniowej na zintegrowanym zbiorze danych. To podejście chroni jedynie tożsamość źródeł danych (tj. tożsamość zaangażowanych stron, a nie tożsamość lub poufność ankietowanych osób). Drugie podejście opiera się na addytywnym charakterze analizy regresji liniowej. Statystyki (a nie dane) potrzebne do obliczenia najmniejszych kwadratów estymatorów współczynników regresji liniowej są współdzielone i integrowane w bezpieczny sposób za pomocą algorytmu bezpiecznego sumowania . Zdalne serwery regresji to metody ograniczania dostępu (a nie maskowania) służące do ochrony mikrodanych w celu budowania modeli regresji liniowej. Chociaż to podejście buduje modele regresji liniowej przy użyciu oryginalnych wartości, użytkownicy zazwyczaj nie mają możliwości sprawdzenia dopasowania swoich modeli. Reiter (2003) zaproponował metodę przezwyciężenia tego ograniczenia, polegającą na uwalnianiu sztucznych, symulowanych (z uwzględnieniem marginesu) zmiennych zależnych i niezależnych, reszt i wartości dopasowanych, które naśladują oryginalne relacje zbudowanych modeli. Ponieważ wiele metod wielowymiarowych, w tym wielowymiarowa regresja liniowa, opiera się na obliczeniach macierzowych, takich jak mnożenie macierzy i odwrotność macierzy, Du i inni zaproponowali bezpieczne protokoły dwustronnych obliczeń macierzowych. Umożliwiają one dwóm agentom wspólne wykonywanie obliczeń macierzowych bez znajomości lub dostępu do oryginalnych, wrażliwych wartości drugiej strony oraz bez udziału strony trzeciej. Powyższe podejścia do PPE koncentrują się wyłącznie na relacjach liniowych. To sprawia, że są one nieco ograniczone w przypadku PPE o bardziej ogólnym przeznaczeniu, gdzie nieliniowe relacje znalezione w danych oryginalnych mogą wymagać zachowania w danych zamaskowanych.
Podejście zorientowane na dane (DCA) do eksploracji danych z zachowaniem prywatności
Jednym z problemów wielu istniejących podejść PPDM jest to, że tworzą one zależność między algorytmem a zbiorem danych. Algorytm PPDM jest zazwyczaj modyfikacją konkretnego algorytmu DM, w celu zapewnienia konkretnej techniki ochrony. Zamaskowane dane można zatem analizować tylko przy użyciu tego konkretnego (skrojonego na miarę) algorytmu eksploracji danych. W przeciwnym razie nie ma gwarancji, że wyniki analizy zamaskowanego zbioru danych będą takie same lub podobne do wyników analizy oryginalnego zbioru danych. Nie jest to dobry pomysł, ponieważ osoby zajmujące się eksploracją danych zazwyczaj używają więcej niż jednego algorytmu do eksploracji zbioru danych. Badanie wszystkich algorytmów eksploracji danych, a także ich modyfikowanie, jest niewykonalne. Po drugie, po udostępnieniu zbioru danych nie ma gwarancji, który algorytm może zostać zastosowany, co może prowadzić do błędnych wniosków i działań. Zamiast tego, jak sugerują Al-Ahmadi i in. (2004) zbiory danych powinny być chronione lub maskowane bez odniesienia do konkretnego algorytmu DM. Oliveira i Zaïane popierają koncepcję podejścia skoncentrowanego na danych (DCA), która zakłada, że algorytm maskowania nie musi być powiązany z algorytmem eksploracji danych, ale musi opierać się na charakterystyce zbioru danych i jego późniejszym wykorzystaniu. Na przykład, dobry algorytm PPE zamaskuje zbiór danych w oparciu o rodzaj relacji, które muszą być zachowane w zamaskowanym zbiorze danych. Nie będzie on jednak nakazywał użycia konkretnego algorytmu eksploracji danych do przeprowadzenia estymacji z wykorzystaniem zamaskowanych danych. Al-Ahmadi (2006) przedstawia kilka algorytmów PPE wykorzystujących podejście DCA. Oliveira i Zaïane (2004) również zastosowali koncepcję DCA, opracowując nowy algorytm klastrowania PPDM o nazwie Rotation-Based Transformation (RBT), który umożliwia stosowanie dowolnych algorytmów klastrowania opartych na odległości w maskowanych zbiorach danych.
TRENDY NA PRZYSZŁOŚĆ
Metody perturbacji danych i maskowania SDL mogą stanowić dobry punkt wyjścia do implementacji DCA w PPE i PPDM. Jedną z zastosowanych metod ochrony jest prosta addytywna metoda perturbacji danych (SADP), która ma niepożądane cechy pod względem użyteczności i bezpieczeństwa danych Większość nowszych i bardziej zaawansowanych metod perturbacji danych i maskowania SDL, takich jak C-GADP , IPSO , EGADP oraz tasowanie danych , nie została zbadana w dziedzinie PPE i ogólnej PPDM. Jedynym wyjątkiem jest metoda GADP , która pojawia się w kilku badaniach nad klasyfikacją chroniącą prywatność . W związku z tym istnieje potrzeba zbadania możliwości wykorzystania niektórych z tych zaawansowanych metod maskowania SDL w PPE i PPDM. Z innej perspektywy, w zbiorze danych mogą istnieć różne typy relacji. Na przykład wielowymiarowe zbiory danych o rozkładzie normalnym gwarantują, że wszystkie istniejące relacje między zmiennymi są liniowe. W tym szczególnym przypadku niektóre istniejące metody maskowania SDL są łatwo dostępne i mogą idealnie zachować relacje liniowe. Wynika to z faktu, że większość metod SDL została opracowana w celu zachowania relacji liniowych. Jednak większość (biznesowych) zbiorów danych zawiera relacje nieliniowe, które mogą być monotoniczne lub niemonotoniczne . "Prawdą dotyczącą eksploracji danych, która nie jest szeroko dyskutowana, jest to, że relacje w danych, których poszukuje eksplorator, są albo bardzo łatwe do scharakteryzowania, albo bardzo, bardzo trudne" . W związku z tym istnieje potrzeba opracowania metod maskowania dla PPE i PPDM w celu utrzymania bardziej złożonych typów lub relacji (tj. relacji monotonicznych, nieliniowych i niemonotonicznych).
WNIOSKI
Niniejszy artykuł wprowadził eksplorację danych z zachowaniem prywatności (PPDM) i powiązane z nią koncepcje. Przedstawiono w nim krótki przegląd czterech głównych technik PPDM: estymacji, klasyfikacji, klasteryzacji i reguł asocjacyjnych. Następnie dokonano przeglądu prac wykonanych w ramach Szacowania z Zachowaniem Prywatności (PPE). Na zakończenie omówiono niektóre z możliwych przyszłych trendów w PPDM i PPE, w tym potrzebę badań nad technikami maskowania opartymi na SDL, zorientowanymi na dane, w celu rozwiązania skomplikowanych problemów z PPE.
Spersonalizowane Systemy Wspomagania Decyzji
WSTĘP
Systemy wspomagania decyzji (DSS) to skomputeryzowane systemy, które pomagają ludziom w podejmowaniu decyzji. Wczesne wersje były przeznaczone dla kadry kierowniczej, ale z czasem DSS zaczęto projektować dla pracowników na każdym szczeblu organizacji . Ze względu na rosnące koszty świadczenia i usług, organizacje zmuszają pracowników i konsumentów do wzięcia na siebie coraz większej odpowiedzialności za decyzje dotyczące ubezpieczeń, opieki zdrowotnej i planowania finansowego. Ekstremalne wydarzenia, takie jak terroryzm, pandemie i klęski żywiołowe, przekroczą możliwości agencji rządowych w zakresie obsługi obywateli. Mieszkańcy dotkniętych nimi społeczności muszą zwrócić się o pomoc do lokalnych agencji lub doraźnych grup. Osobiste systemy wspomagania decyzji (PDSS), składające się z baz danych, wiedzy opartej na modelach i inteligentnych interfejsów, wraz z komunikacją bezprzewodową, zasobami internetowymi i komputerami osobistymi, zapewniają wystarczające zasoby, aby pomóc świadomym osobom i grupom w rozwiązywaniu problemów. W niniejszym artykule omówiono typowe komponenty DSS i różne rodzaje systemów, które ewoluowały. W artykule poruszono trzy rodzaje problemów, z którymi borykają się jednostki, w tym rozwiązywanie problemów rutynowych, doraźne potrzeby przetrwania oraz długoterminowy rozwój ewolucyjny. Przedstawiono zagadnienia związane ze wspomaganiem decyzji osobistych, takie jak pozyskiwanie, przetwarzanie i rozpowszechnianie informacji. Omówiono przyszłe trendy i możliwości badawcze.
TŁO
Systemy DSS wspomagają ludzkie myślenie poprzez dostęp do informacji, ich integrację w określony sposób, strukturyzowanie i optymalizację decyzji . Korzyści te uzyskuje się dzięki trzem głównym cechom systemu DSS, które obejmują bazę danych, która rejestruje wiedzę; bazę modeli, która modeluje lub reprezentuje wiedzę specjalistyczną i rozwiązywanie problemów; oraz interfejs, który zapewnia użytkownikowi środki interakcji z innymi komponentami systemu . Powers (2007) scharakteryzował DSS pod kątem sposobu, w jaki system zapewnia wsparcie. Systemy DSS oparte na modelach dla jednostek obejmują arkusze kalkulacyjne. Systemy DSS oparte na danych, takie jak systemy informacji zarządczej (EIS), są wykorzystywane przez organizacje i instytucje do podejmowania decyzji strategicznych i taktycznych. Systemy DSS oparte na komunikacji można znaleźć w oprogramowaniu grupowym, wideokonferencjach i tablicach ogłoszeń. System DSS oparty na dokumentach, taki jak udostępniany przez wyszukiwarki, ułatwia wyszukiwanie dokumentów. System wspomagania decyzji (DSS) oparty na wiedzy byłby wykorzystywany do rozwiązywania specjalistycznych problemów i składałby się z wiedzy reprezentowanej w kategoriach reguł, procedur, ram hierarchicznych lub sieci. Ostatnio internetowe systemy wspomagania decyzji (DSS) znajdują zastosowanie w wyszukiwaniu w przeglądarkach, intranetach i portalach. Systemy wspomagania decyzji (DSS) opierają się na założeniu, że ludzkie rozumowanie jest procesem racjonalnym, choć nie zawsze tak jest, szczególnie w obliczu złożoności i stresu . Wykazano, że decyzje ekspertów w rzeczywistych warunkach charakteryzują się niższą jakością niż modele liniowe. Heurystyki osądzające zmniejszają obciążenie poznawcze, ale obniżają jakość decyzji. Charakterystyka komponentów DSS różni się w systemie PDSS, aby zrekompensować rodzaj problemów, z jakimi borykają się poszczególne osoby. Ogólnie rzecz biorąc, w przypadku PDSS bazy danych są dostosowywane, a bazy modeli są organizowane według preferencyjnych wyników (np. mniej lub bardziej ilościowych), decyzji (np. list i porządkowania wartości) oraz niepewności (konkretnych działań skutkujących zyskiem z uwzględnieniem ograniczeń i ceny).
PERSONALIZOWANE WSPARCIE DECYZYJNE
W niniejszym artykule podsumowano trzy typy problemów, z jakimi borykają się jednostki, w tym rutynowe rozwiązywanie problemów, ekstremalne potrzeby przetrwania oraz długoterminową zmianę. W artykule przedstawiono wymagania architektury systemu w zakresie pozyskiwania i przetwarzania informacji, interakcji z tymi informacjami oraz rozpowszechniania informacji i rekomendacji.
Typy problemów PDSS
Konsument XXI wieku staje przed wieloma rutynowymi problemami, takimi jak wybór kariery, samodoskonalenie, wolontariat, planowanie finansowe, emerytura, ubezpieczenia, zakupy konsumenckie, opieka medyczna i zdrowie osobiste. Zastosowania PDSS można dostrzec w opiece zdrowotnej, od korzystania z osobistych asystentów danych (PDA) w punktach opieki po pomoc pacjentom w podejmowaniu decyzji dotyczących opieki zdrowotnej (Crawford, 1997; Pierce, 1998). Rutynowe problemy składają się ze złożonych opcji o krótkoterminowych korzyściach i nieznanych długoterminowych implikacjach. Jednak jednostki mają tendencję do bagatelizowania potrzeby podejmowania decyzji i/lub przekonania, że instytucje i agencje rządowe będą im narzucać swoje decyzje. Drugi typ problemu można sklasyfikować jako przetrwanie. Trzy przykłady obejmują klęski żywiołowe, terroryzm i pandemie. Klęski żywiołowe, takie jak huragany, tornada, powodzie, susze, erupcje wulkanów, trzęsienia ziemi i uderzenia meteorytów, mogą również obejmować stopniowe zmiany spowodowane globalnym ociepleniem. Radykalne zmiany mogą obejmować skutki zimy nuklearnej, przesunięcie orbity Księżyca lub przesunięcie biegunów pola magnetycznego Ziemi. Zastosowania PDSS obejmują zarządzanie katastrofami i próby połączenia technologii mapowania satelitarnego z agencjami rządowymi . Terroryzm stanowi bardziej współczesny problem przetrwania, spowodowany czystkami rasowymi, przemocą między grupami religijnymi, osłabianiem rządów poprzez korupcję i zabójstwa, bronią chemiczną oraz niszczeniem dzielnic i infrastruktury. Zastosowania PDSS dla tego typu problemów pojawiły się w kontekście zwalczania terroryzmu. Pandemie zawsze występowały w historii ludzkości, ale nabrały poważnych konsekwencji ze względu na rozwój technologiczny w dziedzinie genetyki. Problemów przetrwania nie da się przewidzieć ani w pełni scharakteryzować, a ich wpływ przekracza możliwości systemu DSS. Wartość PDSS tkwi w jego proaktywnym potencjale poprzez identyfikację zasobów krajowych, stanowych i lokalnych, rekomendowanie działań i inicjowanie rozwoju instytucjonalnego wsparcia i świadomości, którego wcześniej nie było. Trzecim typem problemu są zmiany ewolucyjne lub długoterminowe, wynikające z uświadomienia sobie, że istniejące ścieżki decyzyjne mogą prowadzić do istotnych konsekwencji. Świadomość problemów związanych ze zmianą sygnalizuje potrzebę podejmowania przez ludzi długoterminowych, proaktywnych decyzji w świetle wielu ścieżek lub scenariuszy. Proaktywne podejmowanie decyzji pozwala ludziom uświadomić sobie i rozwiązać poważne konsekwencje wcześniejszych decyzji jednostek, grup, instytucji i rządów, a także wpływ innowacji technologicznych. Jednak problemy związane ze zmianą mają zazwyczaj niski priorytet, wymagają znacznych zasobów i opierają się konsensusowi ze względu na swoją pozorną trudność. Symulacje i środowiska wirtualne mogą być potrzebne, aby pomóc obywatelom w interakcji z potencjalnymi ścieżkami.
Architektura Wspomagania Decyzji Osobistych
Wczesne poglądy definiowały osobisty system wspomagania decyzji jako taki, który koncentruje się na odrębnym zadaniu lub decyzji . Przykłady często obejmowały wsparcie grupowe, takie jak DSS Mortona (1971), który obejmował zarówno marketing, jak i planowanie produkcji. Keen i Hackathorn (1986) zidentyfikowali trzy główne części osobistego DSS, obejmujące interfejs między maszyną a użytkownikiem, odpowiednich operatorów (tj. czasowniki czynności, takie jak "pomoc") oraz bazę danych. Rozwój osobistego DSS wymaga uwagi poświęconej dialogowi, udoskonaleniu słownictwa-operatorów i ewolucji struktury danych bazy danych. PDSS, jak opisano tutaj, obejmowałby zarówno potrzeby indywidualne, jak i społeczne, a zatem byłby hybrydowymi wersjami kilku typów DSS . PDSS zawierałby narzędzia matematyczne i statystyczne (oparte na modelach) do obliczania i wnioskowania na podstawie danych liczbowych. Wyszukiwałyby one formularze i informacje (oparte na dokumentach) w celu wspierania podejmowania decyzji. Wykorzystywałyby informacje i dane jako dane wejściowe do zaspokajania specjalistycznych potrzeb (opartych na wiedzy), takich jak opieka zdrowotna, ubezpieczenia, możliwości kariery i planowanie podróży, między innymi. System PDSS składałby się zarówno z zasobów zlokalizowanych (systemy komputerów osobistych), jak i rozproszonych (opartych na sieci) źródeł, gdzie informacje i obliczenia mogłyby być przeprowadzane w innych lokalizacjach. Do głównych systemów PDSS należą bazy danych, modele wnioskowania, interfejs i opcje komunikacji. Każdy z tych czterech systemów można porównać do pozyskiwania informacji, przetwarzania ich w sposób umożliwiający ich wykorzystanie przez wyspecjalizowane moduły decyzyjne (np. w zakresie ubezpieczeń, opieki zdrowotnej, planowania podróży), wizualnej interakcji z informacjami oraz komunikowania lub udostępniania decyzji lub informacji innym.
Pozyskiwanie informacji
Bazy danych stanowią repozytorium informacji w dowolnym systemie DSS. Spersonalizowana wersja systemu DSS łączyłaby lokalne bazy danych, opracowywane indywidualnie dla określonych potrzeb, ze zdalnymi, zintegrowanymi bazami danych. Bazy te składałyby się z niespójnych struktur, podczas gdy w dłuższej perspektywie wymagana byłaby pewna standaryzacja struktury bazy danych, aby stworzyć spersonalizowaną, zintegrowaną bazę danych. Ponadto, przeglądanie ad hoc ma tendencję do charakteryzowania indywidualnych potrzeb informacyjnych, z niewielkim uwzględnieniem organizacji tych informacji w perspektywie długoterminowej.
Przetwarzanie informacji
Jedną z potężnych cech systemu DSS jest jego baza modeli. Modelowanie pozwala na zastosowanie wiedzy w różnych problemach i ułatwia analizę, wyjaśnienia i orędownictwo . Baza modeli zawierałaby jeden lub więcej modeli lub reprezentacji wiedzy specjalistycznej, od wysoce wyspecjalizowanych (np. wartość domu z rynku wtórnego) do bardziej ogólnych (np. model osoby uczącej się). Bazy modeli mogą stać się obiektowe i zostać włączone do systemu PDSS jako wtyczka programowa w razie potrzeby. Ogólne wersje systemu PDSS mogą obejmować szereg wspólnych komponentów modelu dotyczących potrzeb finansowych, zatrudnienia, podróży i zdrowia, a także zapewniać symulacje pomagające użytkownikowi zrozumieć implikacje podejmowanych decyzji. Integracja baz modeli, podobnie jak w przypadku baz danych, będzie wymagała pewnej standaryzacji struktury modelu w oparciu o pewne wspólne kategorie. Osobiste wzorce rozumowania mogą być również archiwizowane, aby zapewnić szybkość i opcje rozwiązywania nowych problemów. Najważniejsze i najtrudniejsze do zarchiwizowania i scharakteryzowania byłyby informacje kontekstowe, przykład danych nieustrukturyzowanych. Wersja systemu odgórna, która zwiększyłaby strukturę danych kontekstowych, polegałaby na kategoryzacji określonych, rutynowych kontekstów, takich jak finanse, zdrowie czy wybór uczelni. Kategorie ekstremalnego przetrwania mogłyby obejmować klęski żywiołowe i inne rodzaje sytuacji kryzysowych, przestępczość i terroryzm oraz pandemie. Oddolna wersja systemu reprezentacji kontekstu polegałaby na identyfikacji wzorców informacji za pomocą sieci semantycznych , a z czasem budowano by mapę kontekstu w celu scharakteryzowania poszczególnych kategorii kontekstu. Interakcja z informacją. Dialog międzyludzki z bazami danych i modelami bazowymi wykorzystywał interfejs wizualny, który zazwyczaj zawierał metaforę pulpitu. Do tej pory użytkownicy polegali na prezentowanej im metaforze. Dostosowany interfejs mógłby nadal wykorzystywać metaforę pulpitu do organizowania indywidualnych potrzeb problemowych. Inne opcje mogłyby być dostępne i opracowane na zamówienie, które nadal mogłyby opierać się na inwentarzu wyborów lub na jakiejś metaforze wyboru. Specjalistyczne interfejsy mogłyby być używane w zależności od rodzaju problemu (rutyna, przetrwanie, zmiana), aby ułatwić podejmowanie decyzji. Potrzeby przetrwania wymagają, aby użytkownikowi nie prezentowano zbyt wielu opcji, ale raczej trafne opcje, aby zaspokoić natychmiastową potrzebę. Te wizualne widoki "just-in-time" prezentują tylko potrzebne informacje i porady .
Rozpowszechnianie informacji
Funkcja rozpowszechniania, obejmująca komunikację i dzielenie się informacjami oraz opcjami decyzyjnymi z innymi, stanowi kluczowy element systemu PDSS. Podczas gdy rutynowe problemy dotyczą jednostki, problemy związane z przetrwaniem i zmianą wymagają współpracy. Wielopunktowe udostępnianie informacji ułatwia podejmowanie decyzji. Wraz ze wzrostem popularności łączności bezprzewodowej w wielu urządzeniach technologicznych, rozpowszechnianie i komunikacja stają się coraz powszechniejsze. Termin "bezprzewodowy" może stać się przestarzały, ponieważ staje się przejrzysty i powszechny. Informacje mogą być publikowane dla wszystkich lub określonych odbiorców, a także edytowane lub linkowane do innych źródeł. Wiele z tych informacji i współpraca mogą być kierowane przez osobiste portale, które porządkują informacje dla innych użytkowników .
TRENDY PRZYSZŁOŚCI
Metafora Projektu Przyszłości
Jedną z funkcji DSS jest wyszukiwanie informacji, co umożliwia podejmowanie decyzji w oparciu o te informacje i inne źródła. Decyzje są następnie podejmowane na podstawie istniejących danych lub danych z przeszłości. Cele dotyczące zysków i redukcji kosztów opierają się na scenariuszach "co by było, gdyby" i symulacjach opartych na założeniach. Jednakże jednostki rzadko skupiają się na przeszłości, a raczej na teraźniejszości i niedalekiej przyszłości. Chociaż przyszłości nie da się przewidzieć, trendy oparte na danych z przeszłości i teraźniejszości dają obraz tego, na jakim etapie jesteśmy w biznesie, karierze lub życiu osobistym. Podejmowanie decyzji o tym, jak chcemy, aby wyglądało nasze życie dla nas samych, naszych rodzin i naszych społeczności, a nawet "w jakim biznesie działamy?", wymaga innego spojrzenia na projektowanie przyszłości, które nie polega na przewidywaniu przyszłości, ale raczej na dążeniu do niej w oparciu o naszą intencję ciągłego przemyśliwania, projektowania i ulepszania.
Rząd i społeczność
Odpowiedzialność za codzienne życie zawsze była domeną jednostki i rodziny. Jednak historyczna rzeczywistość jest taka, że codzienne życie było stale ograniczane przez instytucje i rządy oraz przez niewidoczne konsekwencje innowacji technologicznych. Wiele aspektów codziennego życia wymaga poruszania się wśród tych ograniczeń i wpływów. Napięcia te można jednak złagodzić, wykorzystując osobistą wiedzę i motywację, wiarę w branie odpowiedzialności za nasze życie i nasze społeczności oraz projektując narzędzia technologiczne z myślą o tym, dokąd chcemy dotrzeć - wszystkie te cechy przyszłego podejścia do projektowania.
Możliwości badawcze
Jednym ze sposobów prowadzenia badań jest nadanie większej struktury nieustrukturyzowanym danym, w tym informacjom ze źródeł zdalnych, lokalnie tworzonym bazom danych i informacjom kontekstowym. W jaki sposób te różne źródła informacji można zintegrować i uogólnić do użytku przez innych? Jak można scharakteryzować kontekst w kategoriach obiektów wielokrotnego użytku? Ekspertyza w zakresie modelowania stanowi od dawna wyzwanie w dziedzinie sztucznej inteligencji. Modelowanie decyzji dotyczących rutynowych problemów, które można scharakteryzować za pomocą reguł lub procedur, z wykorzystaniem statycznych modeli domenowych, okazało się najbardziej skuteczne. Jednak ważniejszym pytaniem, wykraczającym poza pytanie "Co wiemy?", staje się pytanie "Jak model się aktualizuje?". Podejmowanie decyzji w sytuacjach przetrwania będzie wymagało dostosowanych baz modeli opracowanych specjalnie dla kategorii ekstremalnego przetrwania. W tego typu sytuacjach problemy są wyjątkowe i konieczne będzie opracowanie narzędzi pozwalających na wizualizację przekonań użytkowników na temat niepewności i preferencji dotyczących różnych rezultatów . Ewolucyjne podejmowanie decyzji, czyli podejmowanie decyzji wpływających na długoterminowe zmiany, będzie wymagało, aby bazy modeli ewoluowały w oparciu o nowe dane. Ciągłe redefiniowanie wiedzy specjalistycznej stwarza możliwości analizy codziennych działań ludzi oraz tego, jak codzienna, rutynowa wiedza specjalistyczna staje się kluczowa dla jednostek i grup. Co więcej, można by przeprowadzić badania nad tym, jak świadomi obywatele tworzą nowe społeczeństwa, kultury epistemiczne, które same tworzą nowe zasoby wiedzy . Te nowe społeczeństwa mogą obejmować bloki rodzinne, społeczności internetowe, fizyczne dzielnice, miasta, kraje lub regiony geograficzne. Idea PDSS nie ogranicza się do jednostki, ale do personalizacji życia ludzkiego jako narzędzi wspomagających rozwój jednostek, dzielnic i miast . Problemem dla badaczy i projektantów jest uświadomienie sobie, że projektując systemy, które są mniej logiczne, a bardziej odzwierciedlają chaos rzeczywistego życia, mogą pomóc ludziom zrozumieć, co to znaczy być człowiekiem . Innym kierunkiem badań byłoby badanie, w jaki sposób użytkownicy mogą określać interfejs użytkownika, opierając się na osobistych metaforach lub konkretnych potrzebach, zamiast reagować na standardową metaforę. Badanie modeli mentalnych i sposobu, w jaki ludzie projektują znaczenie swoich doświadczeń na nowe doświadczenia, może zapewnić nowe sposoby myślenia i działania wykraczające poza stare reguły . Nie wszystkie problemy i sytuacje wymagają tego samego interfejsu, zwłaszcza że powaga problemu może wymagać projektu skoncentrowanego na bezpośredniości i ograniczonym wyborze. Dalsza współpraca między badaczami sztucznej inteligencji badającymi reprezentację i rozumowanie a badaczami interakcji człowiek-komputer (HCI), w których uwzględnia się interakcję, może prowadzić do powstania inteligentnych interfejsów z elastycznym planowaniem, uwzględniających ograniczenia ludzkie (np. czas, cierpliwość, uwagę, motywację, wymagania poznawcze) oraz trafność kontekstu . Takie inteligentne interfejsy mogą pojawić się najpierw w urządzeniach bezprzewodowych, takich jak PDA.
WNIOSKI
Organizacje i agencje rządowe przerzucają na konsumentów konkretne umiejętności i obowiązki niezbędne do życia w XXI wieku. Jednostki potrzebują obecnie więcej czasu na podejmowanie ważnych decyzji związanych z życiem osobistym i zawodowym. Te osobiste decyzje przyczyniają się do rosnącej złożoności ludzkiego życia i wymagają czasu oraz zasobów. Rozwój technologiczny w dziedzinie informatyki, sieci i komunikacji daje ludziom możliwość podejmowania świadomych decyzji. W obliczu zagrożeń dla przetrwania i długoterminowych zmian, świadome grupy obywateli mogą inicjować proaktywne priorytety w swoich rządach krajowych, stanowych i lokalnych, aby rozwiązać te potencjalne problemy. System PDSS z funkcjami umożliwiającymi komunikację i współpracę tworzy narzędzie, które pomaga jednostkom wziąć odpowiedzialność za podejmowanie decyzji, zamiast polegać na rządzie i instytucjach. Spersonalizowane wsparcie decyzyjne, charakteryzujące się dostępem do zasobów internetowych, zintegrowanych baz wiedzy oraz komputerów osobistych i komunikacji bezprzewodowej, może dostarczać ludziom informacji i rekomendacji, które pomagają rozwiązywać problemy, reagować na sytuacje kryzysowe i poprawiać jakość życia.
Systemy oparte na wiedzy
WSTĘP
Narzędzia sztucznej inteligencji (AI) można podzielić na dwa szerokie typy: systemy oparte na wiedzy (KBS) i inteligencję obliczeniową (CI). KBS wykorzystują jawne reprezentacje wiedzy w postaci słów i symboli. Ta jawna reprezentacja sprawia, że wiedza jest łatwiejsza do odczytania i zrozumienia dla człowieka niż numerycznie wyprowadzone niejawne modele w inteligencji obliczeniowej. KBS obejmują techniki takie jak rozumowanie oparte na regułach, modelach i przypadkach. Były one jednymi z pierwszych form badań nad AI i nadal stanowią ważny temat. Wczesne badania koncentrowały się na specjalistycznych zastosowaniach w takich dziedzinach jak chemia, medycyna i sprzęt komputerowy. Te wczesne sukcesy wywołały wielki optymizm w dziedzinie AI, ale osiągnięcie szerzej zakrojonych reprezentacji ludzkiej inteligencji nadal jest trudne .
TŁO
Główna różnica między systemem opartym na wiedzy a programem konwencjonalnym leży w jego strukturze. W programie konwencjonalnym wiedza dziedzinowa jest ściśle powiązana z oprogramowaniem kontrolującym jej zastosowanie. W systemie opartym na wiedzy te dwie role są wyraźnie rozdzielone. W najprostszym przypadku istnieją dwa moduły: moduł wiedzy nazywany jest bazą wiedzy, a moduł sterujący - silnikiem wnioskowania. System praktyczny wymaga również pewnych możliwości interfejsu, jak pokazano na rysunku 1. W bazie wiedzy programista wyraża informacje o problemie do rozwiązania.Często informacje te mają charakter deklaratywny, tj. programista podaje pewne fakty, reguły lub zależności, nie musząc zajmować się szczegółami, jak i kiedy te informacje powinny zostać zastosowane. Te ostatnie szczegóły są określane przez silnik wnioskowania, który korzysta z bazy wiedzy tak, jak program konwencjonalny korzysta z pliku danych. System KBS jest analogiczny do ludzkiego mózgu, którego procesy sterowania są w zasadzie niezmienne, podobnie jak silnik wnioskowania, nawet pomimo tego, że indywidualne zachowanie jest stale modyfikowane przez nową wiedzę i doświadczenie, takie jak aktualizacja bazy wiedzy. Ponieważ wiedza jest reprezentowana jawnie w bazie wiedzy, a nie niejawnie w strukturze programu, może być wprowadzana i aktualizowana stosunkowo łatwo przez ekspertów dziedzinowych, którzy mogą nie posiadać żadnej wiedzy programistycznej. Inżynier wiedzy to osoba, która stanowi pomost między wiedzą specjalistyczną a implementacją komputerową. Inżynier wiedzy może wykorzystać metawiedzę, tj. wiedzę o wiedzy, aby zapewnić skuteczną implementację. Tradycyjna inżynieria wiedzy opiera się na modelach ludzkich pojęć. Jednak ostatnio argumentowano, że zwierzęta i dzieci przedjęzykowe skutecznie funkcjonują w złożonym świecie, niekoniecznie posługując się pojęciami. Moss (2007) wykazał, że agenci wykorzystujący rozumowanie niekonceptualne mogą przewyższyć agentów bodziec-reakcja w środowisku testowym świata siatki. Wyniki te mogą uzasadniać budowę modeli niekonceptualnych przed przejściem do modeli koncepcyjnych.
TYPY SYSTEMÓW OPARTYCH NA WIEDZY
Systemy eksperckie
Systemy eksperckie to rodzaj systemu opartego na wiedzy, zaprojektowanego w celu ucieleśnienia wiedzy specjalistycznej w określonej, specjalistycznej dziedzinie, takiej jak diagnozowanie wadliwego sprzętu (Yanga, 2005). System ekspercki ma działać jak ekspert, z którym można się konsultować w zakresie szeregu problemów z zakresu jego specjalizacji. Zazwyczaj użytkownik systemu eksperckiego wchodzi w dialog, w którym opisuje problem - na przykład objawy usterki - a system ekspercki oferuje porady, sugestie lub zalecenia. Często sugeruje się, że system ekspercki musi oferować pewne możliwości, które odzwierciedlają możliwości konsultanta. W szczególności często stwierdza się, że system ekspercki musi być w stanie uzasadnić swój aktualny kierunek badań i wyjaśnić swojerozumowanie w celu dojścia do wniosku.Funkcję tę można zintegrować z silnikiem wnioskowania.
Systemy oparte na regułach
Reguły są jednym z najprostszych sposobów reprezentacji wiedzy w systemie KBS. Najprostszy typ reguły nazywa się regułą produkcji i ma postać: if
Przykładowa reguła produkcji dotycząca systemu kotłowego może wyglądać następująco:
/* reguła1 */
jeśli zawór jest otwarty, a przepływ jest wysoki, to para ucieka. Jedną z zalet stosowania reguł produkcji jest to, że często można je zapisać w formie zbliżonej do języka naturalnego, w przeciwieństwie do języka komputerowego. Fakty w systemie KBS do monitorowania kotła mogą obejmować:
/* fakt1 */
zawór jest otwarty
/* fakt2 */
przepływ jest wysoki
Jeden lub więcej podanych faktów może spełniać warunek reguły, co skutkuje wygenerowaniem nowego faktu, znanego jako fakt pochodny. Na przykład, stosując regułę 1 do faktu 1 i faktu 2, można wyprowadzić fakt 3:
/* fakt 3 */
para ucieka Wyprowadzony fakt może spełniać warunek innej reguły, takiej jak:
/* reguła 2 */
jeśli para ucieka lub zawór jest zablokowany, wylot jest zablokowany. To z kolei może prowadzić do wygenerowania nowego wyprowadzonego faktu lub działania. Reguła 1 i reguła 2 są współzależne, ponieważ wniosek jednej może spełniać warunek drugiej. Wzajemne zależności między regułami definiują sieć, jak pokazano na rysunku 2, znaną jako sieć wnioskowania. Zadaniem silnika wnioskowania jest przejście przezsieć wnioskowania, aby dojść do wniosku. Można wyróżnić dwa ważne typy silnika wnioskowania: łańcuchowy i łańcuchowy, znane również odpowiednio jako napędzany danymi i napędzany celem. System KBS działający w trybie napędzanym danymi pobiera dostępne informacje, tj. podane fakty, i generuje jak najwięcej wyprowadzonych faktów. W trybie zorientowanym na cel poszukuje się dowodów na poparcie określonego celu lub tezy. Podejście zorientowane na dane (powiązanie w przód) może być zazwyczaj stosowane w przypadku problemów interpretacyjnych, gdzie celem jest ustalenie, co system może wywnioskować na podstawie danych. Podejście zorientowane na cel (powiązanie w tył) jest odpowiednie, gdy wymagane jest ściślej ukierunkowane rozwiązanie, takie jak wygenerowanie planu dla określonego celu. W przykładzie systemu monitorowania kotła, powiązanie w przód prowadziłoby do zgłoszenia wszelkich rozpoznanych problemów. Natomiast powiązanie w tył może być wykorzystane do zdiagnozowania konkretnego rodzaju awarii poprzez połączenie logicznej sekwencji wniosków, ignorując niezwiązane z nią obserwacje. Reguły tworzące sieć wnioskowania na rysunku 2 służą do powiązania przyczyny i skutku:
jeśli
Korzystając z sieci wnioskowania, można wyciągnąć wniosek, że jeśli zawór jest otwarty, a natężenie przepływu jest wysokie (przyczyny), to para ulatnia się (skutek). Na tym polega proces dedukcji. Wiele problemów, takich jak diagnoza, wymaga rozumowania w odwrotnym kierunku, tj. użytkownik chce ustalić przyczynę, mając dany skutek.To jest abdukcja. Biorąc pod uwagę obserwację ulatniania się pary, abdukcja może posłużyć do wywnioskowania, że zawór jest otwarty, a natężenie przepływu jest wysokie. Jest to jednak słuszny wniosek tylko wtedy, gdy sieć wnioskowania wskazuje wszystkie okoliczności, w których może dojść do ulatniania się pary. Jest to założenie o zamkniętym świecie. Jeśli dostępnych jest wiele przykładów przyczyn i skutków, można wywnioskować regułę (lub sieć wnioskowania), która je łączy. Na przykład, jeśli każdemu zatkaniu kotła towarzyszył ulatnianie się pary i zablokowanie zaworu, to powyższa reguła 2 może zostać wywnioskowana z tych przykładów. Wnioskowanie o regule na podstawie zestawu przykładowych przypadków przyczyn i skutków nazywa się indukcją. Hopgood (2001) podsumowuje dedukcję, abdukcję i indukcję w następujący sposób:
o dedukcja: przyczyna + reguła ? skutek
o abdukcja: skutek + reguła ? przyczyna
o indukcja: przyczyna + skutek ? reguła
Programowanie logiczne
Programowanie logiczne opisuje wykorzystanie logiki do ustalenia prawdziwości lub nieprawdziwości tezy. Jest to zatem podstawowa zasada systemów opartych na regułach. Chociaż badano różne formy programowania logicznego, najczęściej używaną jest język Prolog (Bramer, 2005), który ucieleśnia cechy wstecznego łańcucha, dopasowywania wzorców i manipulacji listami. Język Prolog można programować deklaratywnie, chociaż do efektywnego programowania potrzebna jest znajomość proceduralnego zachowania języka. Prolog nadaje się do rozwiązywania problemów symbolicznych, w szczególności problemów logicznych obejmujących relacje między elementami. Nadaje się również do zadań związanych z wyszukiwaniem i pobieraniem danych, ponieważ dopasowywanie wzorców jest fundamentalne dla funkcjonalności języka.
Obliczenia symboliczne
Baza wiedzy może zawierać kombinację liczb, liter, słów, znaków interpunkcyjnych i pełnych zdań. Symbole te muszą zostać rozpoznane i przetworzone przez silnik wnioskowania. Listy są szczególnie użyteczną strukturą danych do obliczeń symbolicznych i stanowią integralną część języków sztucznej inteligencji Lisp i Prolog. Listy umożliwiają łączenie słów, liczb i symboli na wiele różnych sposobów. Lista w języku Prolog może wyglądać następująco:
[zwierzę, [kot, pies], warzywo, minerał]
gdzie ten przykład zawiera listę zagnieżdżoną, tj. listę w liście. Do przetwarzania list lub podobnych struktur stosowana jest technika dopasowywania wzorców. Na przykład powyższa lista w Prologu mogłaby pasować do listy [zwierzę, [_, X], warzywo, Y], gdzie zmiennym X i Y przypisano by odpowiednio wartości pies i minerał. Ta zdolność dopasowywania wzorców stanowi podstawę zdolności silnika wnioskowania do przetwarzania reguł, faktów i rozwijającej się wiedzy.
Niepewność
Wszystkie dotychczasowe przykłady dotyczyły jednoznacznych faktów i reguł, co prowadziło do jednoznacznych wniosków. W rzeczywistości sytuację mogą komplikować trzy formy niepewności:
Niepewność w samej regule
Na przykład, reguła 1 (powyżej) stwierdzała, że otwarty zawór i wysoki przepływ prowadzą do ucieczki pary. Jednakże, jeśli kocioł wszedł w nieprzewidziany tryb, można było uznać, że te warunki nie prowadzą do ucieczki pary. Reguła powinna w rzeczywistości stwierdzać, że otwarty zawór i wysoki przepływ prawdopodobnie doprowadzą do ucieczki pary.
Niepewność w dowodach
Istnieją dwa możliwe powody, dla których dowody, na których opiera się reguła, mogą być niepewne. Po pierwsze, dowody mogą pochodzić ze źródła, które nie jest całkowicie wiarygodne. Na przykład, w regule 1 może występować element wątpliwości, czy natężenie przepływu jest wysokie, ponieważ informacja taopiera się na liczniku o nieokreślonej wiarygodności. Po drugie, same dowody mogły zostać wyprowadzone na podstawie reguły, której wniosek był prawdopodobny, a nie pewny.
Użycie niejasnego języka
Powyższa Reguła 1 opiera się na pojęciu "wysokiego" natężenia przepływu. Nie ma pewności co do tego, czy "wysokie" oznacza natężenie przepływu rzędu 1 cm3s-1, czy 1 m3s-1. Dwie popularne techniki radzenia sobie z pierwszymi dwoma źródłami niepewności to aktualizacja bayesowska i teoria pewności (Hopgood, 2001). Aktualizacja bayesowska ma rygorystyczne wyprowadzenie oparte na teorii prawdopodobieństwa, ale jej założenia, np. statystyczna niezależność wielu dowodów, mogą nie być prawdziwe w praktycznych sytuacjach. Teoria pewności nie ma ścisłych podstaw matematycznych, ale została opracowana jako praktyczny i pragmatyczny sposób na pokonanie niektórych ograniczeń aktualizacji bayesowskiej. Po raz pierwszy została zastosowana w klasycznym systemie MYCIN do diagnozowania chorób zakaźnych (Buchanan, 1984). Inne podejścia omówiono w pracy (Hopgood, 2001), gdzie również zaproponowano praktyczne, niematematyczne podejście polegające na traktowaniu wniosków z reguł jako hipotez, które można potwierdzić lub obalić działaniem innych reguł. Teoria możliwości, czyli logika rozmyta, pozwala na precyzyjne wykorzystanie trzeciej formy niepewności, tj. języka niejasnego.
Wspomaganie decyzji i analiza
Wspomaganie decyzji i analiza (DSA) oraz systemy wspomagania decyzji (DSS) opisują szeroką kategorię systemów, które obejmują generowanie alternatyw i dokonywanie wyboru spośród nich. Internetowe DSA, wykorzystującezewnętrzne źródła informacji, zyskują na znaczeniu. Systemy wspomagania decyzji wykorzystujące techniki sztucznej inteligencji są czasami nazywane inteligentnymi DSS. Jedną z wyraźnie identyfikowalnych rodzin inteligentnych DSS są systemy eksperckie, opisane powyżej. System ekspercki może zawierać mieszankę prostych reguł opartych na doświadczeniu i obserwacji, znanych jako reguły heurystyczne lub płytkie, oraz reguł bardziej fundamentalnych lub głębokich. Na przykład system ekspercki do diagnozowania awarii samochodu może zawierać heurystykę sugerującą sprawdzenie akumulatora, jeśli samochód nie chce się uruchomić. Z kolei system ekspercki może również zawierać reguły głębokie, takie jak prawa Kirchhoffa, które mają zastosowanie do dowolnego obwodu elektrycznego i mogą być wykorzystywane w połączeniu z innymi regułami i obserwacjami do diagnozowania dowolnego obwodu elektrycznego. Heurystyki często mogą zapewnić użyteczny skrót do rozwiązania, ale brakuje im adaptacyjności głębokiej wiedzy. Zbudowanie i utrzymanie niezawodnego zestawu par przyczyna-skutek w formie reguł może być ogromnym zadaniem. Zasada wnioskowania opartego na modelach (MBR) polega na tym, że zamiast przechowywać ogromną kolekcję par symptom-przyczyna w formie reguł, pary te można generować, stosując do modelu zasady leżące u ich podstaw. Model może opisywać dowolny rodzaj systemu, w tym systemy fizyczne , oparte na oprogramowaniu , medyczne prawne i behawioralne . Modele systemów fizycznych składają się z fundamentalnych komponentów, takich jak rury, przewody, baterie i zawory. Ponieważ każdy z tych komponentów pełni dość prostą rolę, ma również prosty tryb awarii. Mając model działania i interakcji tych komponentów, tworząc urządzenie, usterki można diagnozować, określając wpływ lokalnych usterek na całe urządzenie. Wnioskowanie oparte na przypadkach (CBR) odgrywa również ważną rolę w wnioskowaniu opartym na przypadkach. Cechą ludzkiej inteligencji jest zdolność do przywoływania wcześniejszych doświadczeń w przypadku wystąpienia podobnego problemu. Jest to istota rozumowania opartego na przypadkach (CBR), w którym nowe problemy są rozwiązywane poprzez adaptację poprzednich rozwiązań do starych problemów. Rozważmy przykład diagnozowania zepsutego samochodu. Jeśli system ekspercki pomyślnie zdiagnozował awarię, biorąc pod uwagę zestaw symptomów, może zapisać te informacje do wykorzystania w przyszłości. Jeśli system ekspercki otrzyma następnie szczegółowe informacje na temat innego zepsutego samochodu dokładnie tego samego typu, wykazującego dokładnie te same objawy w dokładnie tych samych okolicznościach, diagnozę można ukończyć po prostu przywołując poprzednie rozwiązanie. Jednak pełny opis symptomów i środowiska musiałby być bardzo szczegółowy i jest mało prawdopodobne, aby został on dokładnie odtworzony. Potrzebna jest umiejętność zidentyfikowania poprzedniego przypadku, którego rozwiązanie można ponownie wykorzystać lub zmodyfikować, aby odzwierciedlić nieznacznie zmienione okoliczności, a następnie zapisać do wykorzystania w przyszłości. Takie podejście jest dobrym modelem ludzkiego rozumowania. Rzeczywiście, rozumowanie oparte na analizie przypadków jest często stosowane w sposób półautomatyczny, gdzie człowiek może interweniować na dowolnym etapie cyklu.
PRZYSZŁE TRENDY
Chociaż duże korporacyjne systemy oparte na wiedzy nadal odgrywają ważną rolę, w domach i miejscach pracy zaczęły pojawiać się również małe, wbudowane, inteligentne systemy. Przykładami są pralki z wbudowanym sterowaniem opartym na wiedzy i kreatorami do zarządzania komputerami osobistymi. Dzięki osadzeniu w środowisku, takie systemy są mniej zależne od danych wprowadzanych przez człowieka niż tradycyjne systemy eksperckie i często podejmują decyzje wyłącznie w oparciu o dane z czujników. Aby sztuczna inteligencja mogła szerzej zakorzenić się w codziennym życiu, musi stać się mniejsza, tańsza i bardziej niezawodna. Kolejnym kluczowym etapem rozwoju sztucznej inteligencji będzie prawdopodobnie przejście w kierunku sztucznej inteligencji wbudowanej, tj. inteligentnych systemów wbudowanych w maszyny, urządzenia i sprzęt AGD. Praca Choya (2003) jest pod tym względem istotna, ponieważ pokazuje, że system tablicy DARBS można przenieść na kompaktową platformę równoległych, tanich procesorów. Oprócz rozproszenia w aplikacjach, inteligentne systemy stają się również rozproszone w sposobie wdrażania. Złożone problemy można podzielić na podzadania, które można przypisać wyspecjalizowanym agentom współpracującym, łącząc najlepsze cechy podejść opartych na wiedzy i inteligencji obliczeniowej (Li, 2003). Ponieważ współpracujący agenci nie muszą koniecznie znajdować się na tym samym komputerze, inteligentny system może być zarówno rozproszony, jak i hybrydowy (Choy, 2004). Paradoksalnie, istnieje również poczucie, że inteligentne systemy stają się coraz bardziej zintegrowane, ponieważ agenci programowi współdzielą dostęp do pojedynczej, ostatecznej kopii danych lub wiedzy, dostępnej za pośrednictwem sieci.
WNIOSKI
Jak w przypadku każdej techniki, systemy oparte na wiedzy nie nadają się do rozwiązania wszystkich typów problemów. Każdy problem wymaga najodpowiedniejszego narzędzia, ale systemy oparte na wiedzy mogą być wykorzystywane do rozwiązywania wielu problemów, które byłyby niepraktyczne w innych obszarach. Odniosły one szczególne sukcesy w wąskich, specjalistycznych dziedzinach. Zbudowanie inteligentnego systemu, który mógłby podejmować rozsądne decyzje w nieznanych sytuacjach w codziennych, niespecjalistycznych dziedzinach, pozostaje poważnym wyzwaniem. Rozwój ten będzie wymagał postępu w symulowaniu zachowań, które ludzie uważają za oczywiste - w szczególności percepcji, rozpoznawania, języka, zdrowego rozsądku i zdolności adaptacyjnych. Zbudowanie inteligentnego systemu, który obejmuje cały zakres ludzkich możliwości, prawdopodobnie będzie wymagało podejścia hybrydowego, wykorzystującego połączenie technik sztucznej inteligencji.
Sieci neuronowe do szacowania ryzyka warunkowego
WSTĘP
Analiza przeżycia jest wykorzystywana, gdy chcemy zbadać wystąpienie jakiegoś zdarzenia w populacji badanych oraz czas do wystąpienia interesującego nas zdarzenia. Ten czas nazywany jest czasem przeżycia lub czasem awarii. Analiza przeżycia jest często wykorzystywana w eksperymentach testowania trwałości przemysłowej oraz w klinicznych badaniach obserwacyjnych. Przykłady zastosowań obejmują: czas do awarii żarówki, czas do wystąpienia anomalii w obwodzie elektronicznym, czas do nawrotu raka, czas do ciąży. W literaturze można znaleźć wiele różnych podejść modelowania do analizy przeżycia. Konwencjonalne modele parametryczne mogą zawierać zbyt rygorystyczne założenia dotyczące rozkładów czasu awarii oraz formy wpływu cech systemu na czas przeżycia, co zazwyczaj znacznie upraszcza dowody eksperymentalne, szczególnie w przypadku danych medycznych . Natomiast modele semiparametryczne nie opierają się na założeniach dotyczących rozkładu awarii, lecz na założeniach dotyczących wpływu cech systemu na czas przetrwania (założeniem jest zazwyczaj proporcjonalność zagrożeń); ponadto modele te zazwyczaj nie pozwalają na bezpośrednią estymację czasu przetrwania. Wreszcie, modele nieparametryczne zazwyczaj pozwalają jedynie na jakościowy opis danych na poziomie populacji. Sieci neuronowe są ostatnio wykorzystywane do analizy przetrwania; w celu przeprowadzenia przeglądu obecnego wykorzystania sieci neuronowych oraz niektórych wcześniejszych prób modelowania przetrwania za pomocą sieci neuronowych odsyłamy do publikacji. Sieci neuronowe zapewniają efektywne parametryczne oszacowania funkcji przeżycia i, w zasadzie, możliwość spersonalizowanych prognoz przeżycia. W kontekście medycznym takie informacje są cenne zarówno dla lekarzy, jak i pacjentów. Pomagają lekarzom w wyborze odpowiedniego leczenia i efektywnym planowaniu opieki następczej. Pacjenci z grupy wysokiego ryzyka mogą być monitorowani częściej niż pacjenci z grupy niższego ryzyka, aby skierować cenne zasoby do tych, którzy ich najbardziej potrzebują. Dla pacjentów uzyskanie informacji o ich rokowaniu jest również niezwykle cenne w kontekście planowania życia i opieki nad osobami pozostającymi na ich utrzymaniu. W niniejszym artykule opisujemy nowatorski model sieci neuronowej, którego celem jest rozwiązanie problemu analizy przeżycia w czasie ciągłym; przedstawiamy szczegóły dotyczące bayesowskiego podejścia do modelowania i przykładowe zastosowanie na rzeczywistych danych.
TŁO
Niech T oznacza absolutnie ciągłą dodatnią zmienną losową, z funkcją rozkładu P, reprezentującą czas wystąpienia zdarzenia. Funkcja przeżycia, S(t), jest zdefiniowana jako:
S(t) = Pr(T>t),
czyli prawdopodobieństwo przeżycia po czasie t. Ogólnie rzecz biorąc, zakładamy, że funkcja przeżycia zależy również od zbioru zmiennych współzależnych, reprezentowanych przez wektor x (który sam w sobie można uznać za zmienną losową). Ważną funkcją związaną z funkcją przeżycia jest stopa ryzyka , zdefiniowana jako:
hr(t) = P′(t)/S(t)
gdzie P′ jest gęstością związaną z P. Stopę ryzyka można interpretować jako chwilową siłę śmiertelności. W wielu zastosowaniach analizy przeżycia nie obserwujemy bezpośrednio realizacji zmiennej losowej T; dlatego musimy mieć do czynienia z problemem brakujących danych. Najczęstszą formą braku jest cenzurowanie w prawo, tj. obserwujemy realizacje zmiennej losowej:
Z = min(T, C),
gdzie C jest zmienną losową, której rozkład jest zazwyczaj nieznany. Użyjemy wskaźnika cenzurowania d, aby określić, czy zaobserwowaliśmy zdarzenie (d = 1), czy nie (d = 0). Można wykazać, że wnioskowanie nie zależy od rozkładu C (Cox i Oakes, 1984). Mając na uwadze powyższe definicje, możemy teraz sformułować funkcję logarytmu wiarygodności niezbędną do wnioskowania statystycznego. Pominiemy szczegóły i przedstawimy jedynie postać analityczną:

SIECI NEURONOWE DO SZACOWANIA ZAGROŻENIA WARUNKOWEGO
Model sieci neuronowej
Użyliśmy modelu sieci neuronowej do szacowania zagrożenia wielowarstwowego (MLP) (Bishop, 1995):

gdzie g() jest funkcją sigmoidalną, a w = {b0, v, u, u0, b} jest zbiorem parametrów sieci. Wynik MLP definiuje model analityczny dla logarytmu funkcji wskaźnika zagrożenia:

Ten model w czasie ciągłym nazywamy Siecią Neuronową do Szacowania Zagrożenia Warunkowego (CHENN).
Bayesowskie uczenie parametrów sieci
Bayesowskie ramy uczenia oferują szereg zalet w porównaniu z metodami największej wiarygodności powszechnie stosowanymi w uczeniu sieci neuronowych , z których najważniejsze to automatyczna regularyzacja i estymacja słupków błędów w prognozach. W konwencjonalnym podejściu do uczenia opartym na metodzie największej wiarygodności, znajdowany jest pojedynczy wektor wag, który minimalizuje funkcję błędu; natomiast schemat bayesowski uwzględnia rozkład prawdopodobieństwa względem wag w. Jest on opisany rozkładem a priori p(w), który ulega modyfikacji, gdy obserwujemy zbiór danych D. Proces ten można wyrazić za pomocą twierdzenia Bayesa:
p(w|D) = p(D|w)p(w)/p(D)
Aby ocenić rozkład a posteriori, potrzebujemy wyrażeń dla wiarygodności p(D|w) (które już pokazaliśmy) i dla rozkładu a priori p(w). Wcześniejsze wagi powinny odzwierciedlać wiedzę, o ile w ogóle, jaką posiadamy na temat mapowania, które chcemy zbudować. W naszym przypadku oczekujemy, że funkcja będzie bardzo gładka, więc odpowiedni wcześniejszy rozkład mógłby wyglądać następująco:

co jest wielowymiarową gęstością normalną z zerową średnią i macierzą kowariancji diagonalnej z elementami 1/αk. W ten sposób wagi wyśrodkowane na zerze mają większe prawdopodobieństwo, co sprzyja powstawaniu bardzo gładkich funkcji. Należy zauważyć, że a priori jest parametryczne, a parametry regularyzacji ak (które są odwrotnymi wariancjami) nazywane są hiperparametrami, ponieważ kontrolują rozkład parametrów sieci. Należy również zauważyć, że a priori jest specjalizowane dla różnych grup wag poprzez użycie różnych parametrów regularyzacji dla każdej grupy; ma to na celu zachowanie właściwości skalowania odwzorowań sieci . Ten a prior nazywa się automatycznym określaniem istotności (ARD). Schemat ten definiuje model, którego a priori względem parametrów ucieleśnia koncepcję istotności, dzięki czemu model jest w stanie skutecznie wywnioskować, które parametry są istotne na podstawie danych treningowych, a następnie wyłączyć pozostałe (lub przynajmniej zmniejszyć ich wpływ na ogólne odwzorowanie). Schemat modelowania ARD w przypadku modelu CHENN definiuje grupy wag dla danych wejściowych, wag warstwy wyjściowej i odchyleń. Po podaniu wyrażeń dla modelu a priori i szumu możemy obliczyć rozkład a posteriori:

Rozkład ten jest zazwyczaj bardzo złożony i multimodalny (odzwierciedlając naturę bazowej funkcji błędu, członu -L); a określenie współczynnika normalizacji (zwanego również dowodem) jest bardzo trudne. Co więcej, hiperparametry muszą zostać zintegrowane, ponieważ służą one jedynie do określenia postaci rozkładów. Rozwiązaniem jest zintegrowanie parametrów oddzielnie od hiperparametrów, poprzez zastosowanie przybliżenia Gaussa; a następnie poszukiwanie mody względem hiperparametrów. Ta procedura daje dobre oszacowanie masy prawdopodobieństwa przypisanej do rozkładu a posteriori, w szczególności w przypadku rozkładów w przestrzeniach wielowymiarowych, co ma miejsce w przypadku dużych sieci. Przybliżenie Gaussa w praktyce uzyskuje się poprzez znalezienie maksimum rozkładu a posteriori, a następnie ocenę krzywizny rozkładu wokół tego maksimum:

Przybliżenie jest zatem następujące:

gdzie stała normalizacji jest po prostu obliczana ze zwykłych wielowymiarowych wzorów normalnych. Hiperparametry są obliczane poprzez znalezienie maksimum przybliżonego dowodu ZMP. Alternatywna maksymalizacja (za pomocą nieliniowego algorytmu optymalizacji) a posteriori i dowodu jest powtarzana aż do znalezienia samospójnego rozwiązania {wMP, αk}. Pełne bayesowskie podejście do wnioskowania oznacza, że nie otrzymujemy po prostu punktowej prognozy dla funkcji f(x,t;w) wyjścia modelu, ale pełny rozkład. Takie rozkłady predykcyjne mają postać:

Powyższe całki generalnie nie są analitycznie wykonalne, nawet gdy rozkład a posteriori parametrów jest rozkładem Gaussa. Zazwyczaj jednak wystarcza znalezienie momentów rozkładu predykcyjnego, w szczególności jego średniej i wariancji. Użyteczne przybliżenie daje metoda delta. Niech f(w) będzie funkcją (w), którą chcemy aproksymować. Rozwijając równanie Taylora do pierwszego rzędu wokół wMP, możemy zapisać:

Ponieważ jest to funkcja liniowa w, nadal będzie miała rozkład normalny według rozkładu a posteriori Gaussa, ze średnią i wariancją:

Słupki błędów uzyskuje się po prostu poprzez wyciągnięcie pierwiastka kwadratowego z wariancji. Podkreślamy, że ocena informacji pierwszego i drugiego rzędu jest istotna dla zrozumienia ogólnej jakości i wiarygodności prognoz modelu. Słupki błędów dostarczają również wskazówek dotyczących rozkładu wzorców i dlatego mogą być przydatne do zrozumienia, czy model ekstrapoluje swoje prognozy. Ponadto mogą one stanowić sugestie dotyczące gromadzenia danych w przyszłości.
Studium przypadku: Czerniak gałki ocznej
Przedstawiamy zastosowanie modelu CHENN do prognozowania śmiertelności z jakiejkolwiek przyczyny w czerniaku gałki ocznej. Czerniak wewnątrzgałkowy występuje w tkance barwnikowej zwanej błoną naczyniową oka, a ponad 90% guzów obejmuje naczyniówkę, znajdującą się pod siatkówką. Około 50% pacjentów umiera z powodu przerzutów, które zazwyczaj obejmują wątrobę. Szacunki przeżycia po leczeniu czerniaka błony naczyniowej oka są najczęściej uzyskiwane i raportowane za pomocą analizy Coxa i krzywych przeżycia Kaplana-Meiera (KM) . Metoda Coxa, jako model półparametryczny, zazwyczaj wykorzystuje jednak liniowe zależności między zmiennymi, a proporcjonalność ryzyka jest zawsze zakładana. Warto zatem zbadać możliwości modeli nieliniowych, które nie przyjmują żadnych założeń dotyczących proporcjonalności ryzyka. Dane wykorzystane do przetestowania modelu zostały wybrane z bazy danych Centrum Onkologii Okulistycznej w Liverpoolu. Zbiór danych podzielono na dwie części: jedną treningową (1823 wzorce), drugą testową (781 wzorców). Wykorzystano dziewięć czynników prognostycznych: płeć, margines guza, największa średnica podstawna w badaniu ultrasonograficznym, rozszerzenie poza gałkę oczną, obecność komórek nabłonkowych, obecność pętli zamkniętych, tempo mitotyczne, monosomia chromosomu 3. Wydajność modeli analizy przeżycia można ogólnie ocenić na podstawie ich aspektów dyskryminacji i kalibracji. Dyskryminacja to zdolność modelu do prawidłowego podziału badanych na różne grupy. Kalibracja to stopień zgodności między oszacowanym prawdopodobieństwem wygenerowanym przez model a rzeczywistym prawdopodobieństwem obserwowanym . Jedną z najczęściej stosowanych metod oceny dyskryminacji w analizie przeżycia jest wskaźnik C Harrella , stanowiący rozszerzenie analizy przeżycia obszaru pod charakterystyką operatora odbiornika (AUROC). Kalibrację ocenia się za pomocą testu dopasowania Kołmogorowa-Smirnowa (KS) z poprawkami na cenzurowanie. Wskaźnik C oceniano dla zbioru lat interesujących dla aplikacji, od 1 do 7. Minimum osiągnięto po 7 latach (0,75), a maksimum po 1 roku (0,8). Test KS z poprawkami na cenzurowanie zastosowano dla powyższego zbioru lat, aż do maksymalnego czasu bez cenzurowania (16,8 roku); poziom ufności ustalono jak zwykle na 0,05. Hipoteza zerowa, że modelowane rozkłady są zgodne z oszacowaniem empirycznym, nie może zostać odrzucona dla lat 1-7, natomiast jest odrzucana, jeśli porównamy rozkłady do 16,8 roku; hipoteza zerowa jest zawsze odrzucana w przypadku modelu Coxa.
TRENDY NA PRZYSZŁOŚĆ
Sieci neuronowe są bardzo elastycznymi narzędziami modelowania i w kontekście analizy przeżycia mogą oferować zalety w porównaniu z (zwykle liniowymi) podejściami modelowania powszechnie spotykanymi w literaturze. Ta elastyczność ma jednak swoją cenę: czas obliczeniowy i trudność interpretacji modelu. Pierwszy aspekt wynika z zazwyczaj dużej liczby parametrów charakteryzujących umiarkowanie złożone sieci oraz z faktu, że proces uczenia prowadzi do nieliniowego problemu optymalizacji. Drugi aspekt jest w pewnym sensie wynikiem nieliniowości i niewypukłości modelu. Zajęcie się kwestią niewypukłości może być pierwszym krokiem do uzyskania modeli, które można łatwo interpretować pod względem parametrów i łatwiej trenować; i pod tym względem maszyny jądra (takie jak maszyny wektorów nośnych) można uznać za kolejny krok w elastycznym modelowaniu nieliniowym, chociaż formułowanie algorytmów uczenia się dla tych modeli opiera się na paradygmacie, który nie opiera się na funkcjach prawdopodobieństwa, a zatem ich zastosowanie do danych dotyczących przeżycia nie jest natychmiastowe.
WNIOSKI
W niniejszym artykule zaproponowano nowy model sieci neuronowej do analizy przeżycia w czasie ciągłym, który aproksymuje logarytm funkcji współczynnika ryzyka. Sformułowanie modelu umożliwia łatwe wyprowadzenie słupków błędów zarówno dla przewidywań współczynnika ryzyka, jak i przeżycia. Model jest trenowany w ramach podejścia bayesowskiego w celu zwiększenia jego odporności i zmniejszenia ryzyka nadmiernego dopasowania. Model został przetestowany na rzeczywistych danych w celu przewidywania przeżycia w przypadku czerniaka wewnątrzgałkowego. Przeprowadzono formalne testy dyskryminacji i kalibracji, a model wykazuje dobrą wydajność w horyzoncie czasowym 7 lat, co uznano za przydatne w omawianym zastosowaniu. Projekt został sfinansowany przez Biopattern Network of Excellence FP6/2002/IST/1; wniosek nr IST-2002-508803; pełny tytuł projektu: Inteligencja obliczeniowa w analizie biowzorców jako wsparcie eHealthcare; URL: www.biopattern.org
Sieci neuronowe o wartościach zespolonych
WSTĘP
Zwykłe sztuczne sieci neuronowe o wartościach rzeczywistych znalazły zastosowanie w różnych dziedzinach, takich jak telekomunikacja, robotyka, bioinformatyka, przetwarzanie obrazu i rozpoznawanie mowy, w których liczby zespolone (dwuwymiarowe) są często wykorzystywane wraz z transformacją Fouriera. Wskazuje to na użyteczność sieci neuronowych o wartościach zespolonych, których sygnały wejściowe i wyjściowe oraz parametry, takie jak wagi i progi, są liczbami zespolonymi, stanowiącymi rozszerzenie zwykłych sieci neuronowych o wartościach rzeczywistych. Ponadto w ludzkim mózgu potencjał czynnościowy może mieć różne wzorce impulsów, a odległość między impulsami może być różna. Sugeruje to, że zasadne jest wprowadzenie do sieci neuronowych liczb zespolonych reprezentujących fazę i amplitudę. Aizenberg, Ivaskiv, Pospelov i Hudiakov (1971) (były Związek Radziecki) po raz pierwszy zaproponowali model neuronu o wartościach zespolonych i chociaż był on dostępny jedynie w literaturze rosyjskiej, ich prace można obecnie przeczytać w języku angielskim . Wcześniej większość badaczy spoza Rosji zakładała, że pierwszymi osobami, które zaproponowały neuron o wartościach zespolonych, byli Widrow, McCool i Ball (1975). Zainteresowanie sieciami neuronowymi zaczęło rosnąć około 1990 roku, a następnie zaproponowano różne typy modeli sieci neuronowych o wartościach zespolonych. Od tego czasu zbadano ich właściwości, co umożliwiło rozwiązanie niektórych problemów, których nie dało się rozwiązać za pomocą neuronu o wartościach rzeczywistych, a także rozwiązanie wielu skomplikowanych problemów w sposób prostszy i bardziej efektywny.
TŁO
Ogólna definicja neuronu o wartościach zespolonych jest następująca. Sygnały wejściowe, wagi, progi i sygnały wyjściowe są liczbami zespolonymi. Całkowita wartość wejściowa Un do neuronu o wartościach zespolonych n jest zdefiniowana jako:

gdzie Wnm to waga o wartościach zespolonych łącząca neurony o wartościach zespolonych n i m, Xm to sygnał wejściowy o wartościach zespolonych z neuronu o wartościach zespolonych m, a Vn to próg neuronu o wartościach zespolonych n. Wartość wyjściowa neuronu n jest dana przez fC (Un), gdzie fC : C ? C nazywa się funkcją aktywacji (C oznacza zbiór liczb zespolonych). Zaproponowano różne typy funkcji aktywacji stosowanych w neuronie o wartościach zespolonych, które wpływają na właściwości neuronu o wartościach zespolonych, a sieć neuronowa o wartościach zespolonych składa się z takich neuronów o wartościach zespolonych. Na przykład często stosuje się funkcję aktywacji typu składowa-rzeczywista lub funkcję aktywacji typu rzeczywista-urojona, która jest zdefiniowana następująco:
fC(z) = fR(x) + i fR(y)
Un = x + iy = z
Oznacza to, że części rzeczywista i urojona wyjścia neuronu oznaczają odpowiednio funkcje sigmoidalne części rzeczywistej x i części urojonej y sumy wejściowej z do neuronu. Należy zauważyć, że funkcja aktywacji dla poszczególnych składowych jest ograniczona, ale nieregularna jako funkcja o wartościach zespolonych, ponieważ równania Cauchy′ego-Riemanna nie są spełnione. W tym przypadku, jak zauważyło kilku badaczy , w obszarze zespolonym, należy przypomnieć twierdzenie Liouville′a, które mówi, że jeśli funkcja g jest regularna dla wszystkich z ∈ C i ograniczona, to g jest funkcją stałą. Oznacza to, że musimy wybrać albo regularność, albo ograniczoność dla funkcji aktywacji neuronów o wartościach zespolonych. Ponadto udowodniono, że sieć neuronowa o wartościach zespolonych z funkcją aktywacji dla poszczególnych składowych może aproksymować dowolną ciągłą funkcję o wartościach zespolonych, podczas gdy sieć o regularnej funkcji aktywacji (na przykład fC(z) = 1/(1+exp(-z)) i fC(z) = tanh (z) nie może aproksymować żadnej nieregularnej funkcji o wartościach zespolonych . Oznacza to, że sieć neuronowa o wartościach zespolonych z nieregularną funkcją aktywacji jest uniwersalnym aproksymatorem, ale sieć o regularnej funkcji aktywacji nim nie jest. Należy tutaj zauważyć, że sieć neuronowa o wartościach zespolonych z regularną funkcją aktywacji o wartościach zespolonych, taką jak fC(z) = tanh(z) z biegunami, może być uniwersalnym aproksymatorem zwartych podzbiorów usuniętego otoczenia biegunów. Fakt ten jest bardzo ważny teoretycznie, jednak niestety sieć neuronowa o wartościach zespolonych do analizy nie jest typowa, to znaczy wyjście neuronu ukrytego jest definiowane jako iloczyn kilku funkcji aktywacji. Zatem stwierdzenie to wydaje się niewystarczające do porównania z przypadkiem funkcji aktywacji o wartościach zespolonych dla poszczególnych składowych. Zatem zdolność sieci neuronowych o wartościach zespolonych do aproksymacji funkcji o wartościach zespolonych zależy w dużym stopniu od regularności użytych funkcji aktywacji. Z drugiej strony, zaproponowano kilka funkcji aktywacji o wartościach zespolonych opartych na współrzędnych biegunowych. Na przykład Hirose (1992) zaproponował następującą funkcję aktywacji typu amplituda-faza:

gdzie m jest stałą. Chociaż ta funkcja aktywacji amplitudy i fazy nie jest regularna, Hirose zauważył, że nieregularność ta nie powoduje poważnych problemów w rzeczywistych zastosowaniach i że model amplitudy i fazy nadaje się do zastosowań w wielu dziedzinach inżynierii, takich jak optyczne systemy przetwarzania informacji oraz modulacja amplitudy, modulacja fazy i modulacja częstotliwości w komunikacji fal elektromagnetycznych i radarach. Aizenberg i inni (2000) zaproponowali następującą funkcję aktywacji:

gdzie k jest stałą. Równanie można traktować jako typ funkcji aktywacji amplitudy i fazy. Wykorzystywana jest tylko informacja o fazie, a informacja o amplitudzie jest pomijana, jednak wiele udanych zastosowań pokazuje, że funkcja aktywacji jest wystarczająca.
WŁAŚCIWOŚCI WIELOWARSTWOWE SIECI NEURONOWEJ TYPU O WARTOŚCIACH ZŁOŻONYCH
W niniejszym artykule przedstawiono zasadnicze różnice między wielowarstwowymi sieciami neuronowymi o wartościach rzeczywistych a wielowarstwowymi sieciami neuronowymi o wartościach zespolonych, które są bardzo istotne, ponieważ rozszerzają rzeczywiste obszary zastosowań wielowarstwowych sieci neuronowych o wartościach zespolonych. Według wiedzy autora, dotychczas nie ujawniono właściwości wewnętrznych sieci neuronowych o wartościach zespolonych z regularnymi funkcjami aktywacji o wartościach zespolonych, poza ich wydajnością uczenia się. Zatem opisano głównie jedynie właściwości wewnętrzne sieci neuronowej o wartościach zespolonych z nieregularną
funkcją aktywacji o wartościach zespolonych : (a) wydajność uczenia się, (b) zdolność do przekształcania figur geometrycznych oraz (c) ortogonalną granicę decyzyjną.
Wydajność uczenia
W zastosowaniach wielowarstwowych sieci neuronowych o wartościach rzeczywistych często stosowano algorytm uczenia się z wsteczną propagacją błędu (nazywany tutaj Real-BP) . Oczywiście można rozważyć wersję Real-BP o wartościach zespolonych (nazywaną tutaj Complex-BP), którą zaproponowało kilku badaczy . Algorytm ten umożliwia sieci naturalne uczenie się wzorców o wartościach zespolonych. Wiadomo, że szybkość uczenia się algorytmu Complex-BP jest szybsza niż algorytmu Real-BP. Nitta (1991, 1997) wykazał w niektórych eksperymentach dotyczących uczenia się wzorców o wartościach zespolonych, że szybkość uczenia się jest kilkakrotnie szybsza niż w przypadku techniki konwencjonalnej, podczas gdy złożoność przestrzenna (tj. liczba potrzebnych parametrów do uczenia) jest zaledwie o połowę mniejsza niż w przypadku Real-BP. Ponadto De Azevedo, Travessa i Argoud (2005) zastosowali algorytm Complex-BP opisany w literaturze do rozpoznawania i klasyfikacji wzorców padaczkowych w EEG, w szczególności dotyczących wzorców iglic i mrugnięć, i ponownie potwierdzili wyższość szybkości uczenia się algorytmu Complex-BP opisanego powyżej. Jeśli chodzi o regularną funkcję aktywacji o wartościach zespolonych, Kim i Adali porównali szybkość uczenia się układu Complex-BP przy użyciu dziewięciu regularnych funkcji aktywacji o wartościach zespolonych z szybkością uczenia się układu Complex-BP przy użyciu trzech nieregularnych funkcji aktywacji o wartościach zespolonych , przeprowadzając symulację komputerową dla prostego przykładu identyfikacji układu nieliniowego. Wyniki eksperymentalne sugerowały, że układ Complex-BP z regularną funkcją aktywacji fC(z) = arcsin h(z) był najszybszy spośród nich.
Możliwość transformacji figur geometrycznych
Sieć Complex-BP z nieregularną funkcją aktywacji o wartościach zespolonych może transformować figury geometryczne, np. obrót, transformację podobieństwa i przesunięcie równoległe linii prostych, okręgów itp., podczas gdy sieć Real-BP nie potrafi tego zrobić. Eksperymenty numeryczne sugerują, że zachowanie sieci Complex-BP, która nauczyła się transformacji figur geometrycznych, było związane z twierdzeniem o identyczności w analizie zespolonej. Poniżej podano jedynie przykład ilustrujący obrót. W symulacji komputerowej wykorzystano trójwarstwową sieć neuronową o wartościach zespolonych 1-6-1, która przekształciła punkt (x, y) w (x′, y′) na płaszczyźnie zespolonej. Chociaż sieć Complex-BP generujewartość z w zakresie 0 < Re[z], Im[z] < 1 ze względu na użytą funkcję aktywacji , dla wygody przedstawiono ją na poniższym rysunku jako wartość przekształconą w zakresie - 1 < Re[z], Im[z] < 1. Współczynnik uczenia się zastosowany w eksperymencie wynosił 0,5. Początkowe składowe rzeczywiste i urojone wag i progów wybrano jako losowe liczby rzeczywiste z zakresu od 0 do 1. Eksperyment składał się z dwóch części: kroku szkoleniowego, po którym następował krok testowy. Krok szkoleniowy polegał na uczeniu się zestawu (o wartościach zespolonych) wag i progów, tak aby wejściowy zestaw punktów (liniowych) dawał jako wynik, a punkty (liniowe) były obracane przeciwnie do ruchu wskazówek zegara o p/2 radianów. Pary wejściowe i wyjściowe prezentowano 1000 razy w kroku szkoleniowym. Te wagi i progi o wartościach zespolonych zostały następnie wykorzystane w kroku testowym, w którym punkty wejściowe leżące na linii prostej (oznaczone czarnymi trójkątami na rys. 1) miały zostać odwzorowane na zbiór punktów wyjściowych leżących na linii prostej (oznaczonej białymi trójkątami) obróconej przeciwnie do ruchu wskazówek zegara o p/2 radianów. Rzeczywiste punkty testowe wyjściowe dla sieci Complex-BP rzeczywiście leżały na linii prostej (oznaczonej białymi kwadratami). Wygląda na to, że sieć o wartościach zespolonych nauczyła się uogólniać transformację każdego punktu Zk(= rk exp[iθk]) na Zk exp[iα](= rkexp[i(θk + α)]), tj. kąt każdego punktu o wartościach zespolonych jest aktualizowany przez czynnik o wartościach zespolonych exp[iα], jednak bezwzględna długość każdego punktu wejściowego jest zachowana. W powyższym eksperymencie 11 punktów wejściowych treningu leżało na linii y = - x + 1 (0 ≤ x ≤ 1), a 11 punktów wyjściowych treningu leżało na linii y = x + 1 (- 1 ≤ x ≤ 0). Siedem testowych punktów wejściowych leżało na linii y = 0,2 (- 0,9 ≤ x ≤ 0,3). Pożądane wyjściowe punkty testowe powinny leżeć na linii x = - 0,2. Watanabe, Yazawa, Miyauchi i Miyauchi (1994) zastosowali model Complex-BP w dziedzinie widzenia komputerowego. Z powodzeniem wykorzystali możliwość transformacji figur geometrycznych sieci Complex-BP w celu uzupełnienia dwuwymiarowego pola wektorów prędkości na obrazie, który został uzyskany z zestawu obrazów i nazywany przepływem optycznym. Możliwość transformacji figury geometrycznej modelu Complex-BP może być również wykorzystana do generowania obrazów fraktalnych. W rzeczywistości Miura i Aiyoshi (2003) zastosowali model Complex-BP do generowania obrazów fraktalnych i wykazali w symulacjach komputerowych, że niektóre obrazy fraktalne, takie jak kryształy śniegu, można uzyskać z dużą dokładnością, gdzie iterowane systemy funkcji (IFS) skonstruowano z wykorzystaniem możliwości transformacji figur geometrycznych modelu Complex-BP.
Ortogonalna granica decyzyjna
Granica decyzyjna neuronu o wartościach zespolonych z nieregularną funkcją aktywacji o wartościach zespolonych ma inną strukturę niż neuronu o wartościach rzeczywistych. Rozważmy neuron o wartościach zespolonych z M neuronami wejściowymi. Niech wagi oznaczają
w = t[w1 … wM] = wr+ i wi, w r = t[w1r … wMr], w i = t[w1i … wMi], a próg niech oznacza θ = &h=theta;r+ iθi. Następnie dla M sygnałów wejściowych (liczb zespolonych) z = t[z1… zM] = x + iy, x = t[x1 … xM], y = t[y1 … yM] neuron o wartościach zespolonych generuje

jako wyjście. Tutaj dla dowolnych dwóch stałych CR, CI ∈ (0, 1), niech

Należy zauważyć, że równanie jest granicą decyzyjną dla części rzeczywistej wyjścia neuronu o wartościach zespolonych z M wejściami. Oznacza to, że sygnały wejściowe (x, y) ∈ R2M są klasyfikowane do dwóch obszarów decyzyjnych {(x, y) ∈ R2M | X(x, y) ≥ CR} i {(x, y) ∈ R2M | X(x, y) < CR} przez hiperpowierzchnię określoną równaniem. Podobnie równanie jest granicą decyzyjną dla części urojonej. Zauważając, że iloczyn skalarny wektorów normalnych granic decyzyjnych jest równy zero, stwierdzamy, że granica decyzyjna dla części rzeczywistej wyjścia neuronu o wartościach zespolonych i dla części urojonej przecinają się ortogonalnie. Jak wiadomo, problemu XOR i problemu detekcji symetrii nie da się rozwiązać za pomocą pojedynczego neuronu o wartościach rzeczywistych . Wbrew oczekiwaniom udowodniono, że takie problemy można rozwiązać za pomocą pojedynczego neuronu o wartościach zespolonych z ortogonalną granicą decyzyjną, co ujawniło potężną moc obliczeniową sieci neuronowych o wartościach zespolonych.
TRENDY NA PRZYSZŁOŚĆ
Wiele wyników zastosowań , takich jak pamięć asocjacyjna, filtry adaptacyjne, komunikacja wieloużytkownikowa i przetwarzanie obrazów radarowych, wskazuje kierunki przyszłych badań nad sieciami neuronowymi o wartościach zespolonych. Jest rzeczą naturalną, że właściwości wielowarstwowej sieci neuronowej o wartościach zespolonych z nieregularną funkcją aktywacji o wartościach zespolonych nie ograniczają się do opisanych powyżej. Co więcej, według wiedzy autora, nie opisano dotychczas wrodzonych właściwości sieci neuronowych o wartościach zespolonych, z wyjątkiem wydajności uczenia się. To samo dotyczy sieci neuronowych o wartościach zespolonych z regularnymi funkcjami aktywacji o wartościach zespolonych. Takie badania poszerzą pola zastosowań sieci neuronowych o wartościach zespolonych. W międzyczasie podjęto już wysiłki w celu zwiększenia wymiarowości sieci neuronowych, na przykład trzech wymiarów , kwaternionów , algebr Clifforda oraz N wymiarów , co stanowi nowy kierunek rozwoju sieci neuronowych.
WNIOSKI
W niniejszym artykule opisano inherentne właściwości sieci neuronowych o wartościach zespolonych, zwłaszcza w przypadku nieregularnych funkcji aktywacji o wartościach zespolonych, tj. (a) wydajność uczenia się, (b) zdolność do przekształcania figur geometrycznych oraz (c) ortogonalną granicę decyzyjną. Opisano również udane zastosowania takich sieci.
Studium porównawcze dotyczące elektronicznego robienia notatek
WSTĘP
W każdym środowisku ludzie uczestniczą w kumulatywnym i przyrostowym procesie zdobywania wiedzy. Obejmuje to dostęp, przetwarzanie i rozumienie informacji, które można uzyskać na wiele różnych sposobów. Należą do nich: świadome metody, takie jak sięganie po książkę, lub bierne słuchanie. Treść wiedzy jest tłumaczona przez jednostki i często zapisywana za pomocą umiejętności robienia notatek, która różni się w zależności od osoby. Niniejszy artykuł przedstawia analizę technik robienia notatek, w tym najpopularniejszej metody Cornella. Przeprowadzono analizę porównawczą z metodami konspektu i mapowania, wskazując mocne i słabe strony każdej z nich pod względem prostoty, użyteczności i skuteczności. Procesy rozwijania takich umiejętności nie są łatwe ani proste, a na wydajność w dużym stopniu wpływa proces poznawczy. Dlatego też, takie powiązania dotyczące koncepcji poznawczych obejmują eksplorację procesów robienia notatek, kodowania i przechowywania, uwagi i koncentracji, pamięci oraz innych czynników stymulujących, takich jak multimedia. Zmiany społeczne w edukacji, od tradycyjnego sposobu studiowania do elektronicznego, są adaptowane przez instytuty. Zmiana ta obejmuje zarówno komputeryzację podelementu procesu uczenia się, jak i symulację całego środowiska wykładowego. Umożliwiło to studentom wygodniejsze eksplorowanie środowiska akademickiego, jednak nadal budzi kontrowersje co do jego wykonalności. W artykule omówiono podstawowe zasady pedagogiczne, formułując wskazówki dotyczące rozwoju środowiska e-learningowego. Ponadto, zbadano wdrażanie tabletów PC zastępujących tablicę w połączeniu z aplikacjami do adnotacji. Analiza semantyczna zmiany paradygmatu w e-learningu i zarządzaniu wiedzą, zastępującej interakcję w klasie, ukazuje jej potencjał w dziedzinie uczenia się. Artykuł kończy się propozycjami dotyczącymi projektowania i rozwoju elektronicznej platformy do robienia notatek.
WSTĘP
Przez lata prowadzono intensywne badania nad robieniem notatek. Celem artykułu jest analiza porównawcza różnych technik robienia notatek, wyjaśniając ich skuteczność i prostotę. Zbadano związek między poznaniem a robieniem notatek, przedstawiając analizę procesów, które się w tym procesie znajdują. Ze względu na ogromną ilość badań nad poznaniem, jego znaczenie jest niezwykle istotne. Chociaż w obu dziedzinach przeprowadzono wiele badań w celu zaprojektowania elektronicznego narzędzia do robienia notatek, przeprowadzono również analizę istniejących aplikacji, z których najbardziej obiecującym okazał się Microsoft OneNote. Jest to aplikacja do adnotacji, która nie posiada predefiniowanej techniki zapisywania notatek ani adnotacji i zapisuje pismo odręczne jako obraz. W literaturze zaprezentowano prace wielu autorów, którzy przyczynili się do powstania tego badania.
STUDIUM PORÓWNAWCZE
Niniejszy artykuł przedstawia wgląd w robienie notatek, różne metody, psychologię poznawczą oraz zmianę paradygmatu z tradycyjnego sposobu nauki na elektroniczny.
Techniki robienia notatek
Teoretycznie robienie notatek jest postrzegane jako przekazywanie informacji z jednego umysłu do drugiego. Obecnie najpopularniejszą techniką robienia notatek jest metoda Cornell, zwana również "Zrób to dobrze od samego początku". Ta metoda robienia notatek została opracowana ponad 40 lat temu przez profesora Waltera Pauka z Uniwersytetu Cornell . Głównym celem opracowania tej metody było pomoc studentom w uporządkowaniu notatek. Technika ta polega na systematycznym podejściu do porządkowania i kondensowania notatek bez konieczności wielokrotnego przepisywania. Metoda jest prosta i skuteczna, ponieważ określa tylko trzy obszary: Obszar A - słowa kluczowe, Obszar B - notatki i Obszar C - podsumowanie. Obszar A jest przypisany do słów kluczowych lub fraz, które studenci tworzą pod koniec wykładu. Z biegiem lat alternatywą stały się pytania ułatwiające zapamiętywanie zamiast rozpoznawania. Wiadomo, że te wskazówki wspomagają pamięć i służą jako przypomnienie, a także pomagają w identyfikacji relacji, nazywanych również systemem Q . Obszar B pozostaje do zapisywania notatek podczas wykładu. Tutaj student stara się uchwycić jak najwięcej informacji. Wreszcie, obszar C jest pozostawiony studentowi na podsumowanie notatek i refleksję nad głównymi ideami wykładu . Główną zaletą tej techniki jest jej przejrzysta i uporządkowana struktura. Technika ta nadaje się również do modułów technicznych, w tym matematyki i fizyki, oraz modułów nietechnicznych, takich jak język angielski i historia. Podczas warsztatów inżynieryjnych i nauk stosowanych, eksperymenty z udziałem 70 studentów wykazały, że ta metoda robienia notatek jest prosta . Autorzy Anderson-Rowland i inni (1996) twierdzą, że metoda ta umożliwia organizację notatek, pociąga za sobą interakcję i koncentrację, a zatem; Można przeprowadzić zaplanowany przegląd, natychmiast podkreślając słowa kluczowe. Ponadto, ponieważ studenci mogą podsumować treść, ułatwia to naukę poprzez zwiększenie zrozumienia. Dodatkowo, mocą tej techniki jest możliwość natychmiastowego robienia notatek, co oszczędza czas i wysiłek dzięki jej systematycznej strukturze. Dla porównania, metoda konspektu ma bardziej przestrzenny i znaczący układ, implicite kodując relacje pojęciowe. Na przykład wcięcia mogą implikować grupowanie i bliskość . Metoda ta składa się z myślników lub wcięć i nie nadaje się do modułów technicznych, takich jak matematyka czy fizyka. Ta technika wymaga wcięć ze spacjami po prawej stronie dla konkretnych faktów. Relacje są reprezentowane za pomocą wcięć. Osoby sporządzające notatki muszą określić punkty w uporządkowany sposób, układając wzór i sekwencję zbudowaną za pomocą wcięć spacjami. Ważne punkty są oddzielone i umieszczone najdalej po lewej stronie, przesuwając bardziej szczegółowe punkty po prawej stronie. Odległość od głównego punktu wskazuje na poziom ważności. Główną zaletą tej techniki jest przejrzysta struktura, umożliwiająca bezproblemowe przeglądanie materiału. Metoda konspektu wymaga jednak od studenta pełnego skupienia, aby osiągnąć maksymalną organizację notatek. W związku z tym technika ta nie jest odpowiednia, jeśli wykładowca pracuje w szybkim tempie. Metoda ta została również odrzucona przez Foxa (1959) ze względu na jej niejasną strukturę organizacyjną. Wynika to głównie z rozmieszczenia cyfr, wielkich liter itp. W przeciwieństwie do metod Cornella i konspektu, metoda mapowania stanowi graficzne przedstawienie treści wykładu. Studenci są zachęcani do wizualnego określania powiązań ilustrujących relacje między faktami a koncepcjami. Mapy pojęciowe umożliwiają burzę mózgów, analizę i przedstawienie złożonych scenariuszy, identyfikowanie i proponowanie rozwiązań błędów oraz podsumowywanie informacji. Aby zwiększyć dokładność, studenci muszą aktywnie uczestniczyć i inicjować krytyczne myślenie. Jednakże, wadą jest prawdopodobnie strukturalna organizacja i relacje między węzłami, zwłaszcza te podważające strukturę hierarchiczną . Omówiono alternatywne struktury, w tym mapy łańcuchowe, mapy pająków i sieci .
E-learning
E-learning, znany również jako edukacja na odległość, wykorzystuje liczne rozwiązania technologiczne. Obecnie instytucje edukacyjne słyną z prowadzenia zajęć akademickich przez Internet. Rozwój Internetu stale przyspiesza, oferując ogromny potencjał nie tylko jako materiału dydaktycznego, ale także jako środowiska uczenia się opartego na współpracy. Główną różnicą między tradycyjnym a elektronicznym uczeniem się jest sposób przekazywania informacji. Aby system e-learningowy działał skutecznie, należy uwzględnić wszystkie podkomponenty i powiązane ze sobą procesy, ponieważ awaria jednego procesu oznacza awarię całego systemu. Dlatego konieczne jest opracowanie szeregu zasad pedagogicznych. Podstawowe zasady pedagogiczne obejmują uwzględnienie zachowania użytkownika wobec systemu, ponieważ jest to odizolowana aktywność, która prowadzi do frustracji użytkownika. Ponieważ Internet posiada ogromną ilość wiedzy, może być prezentowany w sposób stronniczy, dostarczając użytkownikom jedynie niepełnych informacji. Należy uwzględnić kwestie środowiska i działań użytkownika, które należy podjąć, aby osiągnąć określony cel. Co więcej, umiejętności interpersonalne użytkownika, w tym jego postawy, percepcje i zachowania, mają kluczowe znaczenie dla skuteczności systemu. Dowiedziono, że e-learning skraca czas nauczania, zwiększa biegłość i poprawia zapamiętywanie. Jednak nie zawsze jest to prawdą, ponieważ w jednym z badań wyniki internetowych notatek z wykładów wykazały, że studenci osiągali słabsze wyniki . Z perspektywy studentów, stale poszukują oni komunikacji i wsparcia, aby wpływać na swoją naukę. Oczekują również konstruktywnej informacji zwrotnej. Głównymi wyzwaniami stojącymi przed społeczeństwem e-learningowym są zderzenie kultur i brak motywacji do korzystania z elektronicznego środowiska edukacyjnego. Ludzie po prostu nie są gotowi zaakceptować tej zmiany. Głównym czynnikiem decydującym o pomyślnych rezultatach takich systemów jest poziom zapewnianej interaktywności. Inne istotne zasady pedagogiczne obejmują poziom kontroli, jaką odczuwają użytkownicy, w porównaniu z tradycyjnym sposobem uczenia się, w którym wykładowca ma pełną kontrolę nad środowiskiem wykładowym. Ponadto, opracowanie odpowiedniego interfejsu jest konieczne, biorąc pod uwagę czynniki użyteczności, takie jak wydajność, wskaźniki błędów, łatwość zapamiętywania, łatwość uczenia się i zadowolenie z przedmiotu. Jako tutor, planowanie struktury kursu jest ważne, zwracając szczególną uwagę na strukturę treści. Tutorzy muszą zapewnić studentom informację zwrotną w odpowiednim czasie, zachowując przy tym odpowiednie zarządzanie czasem. Ogólnie rzecz biorąc, przed rozważeniem projektu i rozwoju środowiska e-learningowego, należy wziąć pod uwagę główne czynniki, takie jak uczestnicy, treści, technologia, techniki nauczania itd. Technologie związane z e-learningiem zwiększyły wykorzystanie przepustowości i dostępu do internetu. Obecnie istnieją dwie kluczowe technologie wykorzystywane do realizacji e-learningu: "platformy z planowanym nauczaniem" i "platformy z planowanym nauczaniem na żądanie". Platformy z planowanym nauczaniem obejmują multicasty, biblioteki wirtualne i zdalne laboratoria, jednak ich ograniczenia obejmują ograniczenia czasowe i przestrzenne. Aby jeszcze bardziej ulepszyć te systemy, platformy z planowanym nauczaniem na żądanie zapewniają całodobowe wsparcie, zachowując elastyczność nauczania . Skuteczność notatek elektronicznych w jednym konkretnym badaniu wykazała poprawę zrozumienia treści wykładów przez studentów, co doprowadziło do tego, że aż 96% użytkowników uważa e-notatki za skuteczne narzędzie . Użytkownicy mogą dodawać adnotacje, współpracować i omawiać treści tematyczne. Zwiększa to efektywność uczenia się, umożliwiając użytkownikowi zaangażowanie się w tekst, poprawiając jego zrozumienie i wspierając zapamiętywanie. Zwiększa to również zdolność do zapamiętywania konkretnych szczegółów . Wprowadzono liczne aplikacje do adnotacji, w tym Microsoft Word i OneNote, przeznaczone głównie do adnotacji. SharePoint™ umożliwia jednoczesną edycję i adnotacje, podobnie jak Re:Mark. Microsoft OneNote jako narzędzie do adnotacji jest bardziej popularny, jednak użytkownik końcowy musi posiadać jego kopię, aby z niego korzystać, w przeciwieństwie do Microsoft Journal, który można wyeksportować jako plik .mhtml . Ponadto, pismo odręczne jest tłumaczone jako obraz, a nie tekst, który można eksplorować . Do korzyści należy możliwość nagrywania wykładu i dodawania adnotacji, odwołując się do konkretnych punktów w nagraniu. Nagrania te można wykorzystać później. Tablety PC zastępują tablicę, wyświetlając materiał dydaktyczny za pomocą projektora danych. Wiele instytucji akademickich wykorzystuje je jako narzędzie dydaktyczne (Clark, 2004) lub udostępnia studentom jako urządzenia dydaktyczne . Główną zaletą tabletów PC jest ich interaktywność w nauczaniu twarzą w twarz. Jednakże badanie, w którym studenci otrzymali komputery z rysikiem do robienia notatek, przedstawiło projekt jako nieudany, ponieważ urządzenia były nieodpowiednie pod względem wydajności, niskiej rozdzielczości i czynników sieciowych.
Poznanie
Najczęstszą formą nauczania w szkolnictwie wyższym są wykłady, podczas których studenci robią notatki na podstawie treści wykładu . Podczas zajęć studenci spędzają około 80% czasu na słuchaniu wykładu , a powodem robienia notatek jest ich przydatność w nauce oraz presja społeczna . Studenci dostosowują technikę robienia notatek do osobistych doświadczeń, posiadanej wiedzy i adekwatności do formatu wykładu. Problemy w trakcie zajęć wynikają z niemożności skopiowania przez studentów informacji prezentowanych przez wykładowcę . Podczas metapoznania w czytaniu lub słuchaniu, ludzki umysł ma tendencję do błądzenia myślami w kierunku innych niż to, czego się uczy. W procesie uczenia się, wpływ na proces uczenia się występuje w procesach kodowania i przechowywania. Etap kodowania to etap, w którym studenci uczestniczą w wykładach i zapisują notatki, natomiast faza przechowywania to etap przeglądania notatek. Aby osiągnąć optymalną wydajność, należy połączyć proces kodowania i przechowywania. Przeglądanie notatek z wykładów jest szczególnie ważne, zwłaszcza gdy odbywa się w bliskim okresie przed egzaminem. Ponadto studenci powinni monitorować swoje postępy i zrozumienie informacji przed egzaminem. Można to osiągnąć poprzez samotestowanie. Tę metodę można również promować, dostarczając odpowiednie materiały, na przykład arkusze egzaminacyjne z poprzednich egzaminów. Studenci o lepszej pamięci odnoszą korzyści z robienia notatek, a badania wykazują, że studenci o niższej pamięci zapisują mniejszą liczbę słów i zapamiętują mniej kompletnych myśli . Wynika to ze zmienności w pamięci roboczej, w której informacje są przechowywane i przetwarzane. Dlatego zdolność osób sporządzających notatki do wyłapywania istotnych szczegółów, utrwalania wiedzy i łączenia nowej wiedzy z istniejącą jest kluczowym czynnikiem. Pamięć ludzką można podzielić na trzy typy: pamięć krótkotrwałą, długotrwałą i sensoryczną. Pamięć krótkotrwała pozwala na przechowywanie informacji przez krótki okres, zanim zostaną zapomniane lub przeniesione do pamięci długotrwałej. Pamięć długotrwała przechowuje informacje przez dłuższy czas w obwodzie pamięci. Obwód mózgowy obejmuje korę mózgową i hipokamp. Wreszcie, pamięć sensoryczna to początkowy magazyn informacji trwający chwilę, składający się z pamięci wzrokowej i słuchowej. Informacje są tutaj zazwyczaj gromadzone za pomocą zmysłów wzroku i słuchu. Włączenie multimediów do edukacji może wzbogacić doświadczenie uczenia się na wiele sposobów. Można zapewnić istotne pomoce sensoryczne, zwiększyć interaktywność i zainicjować bogatsze doświadczenie uczenia się. Prezentacja materiałów edukacyjnych i sposób, w jaki są one rejestrowane, są istotne. Dzieje się tak, ponieważ jeśli podczas wykładu wskazówki organizacyjne są wyraźnie zdefiniowane, proces organizacyjny jest sterowany. Co więcej, wykorzystanie dźwięków innych niż mowa w interfejsach użytkownika staje się coraz bardziej popularne. Uzupełnione o dane wizualne może zwiększyć ilość informacji przekazywanych użytkownikowi. Typowy uczeń wychwytuje 29% metafor wizualnych, 34% słuchowych i 37% dotykowych . Dźwięk zapewnia większą elastyczność, ponieważ można go słyszeć w promieniu 360° bez konieczności koncentracji; w porównaniu z obrazem, gdzie siatkówka oka tworzy kąt 2° wokół punktu fiksacji. W rezultacie dźwięk jest doskonałym sposobem na przyciągnięcie uwagi użytkownika. Co więcej, elementy graficzne, takie jak ikony, menu itp., mogą być wykorzystywane jako ikoniczne przedstawienie działań użytkownika.
PRZYSZŁE TRENDY
Wzrost liczby elektronicznych narzędzi edukacyjnych i środowisk e-learningowych w edukacji stale rośnie, dlatego też konieczność opracowania elastycznej struktury nauczania z interaktywnością jest kluczowa. Badania dotyczące komputeryzacji narzędzi do robienia notatek nie są tak znaczące. Niemniej jednak, badanie porównawcze dowodzi skuteczności stosowania metody robienia notatek, zwłaszcza metody Cornella, która cieszy się największą popularnością. Ponadto, rosnąca popularność multimodalnych rozwiązań, w tym dźwięków audio, a w szczególności słuchawek dousznych, wskazuje na potencjał ich łączenia w procesie uczenia się, co pozwala na czerpanie korzyści z tego doświadczenia i zwiększenie interaktywności. Co więcej, dogłębne badania nad psychologicznymi parametrami uczenia się, zwłaszcza procesami kodowania i przechowywania, wykazały potrzebę łączenia tych dwóch metod w celu optymalizacji wydajności. Wprowadzenie aplikacji do adnotacji zapoczątkowało trend w kierunku elektronicznych platform edukacyjnych, choć kwestie użyteczności, mające na celu personalizację doświadczeń studentów, wymagają dalszych badań.
WNIOSKI
Niniejszy artykuł przedstawia badanie porównawcze technik robienia notatek, procesów z nimi związanych oraz wpływu procesów poznawczych na uczenie się. Literatura sugeruje, że obecne elektroniczne narzędzia edukacyjne łączą wiele funkcji edukacyjnych, w tym notatki z wykładów, materiały pomocnicze, dyskusje itp. w jednej aplikacji. Kwestie integracji, w tym czynniki kosztowe, wady sprzętowe i awarie podzespołów prowadzące do awarii systemu, to główne problemy, na które zwrócono uwagę. Ponadto, główny nacisk położono na umiejętność i technikę robienia notatek, bez udostępnienia takiej techniki jako narzędzia elektronicznego. Dlatego też, w oparciu o wyniki badań, rozważa się zaprojektowanie i rozwój podkomponentu e-learningu - narzędzia do robienia notatek. Metoda robienia notatek opracowana przez Cornell jest prawdopodobnie bardziej skuteczna pod względem prostoty, możliwości wdrożenia w dowolnym obszarze tematycznym i adekwatności. Dlatego przyszłe prace będą uwzględniać wpływ multimediów na tę technikę, w tym earconów, struktury wizualnej, układu, a także ewentualnego włączenia mowy.
Sztuczna inteligencja i pomysły mechaniki statystycznej
WSTĘP
Odprawa ukazuje szeroki i głęboki stopień złożoności wymagany do uwzględnienia rzeczywistych czynników dyplomatycznych, informacyjnych, wojskowych i ekonomicznych (DIME) w celu propagowania/ewolucji idei w określonych populacjach. Otwarty umysł doszedłby do wniosku, że możliwe jest, że w przypadku wielu scenariuszy może być wymaganych wiele podejść od wielu decydentów. Jednakże w interesie wielu decydentów leży, aby w rzeczywistych obliczeniach w jak największym stopniu opierać się na tym samym modelu ogólnym. Wielu użytkowników musiałoby ufać, że zakodowany model będzie wierny przetwarzaniu danych wejściowych. Podobnie jak w przypadku scenariuszy DIME, wyrafinowany marketing konkurencyjny wymaga oceny reakcji populacji na nowe produkty. Wiele dużych instytucji finansowych prowadzi obecnie transakcje z prędkościami ledwo ograniczonymi prędkością światła. Umieszczają swoje serwery w pobliżu parkietów giełdowych, aby móc zamieniać notowania na zlecenia do realizacji w ciągu kilku milisekund. Oczywiście handel przy takich prędkościach wymaga zautomatyzowanych algorytmów do przetwarzania i podejmowania decyzji. Algorytmy te opierają się na informacjach "technicznych" pochodzących z informacji o cenie, wolumenie i notowaniach (Poziom II). Kolejną dużą przeszkodą w handlu automatycznym jest zwrot "podstawowe" informacje we wskaźnikach technicznych, np. w celu uwzględnienia nowych wiadomości politycznych i gospodarczych w takich algorytmach.
TŁO
Koncepcja "memów" jest przykładem podejścia do czynników DIME (Situngkir, 2004). Podejście memowe, wykorzystujące redukcjonistyczną filozofię ewolucji wśród genów, można rozsądnie skontrastować z podejściami podkreślającymi potrzebę uwzględnienia stosunkowo globalnych wpływów ewolucji. Na całym świecie prowadzonych jest wiele innych alternatywnych prac, o których należy przynajmniej pamiętać podczas opracowywania i testowania modeli ewolucji/propagowania idei w określonych populacjach: Badanie nad prostym algebraicznym modelem kształtowania opinii wykazało, że jedyne ostateczne opinie są ekstremalne. Badanie wpływu chaosu na kształtowanie się opinii, przeprowadzone przy użyciu prostego modelu algebraicznego, wykazało, że sprzeczne opinie mogą się utrzymywać i mieć kluczowe znaczenie w bliskich wyborach, aczkolwiek autorzy zwrócili uwagę na to, że większość rzeczywistych populacji prawdopodobnie nie popiera chaosu . Ograniczony przegląd prac w sieciach społecznościowych pokazuje, że istnieje mniej więcej tyle zjawisk do zbadania, ile dyscyplin jest gotowych zastosować swoje modele sieciowe.
Mechanika statystyczna interakcji kory nowej (SMNI)
Klasa algorytmów AI, która nie została jeszcze opracowana w tym kontekście, wykorzystuje informacje znane o prawdziwej korze nowej. Właściwe wydaje się oparcie podejścia do propagowania idei na jedynym, jak dotąd wykazanym systemie, który rozwija i pielęgnuje idee, tj. mózgu kory nowej. Proponowanym modelem oddolnym jest statystyczny mechaniczny model interakcji kory nowej, opracowany przez autora i pomyślnie przetestowany w opisie wskaźników pamięci krótkotrwałej (STM) i elektroencefalografii (EEG). Ideas by Statistical Mechanics (ISM) to ogólny program służący do modelowania ewolucji i propagowania idei/wzorców w populacjach podlegających interakcjom endogenicznym i egzogenicznym. ISM rozwija podzbiory aktywności makrokolumnnej wieloczynnikowych stochastycznych opisów zdefiniowanych populacji, z makrokolumnami zdefiniowanymi przez ich lokalne parametry w określonych regionach oraz ze sparametryzowanymi endogenicznymi powiązaniami międzyregionalnymi i egzogenicznymi zewnętrznymi. Parametry podzbiorów makrokolumn będą dopasowane do wzorców reprezentujących idee. Określone zostaną parametry interakcji zewnętrznych i międzyregionalnych, które sprzyjają lub utrudniają szerzenie tych idei. Dopasowanie takich układów nieliniowych wymaga zastosowania technik próbkowania. Podejście autora wykorzystuje wskazówki zawarte w jego statystycznej mechanice interakcji kory nowej (SMNI), opracowane w serii około 30 artykułów opublikowanych w latach 1981-2001. W artykułach tych poruszono także długotrwałe problemy związane z informacją mierzoną za pomocą elektroencefalografii (EEG) wynikającą z oddolnych lokalnych interakcji skupisk tysięcy do dziesiątek tysięcy neuronów oddziałujących za pośrednictwem włókien o krótkim zasięgu) lub odgórnych wpływów interakcji globalnych (za pośrednictwem włókien mielinowych dalekiego zasięgu). SMNI dokonuje tego poprzez uwzględnienie interakcji lokalnych i globalnych jako niezbędnych do opracowania obwodów kory nowej.
Mechanika statystyczna rynków finansowych (SMFM)
Narzędzia zarządzania ryzykiem finansowym, opracowane do przetwarzania skorelowanych systemów wielowymiarowych o różnych rozkładach niegaussowskich, przy użyciu nowoczesnej analizy kopuł, umożliwiają obliczenie korelacji w dobrej wierze oraz niepewności sukcesu i porażki. Od 1984 roku autor opublikował około 20 artykułów rozwijających statystyczną mechanikę rynków finansowych (SMFM), wiele z nich dostępnych jest na stronie http://www.ingber.com. Są one istotne dla ISM, aby właściwie radzić sobie z dystrybucjami w świecie rzeczywistym, które pojawiają się w tak różnorodnych kontekstach. Kopuły Gaussa opracowywane są w ramach projektu Trading in Risk Dimensions (TRD). Możliwe są inne rozkłady kopuł, np. rozkłady t-Studenta. Te alternatywne rozkłady mogą być dość powolne, ponieważ odwrotne transformacje zazwyczaj nie są tak szybkie, jak w przypadku obecnego rozkładu. Kopule są wymieniane jako ważny element zarządzania ryzykiem, który nie jest jeszcze powszechnie stosowany przez praktyków zarządzania ryzykiem.
Narzędzia do pobierania próbek
Nie należy mylić podejść obliczeniowych opracowanych w celu przetwarzania różnych podejść do modelowania zjawisk z modelami tych zjawisk. Na przykład podejście memowe dobrze nadaje się do schematu obliczeniowego w duchu algorytmów genetycznych (GA). Funkcję kosztu/celu opisującą zjawisko można oczywiście przetworzyć dowolną inną techniką pobierania próbek, taką jak symulowane wyżarzanie (SA). Jedno porównanie wykazało wyższość SA nad GA w zakresie funkcji kosztu/celu używanych w bazie danych GA. W badaniach tych wykorzystano bardzo szybkie symulowane wyżarzanie (VFSR), stworzone przez autora na potrzeby wojskowych badań symulacyjnych, które przekształciło się w symulowane wyżarzanie adaptacyjne (ASA) . Jednakże z doświadczenia autora wynika, że sztuka i nauka próbkowania złożonych systemów wymaga od badacza wiedzy specjalistycznej w zakresie dostrojenia oraz dobrych kodów, a GA lub SA prawdopodobnie równie dobrze poradziłyby sobie z funkcjami kosztów w tym badaniu. Jeśli nie ma analitycznych lub stosunkowo standardowych funkcji matematycznych dla wymaganych przekształceń, wówczas przekształcenia te muszą zostać wykonane jawnie numerycznie w kodzie, takim jak TRD. W takim razie opcja ASA_PARALLEL OPTIONS już istniejąca w ASA (opracowana w ramach projektu National Science Foundation Parallelizing ASA and PATHINT Project (PAPP) z 1994 r.) byłaby bardzo użyteczna do przyspieszenia obliczeń w czasie rzeczywistym (Ingber, 1993). Poniżej omówiono tylko kilka tematów istotnych dla ISM. Więcej szczegółów znajduje się w poprzednim raporcie.
SMNI I SMFM ZASTOSOWANE W SZTUCZNEJ INTELIGENCJI
Kora nowa ewoluowała, aby wykorzystywać minikolumny neuronów oddziałujące poprzez interakcje o krótkim zasięgu w makrokolumnach i oddziałujące poprzez interakcje o dalekim zasięgu w obszarach makrokolumn. Ta wspólna architektura przetwarza wzorce informacji w obrębie i pomiędzy różnymi obszarami kory czuciowej, ruchowej, kory skojarzeniowej itp. Dlatego też założeniem tego podejścia jest to, że jest to dobry model do opisu i analizy ewolucji/propagacji idei wśród określonych populacji. Istotne dla tego badania jest to, że przestrzenno-czasowy, krótkotrwały, warunkowy szum multiplikatywny (nieliniowy w dryfach i dyfuzjach) wielowymiarowy rozkład prawdopodobieństwa Gaussa-Markowa jest opracowany zgodnie z funkcją/fizjologią kory nowej. Takie rozkłady prawdopodobieństwa stanowią podstawowy wkład w zastosowane tutaj podejście. Model SMNI był pierwszym fizycznym zastosowaniem nieliniowego rachunku wielowymiarowego opracowanego przez innych fizyków matematycznych pod koniec lat 70. XX wieku w celu zdefiniowania mechaniki statystycznej wielowymiarowych nieliniowych układów nierównowagowych
Testy SMNI na STM i EEG
SMNI opiera się na interakcjach synaptycznych, interakcjach minikolumnowych, makrokolumnowych i regionalnych w korze nowej. Od 1981 roku opracowano serię artykułów SMNI modelujących kolumny i obszary kory nowej, obejmujące mm do cm tkanki. Większość tych artykułów wyraźnie zajmowała się obliczaniem właściwości STM i EEG skóry głowy, aby przetestować podstawowe sformułowanie tego podejścia. Modelowanie SMNI lokalnych interakcji mezokolumnowych (zbieżność i rozbieżność między interakcjami minikolumnowymi i makrokolumnowymi) przetestowano na zjawiskach STM. Modelowanie SMNI interakcji makrokolumnowych między regionami przetestowano na zjawiskach EEG.
SMNI Opis STM
Badania SMNI szczegółowo wykazały, że maksymalna liczba atraktorów znajduje się w fizycznej przestrzeni wyzwalania zarówno pobudzających, jak i hamujących wyładowań minikolumnowych, zgodnie z eksperymentalnie obserwowanymi możliwościami słuchowego i wizualnego STM, gdy mechanizm "centrujący" jest wymuszane przez przesunięcie szumu tła w interakcjach synaptycznych, zgodnie z obserwacjami eksperymentalnymi w warunkach uwagi selektywnej. Obliczenia te zostały dodatkowo poparte wysokorozdzielczą ewolucją krótkotrwałego propagatora prawdopodobieństwa warunkowego przy użyciu PATHINT. SMNI poprawnie obliczyło stabilność i czas trwania STM, zasadę pierwszeństwa kontra regułę aktualności, losowy dostęp do wspomnień w ciągu dziesiątych części sekundy, jak zaobserwowano, oraz zaobserwowaną regułę pojemności 7±2 pamięci słuchowej i zaobserwowaną regułę pojemności 4±2 pamięci wzrokowej . SMNI oblicza również, w jaki sposób wzorce STM (np. z danego regionu lub nawet zagregowane z wielu regionów) mogą być kodowane poprzez dynamiczną modyfikację parametrów synaptycznych (w zakresach obserwowanych eksperymentalnie) we wzorce pamięci długotrwałej (LTM)
SMNI Opis EEG
Wykorzystując siłę tej formalnej struktury, zestawy danych EEG i potencjalnych danych wywołanych z oddzielnego badania NIH, zebrane w celu zbadania genetycznych predyspozycji do alkoholizmu, dopasowano do modelu SMNI na siatce regionalnych elektrod w celu wyodrębnienia "sygnatur" mózgu STM. Każde miejsce elektrody było reprezentowane przez rozkład SMNI niezależnych stochastycznych zmiennych wypalania w skali makrokolumnowej, połączonych ze sobą obwodami dalekiego zasięgu z opóźnieniami odpowiednimi dla komunikacji długich włókien w korze nowej. Do wykonania dopasowań Lagrangianów o największej wiarygodności zdefiniowanych przez całki po ścieżkach wielowymiarowych prawdopodobieństw warunkowych wykorzystano globalny algorytm optymalizacji ASA. W ten sposób uzyskano kanoniczne wskaźniki pędu (CMI) dla indywidualnych danych EEG. Wskaźniki CMI zapewniają lepsze rozpoznawanie sygnału niż surowe dane i zostały z korzyścią wykorzystane jako korelaty stanów behawioralnych. Do szkolenia wykorzystano dane pochodzące z próby, a dane spoza próby wykorzystano do przetestowania tych dopasowań. Architekturę ISM modeluje się przy użyciu skal podobnych do tych stosowanych w przypadku lokalnej łączności STM i globalnej łączności EEG.
Ogólne mezoskopowe sieci neuronowe
SMNI zastosowano do równoległych ogólnych mezoskopowych sieci neuronowych (MNN) , dodając moc obliczeniową do podobnego paradygmatu zaproponowanego do rozpoznawania celu. "Uczenie się" odbywa się poprzez prezentację MNN danych i parametryzację danych pod kątem wypaleń lub wypaleń wieloczynnikowych. "Wagi", czyli współczynniki funkcji zapłonów pojawiające się w dryfach i dyfuzjach, są dopasowane do napływających danych, biorąc pod uwagę łączny "efektywny" Lagranżian (w tym logarytm preczynnika w rozkładzie prawdopodobieństwa) jako dynamiczną funkcję kosztu. Ten program dopasowywania współczynników w Lagrangianie wykorzystuje metody ASA. "Przewidywanie" trwa zaleta matematycznie równoważnej reprezentacji algorytmu całki po ścieżce Lagrangianu, tj. zestawu sprzężonych równań szybkości Langevina. Zgrubne oszacowanie deterministyczne w celu "przewidywania" ewolucji można zastosować przy użyciu najbardziej prawdopodobnej ścieżki, ale PATHINT był użyty. PATHINT, nawet gdy jest zrównoleglony, zazwyczaj może być zbyt wolny, aby "przewidywać" ewolucję tych systemów. Jednak PATHTREE jest znacznie szybszy.
Architektura dla wybranego modelu ISM
Głównym celem jest dostarczenie modelu komputerowego zawierającego następujące cechy: (1) Zdefiniowana zostanie przestrzeń wielu zmiennych, aby pomieścić populacje. (2) Zdefiniowana zostanie funkcja kosztu po zmiennych populacji w (1), aby wyraźnie zdefiniować wzorzec które można zidentyfikować jako Ideę. Bardzo ważną kwestią w tym projekcie jest opracowanie funkcji kosztów, a nie tylko tego, jak je dopasować czy przetworzyć. (3) Podzbiory populacji zostaną wykorzystane w celu dopasowania parametrów - np. współczynników zmiennych, powiązań z wzorcami itp. - pomysł, korzystając z funkcji kosztu w (2). (4) Połączenie ludności w (3) zostanie zapewnione z resztą populacji. Zostaną przeprowadzone badania w celu ustalenia, jaka endogenna łączność jest wymagana, aby zatrzymać lub promować rozprzestrzenianie się Idei na inne regiony populacji. (5) Zostaną wprowadzone siły zewnętrzne, np. działające tylko na określone regiony populacji, aby określić, w jaki sposób te siły zewnętrzne mogą powstrzymać lub sprzyjać rozprzestrzenianiu się Idei. Zastosowanie modelu SMNI Podejście polega na opracowaniu podzbiorów idei/aktywności makrokolumnowej wielowymiarowych opisów stochastycznych określonych populacji (rozsądnych, ale małych próbek populacji, np. 100-1000), z makrokolumnami zdefiniowanymi przez ich lokalne parametry w określonych regionach ( większe próbki populacji) oraz ze sparametryzowanymi, dalekosiężnymi powiązaniami międzyregionalnymi i zewnętrznymi. Parametry danego podzbioru makrokolumn zostaną dopasowane przy użyciu ASA do wzorców reprezentujących pomysły, podobnie jak w przypadku uzyskiwania stałych długoterminowych wzorców (LTM). Określone zostaną parametry interakcji zewnętrznych i międzyregionalnych, które sprzyjają lub hamują rozprzestrzenianie się tych Idei, poprzez określenie stopnia dopasowania i nakładania się rozkładów prawdopodobieństwa w stosunku do zaszczepionych makrokolumn. Oznacza to, że mogą być reprezentowane te same pomysły/wzorce w innych niż zasiane makrokolumnach poprzez lokalne zbiegi makrokolumn i wyładowań dalekiego zasięgu, podobnie jak STM, lub za pomocą różnych ustalonych na stałe zestawów parametrów LTM, które mogą obsługiwać te same lokalne wystrzeliwania w innych regionach (możliwe w systemach nieliniowych). SMNI oblicza również, w jaki sposób STM może być dynamicznie kodowany w LTM (Ingber, 1983). Próbki małych populacji w regionach zostaną pobrane w celu ustalenia, czy propagowane Pomysły istnieją w swojej przestrzeni wzorców, w której istniały przed interakcjami z zasianą populacją. SMNI wyprowadza funkcje nieliniowe jako argumenty rozkładów prawdopodobieństwa, prowadząc do wielu STM, np. 7 ± 2 dla pojemności pamięci słuchowej. Przeprowadzone zostaną pewne badania nieliniowych form funkcjonalnych innych niż te wyprowadzone dla SMNI, np. mających możliwości dziesiątek lub setek wzorów dla ISM.
Zastosowanie analizy TRD
Podejście to obejmuje zastosowanie metod analizy ryzyka portfela do takich systemów statystycznych, korygując dwa rodzaje błędów popełnianych w wielowymiarowych analizach ryzyka: (E1) Chociaż rozkłady branych pod uwagę zmiennych nie są gaussowskie (lub nie są testowane, aby zobaczyć, jak blisko są Gaussa), stosowane są standardowe obliczenia statystyczne właściwe tylko dla rozkładów Gaussa. (E2) Albo ignorowane są korelacje pomiędzy zmiennymi, albo błędy popełnione w (E1) - błędne założenie, że zmienne są gaussowskie - są spotęgowane poprzez obliczenie korelacji tak, jakby wszystkie zmienne były gaussowskie. Należy rozumieć, że każdy algorytm próbkowania przetwarzający ogromną liczbę stanów może znaleźć wiele zastosowań do zapisania wielu optimów podczas próbkowania. Niektóre algorytmy mogą oznaczyć te stany jako "mutacje" stanów optymalnych. Ważne jest, aby móc je uwzględnić w ostatecznych decyzjach, np. o zastosowaniu dodatkowych mierników wydajności specyficznych dla aplikacji. Doświadczenie z portfelami zarządzającymi ryzykiem pokazuje, że nie najlepiej jest uwzględnić wszystkie kryteria, łącząc je wszystkie w jedną funkcję kosztu, lecz należy raczej kierować się rozsądną oceną w odniesieniu do wielu etapów przetwarzania wstępnego i przetwarzania końcowego podczas przeprowadzania takiego pobierania próbek, np. dodawania dodatkowych metryki wydajności.
PRZYSZŁE TRENDY
Biorąc pod uwagę motywacje finansowe i polityczne do łączenia informacji omówionych we wstępie, nieuniknione jest opracowanie wielu algorytmów sztucznej inteligencji, a wiele obecnych algorytmów sztucznej inteligencji zostanie udoskonalonych, aby rozwiązać te problemy.
WNIOSEK
Wydaje się właściwe oparcie podejścia do propagowania idei ogólnych na jedynym, jak dotąd wykazanym systemie, który rozwija i pielęgnuje idee, tj. mózgu kory nowej. Proponowanym modelem jest statystyczny mechaniczny model interakcji kory nowej, opracowany przez autora i pomyślnie przetestowany w opisie pamięci krótkotrwałej i wskaźników EEG, Ideas by Statistical Mechanics (ISM) . ISM rozwija podzbiory aktywności makrokolumnnej wieloczynnikowych stochastycznych opisów zdefiniowanych populacji, z makrokolumnami zdefiniowanymi przez ich lokalne parametry w określonych regionach oraz ze sparametryzowanymi endogenicznymi powiązaniami międzyregionalnymi i egzogenicznymi zewnętrznymi. Narzędzia zarządzania ryzykiem finansowym, opracowane do przetwarzania skorelowanych systemów wielowymiarowych o różnych rozkładach niegaussowskich przy użyciu nowoczesnej analizy kopuł, próbkowania ważności przy użyciu ASA, umożliwią obliczenie korelacji w dobrej wierze oraz niepewności sukcesu i porażki
Spacer AI od farmakokinetyki do marketingu
WSTĘP
Niniejsza praca ma na celu zapewnienie przeglądu praktycznych zastosowań metod sztucznej inteligencji (AI). Skupiamy się na wykorzystaniu metod uczenia maszynowego (ML) stosowanych raczej do rzeczywistych problemów niż problemów syntetycznych ze standardowym i kontrolowanym środowiskiem. W szczególności opiszemy następujące problemy w kolejnych sekcjach:
o Optymalizacja dawkowania erytropoetyny (EPO) u pacjentów z niedokrwistością przechodzących przewlekłą niewydolność nerek (CRF).
o Optymalizacja systemu rekomendacji dla użytkowników portalu internetowego dla obywateli.
o Optymalizacja kampanii marketingowej.
Wybór tych problemów wynika z ich trafności i heterogeniczności. Ta heterogeniczność pokazuje możliwości i wszechstronność metod ML w rozwiązywaniu rzeczywistych problemów w bardzo różnych dziedzinach wiedzy. W tej pracy zostaną omówione następujące metody:
o Sztuczne sieci neuronowe (ANN): Perceptron wielowarstwowy (MLP), sieć neuronowa o skończonej odpowiedzi impulsowej (FIR), sieć Elmana, mapy samoorganizujące (SOM) i adaptacyjna teoria rezonansu (ART).
o Inne algorytmy klastrowania: K-Means, algorytm maksymalizacji oczekiwań (EM), Fuzzy C-Means (FCM), algorytmy hierarchicznego klastrowania (HCA).
o Uogólniona autoregresyjna warunkowa heteroskedastyczność (GARCH).
o Regresja wektorów nośnych (SVR).
o Techniki filtrowania kolaboracyjnego.
o Metody uczenia się przez wzmacnianie (RL).
KONTEKST
Celem tej komunikacji jest podkreślenie możliwości metod ML w dostarczaniu praktycznych i skutecznych rozwiązań w trudnych zastosowaniach w świecie rzeczywistym. Aby praca była łatwa do odczytania, skupiamy się na każdej z trzech oddzielnych domen, a mianowicie farmakokinetyce (PK), systemach rekomendacji internetowych i marketingu
Farmakokinetyka
Systemy wspomagania podejmowania decyzji klinicznych wykorzystują metody sztucznej inteligencji (AI) od końca lat pięćdziesiątych. Niemniej jednak dopiero w latach dziewięćdziesiątych systemy wspomagania decyzji były rutynowo stosowane w praktyce klinicznej na znaczną skalę. W szczególności ANN były szeroko stosowane w zastosowaniach medycznych w ciągu ostatnich dwóch dekad. Jednym z pierwszych istotnych badań obejmujących ANN i monitorowanie leków terapeutycznych było. W tej pracy opracowano system ostrzegania o interakcjach leków oparty na ANN z komputerowym systemem wprowadzania danych medycznych w czasie rzeczywistym. Skupiając się na problemach bliższych rzeczywistym zastosowaniom, które zostaną opisane w następnej sekcji, istnieje również szereg niedawnych prac dotyczących wykorzystania ML do dostarczania leków w chorobie nerek. Na przykład porównanie niepożądanych reakcji na leki związane z nerkami pomiędzy rofekoksybem i celekoksybem, w oparciu o bazę danych bezpieczeństwa WHO/Uppsala Monitoring Centre. Nieproporcjonalność w związku pomiędzy konkretnym lekiem a niepożądanymi reakcjami na leki związanymi z nerkami została oceniona przy użyciu metody sieci neuronowej propagacji zaufania bayesowskiego. Badanie przewidywania dawkowania cyklosporyny u pacjentów po przeszczepie nerki przy użyciu sieci neuronowych i metod opartych na jądrze zostało przeprowadzone w Camps . Przeprowadzono analizę populacyjną farmakodynamiki u pacjentów z przewlekłą niewydolnością nerek przy użyciu sieci neuronowych. Takie modele pozwalają na dostosowanie schematu dawkowania. Wreszcie zaproponowano wykorzystanie sieci neuronowych do optymalizacji dawkowania EPO u pacjentów przechodzących niedokrwistość związaną z przewlekłą niewydolnością nerek.
Systemy rekomendacji internetowych
Systemy rekomendacji są szeroko stosowane w witrynach internetowych, w tym w Google. Głównym celem tych systemów jest rekomendowanie obiektów, którymi użytkownik może być zainteresowany. Zastosowano dwa główne podejścia: filtrowanie oparte na treści i filtrowanie grupowe , chociaż zaproponowano również inne rodzaje technik . Rekomendacje grupowe agregują oceny rekomendacji obiektów, znajdują podobieństwa użytkowników na podstawie ich ocen i na koniec dostarczają nowe rekomendacje na podstawie porównań między użytkownikami. Niektóre z najbardziej odpowiednich systemów wykorzystujących tę technikę to GroupLens/NetPerceptions i Recommender. Główną zaletą technik grupowych jest to, że są one niezależne od jakiejkolwiek czytelnej maszynowo reprezentacji obiektów i że dobrze sprawdzają się w przypadku złożonych obiektów, w których subiektywne osądy odpowiadają za znaczną część zmienności preferencji. Uczenie się oparte na treści jest stosowane, gdy przeszłe zachowanie użytkownika jest wiarygodnym wskaźnikiem jego przyszłego zachowania. Jest ono szczególnie odpowiednie w sytuacjach, w których użytkownicy mają tendencję do wykazywania idiosynkratycznych zachowań. Jednak takie podejście wymaga systemu zbierającego stosunkowo duże ilości danych od każdego użytkownika w celu umożliwienia sformułowania modelu statystycznego. Przykładami systemów tego typu są systemy rekomendacji tekstów, takie jak system filtrowania grup dyskusyjnych, NewsWeeder, który wykorzystuje słowa ze swoich tekstów jako funkcje.
Marketing
Najnowsze trendy marketingowe są bardziej skoncentrowane na utrzymaniu obecnych klientów i optymalizacji ich zachowań niż na pozyskiwaniu nowych. Z tego powodu marketing relacyjny koncentruje się na tym, co firma musi zrobić, aby osiągnąć ten cel. Relacje między firmą a jej klientami podążają za sekwencją systemu akcji-odpowiedzi, w którym klienci mogą modyfikować swoje zachowanie zgodnie z działaniami marketingowymi opracowanymi przez firmę. Opracowanie dobrej i zindywidualizowanej polityki nie jest łatwe, ponieważ należy wziąć pod uwagę wiele zmiennych. Aplikacje tego rodzaju można postrzegać jako problem łańcucha Markowa, w którym firma decyduje, jakie działanie podjąć, gdy znane są właściwości klienta w bieżącym stanie (czas t). Do rozwiązania tego zadania można wykorzystać uczenie się przez wzmacnianie (RL), ponieważ poprzednie aplikacje wykazały jego przydatność w tym obszarze. Zastosowano do analizy mailingu poprzez badanie, jak działanie w czasie t wpływa na działania w kolejnych czasach. Kilka algorytmów RL zostało przetestowanych pod kątem problemów mailingowych. RL zastosowano do optymalizacji marketingu wielokanałowego.
Systemy rekomendacji internetowych
Systemy rekomendacji są szeroko stosowane w witrynach internetowych, w tym w Google. Głównym celem tych systemów jest rekomendowanie obiektów, którymi użytkownik może być zainteresowany. Zastosowano dwa główne podejścia: filtrowanie oparte na treści i filtrowanie grupowe , chociaż zaproponowano również inne rodzaje technik . Rekomendacje grupowe agregują oceny rekomendacji obiektów, znajdują podobieństwa użytkowników na podstawie ich ocen i na koniec dostarczają nowe rekomendacje na podstawie porównań między użytkownikami. Niektóre z najbardziej odpowiednich systemów wykorzystujących tę technikę to GroupLens/NetPerceptions i Recommender. Główną zaletą technik grupowych jest to, że są one niezależne od jakiejkolwiek czytelnej maszynowo reprezentacji obiektów i że dobrze sprawdzają się w przypadku złożonych obiektów, w których subiektywne osądy odpowiadają za znaczną część zmienności preferencji. Uczenie się oparte na treści jest stosowane, gdy przeszłe zachowanie użytkownika jest wiarygodnym wskaźnikiem jego przyszłego zachowania. Jest ono szczególnie odpowiednie w sytuacjach, w których użytkownicy mają tendencję do wykazywania idiosynkratycznych zachowań. Jednak takie podejście wymaga systemu zbierającego stosunkowo duże ilości danych od każdego użytkownika w celu umożliwienia sformułowania modelu statystycznego. Przykładami systemów tego typu są systemy rekomendacji tekstów, takie jak system filtrowania grup dyskusyjnych, NewsWeeder, który wykorzystuje słowa ze swoich tekstów jako funkcje.
Marketing
Najnowsze trendy marketingowe są bardziej skoncentrowane na utrzymaniu obecnych klientów i optymalizacji ich zachowań niż na pozyskiwaniu nowych. Z tego powodu marketing relacyjny koncentruje się na tym, co firma musi zrobić, aby osiągnąć ten cel. Relacje między firmą a jej klientami podążają za sekwencją systemu akcji-odpowiedzi, w którym klienci mogą modyfikować swoje zachowanie zgodnie z działaniami marketingowymi opracowanymi przez firmę. Opracowanie dobrej i zindywidualizowanej polityki nie jest łatwe, ponieważ należy wziąć pod uwagę wiele zmiennych. Aplikacje tego rodzaju można postrzegać jako problem łańcucha Markowa, w którym firma decyduje, jakie działanie podjąć, gdy znane są właściwości klienta w bieżącym stanie (czas t). Do rozwiązania tego zadania można wykorzystać uczenie się przez wzmacnianie (RL), ponieważ poprzednie aplikacje wykazały jego przydatność w tym obszarze. RL zastosowano do analizy mailingu poprzez badanie, w jaki sposób działanie w czasie t wpływa na działania w kolejnych czasach. Kilka algorytmów RL zostało przetestowanych pod kątem problemów mailingowych. RL zostało użyte do optymalizacji marketingu wielokanałowego.
WKŁAD AI W APLIKACJE RZECZYWISTE
Poprzednia sekcja zawierała przegląd powiązanych prac. W tej sekcji skupimy się na pokazaniu doświadczenia autorów w używaniu AI do rozwiązywania rzeczywistych problemów. Aby pokazać wszechstronność metod AI, skupimy się na konkretnych zastosowaniach z trzech różnych dziedzin wiedzy, tych samych, które zostały omówione w poprzedniej sekcji.
Farmakokinetyka
Chociaż pracowaliśmy również nad innymi problemami farmakokinetycznymi, w tej pracy skupiamy się na być może najistotniejszym problemie, jakim jest optymalizacja dawek EPO u pacjentów w ramach programu hemodializy. Pacjenci cierpiący na CRF mają tendencję do cierpienia na towarzyszącą temu niedokrwistość. EPO jest leczeniem z wyboru w przypadku tego rodzaju niedokrwistości. Stosowanie tego leku znacznie zmniejszyło problemy sercowo-naczyniowe i konieczność wielokrotnych transfuzji. Jednak EPO jest drogie, co sprawia, że i tak kosztowny program CRF jest jeszcze bardziej kosztowny. Ponadto istnieją znaczne ryzyka związane z EPO, takie jak zakrzepy i zatory oraz problemy naczyniowe, jeśli poziom hemoglobiny (Hb) jest zbyt wysoki lub wzrasta zbyt szybko. W związku z tym optymalizacja dawkowania ma kluczowe znaczenie dla zapewnienia odpowiedniej farmakoterapii, a także rozsądnych kosztów leczenia. Modele populacyjne, szeroko stosowane przez badaczy z Farmakokinetyki, nie nadają się do rozwiązania tego problemu, ponieważ odpowiedź na leczenie EPO jest w dużym stopniu zależna od pacjenta. Te same dawki mogą mieć bardzo różne reakcje u różnych pacjentów, w szczególności u tak zwanych pacjentów opornych na EPO, którzy nie reagują na leczenie EPO, nawet po otrzymaniu dużych dawek. Dlatego lepiej jest skupić się na indywidualnym leczeniu. Nasze pierwsze podejście do tego problemu opierało się na przewidywaniu poziomu Hb przy określonej podanej dawce EPO. Chociaż ostatecznym celem jest indywidualizacja dawek EPO, nie przewidywaliśmy dawki EPO, ale poziom Hb. Powodem jest to, że predyktory EPO modelowałyby protokół lekarza, podczas gdy predyktory Hb modelują odpowiedź organizmu na leczenie, będąc tym samym bardziej "obiektywnym" podejściem. W szczególności zastosowano następujące modele: GARCH (Hamilton, 1994), MLP, sieć neuronowa FIR, rekurencyjna sieć neuronowa Elmana i SVR. Uzyskano dokładne modele predykcyjne, szczególnie przy użyciu ANN i SVR. Dynamiczne sieci neuronowe (tj. FIR i rekurencyjne) nie przewyższyły w szczególności statycznego MLP, prawdopodobnie ze względu na krótki czas trwania szeregu czasowego. Opracowano łatwą w użyciu aplikację programową, z której mogli korzystać lekarze, w której po wprowadzeniu danych pacjentów i określonej dawki EPO wyświetlano przewidywany poziom Hb na następny miesiąc. Chociaż modele predykcyjne były dokładne, zdaliśmy sobie sprawę, że to podejście do predykcji miało poważną wadę. Pomimo uzyskania dokładnych modeli, nie udało nam się jeszcze znaleźć prostego sposobu na przeniesienie wyodrębnionej wiedzy do codziennej praktyki klinicznej, ponieważ lekarze musieli "bawić się" różnymi dawkami, aby przeanalizować najlepsze rozwiązanie w celu osiągnięcia określonego poziomu Hb. Lepiej byłoby mieć automatyczny model, który sugeruje działania, które należy podjąć, aby osiągnąć docelowy zakres Hb, niż to "pośrednie" podejście. Ta refleksja skłoniła nas do zbadania nowych modeli i wpadliśmy na pomysł wykorzystania RL. Obecnie pracujemy nad tym tematem, ale już osiągnęliśmy obiecujące wyniki, znajdując zasady (sekwencję działań), które wydają się być lepsze od tych stosowanych w szpitalu, tj. istnieje większa liczba pacjentów w pożądanym docelowym poziomie Hb pod koniec leczenia.
Systemy rekomendacji internetowych
W tej podsekcji opisano zupełnie inne zastosowanie, a mianowicie rozwój systemów rekomendacji internetowych. Autorzy zaproponowali nowe podejście do rozwoju systemów rekomendacji opartych na filtrowaniu kolaboracyjnym, ale obejmujących również analizę wykonalności rekomendacji przy użyciu etapu predykcji. Podstawowym pomysłem było wykorzystanie algorytmów klastrowania w celu znalezienia grup podobnych użytkowników. Pod uwagę wzięto następujące algorytmy klastrowania: KMeans, FCM, HCA, algorytm EM, SOM i ART. Nowi użytkownicy zostali przypisani do jednej z grup znalezionych przez te algorytmy klastrowania, a następnie zostali oni poleceni za pomocą usług internetowych, do których zwykle uzyskiwali dostęp inni użytkownicy z tej samej grupy, ale do których nie uzyskali jeszcze dostępu ci nowi użytkownicy (w celu zmaksymalizowania użyteczności podejścia). Korzystając z kontrolowanych zestawów danych, badanie wykazało, że ART i SOM wykazały bardzo dobre zachowanie ze zestawami danych o bardzo różnych cechach, podczas gdy HCA i EM wykazały akceptowalne zachowanie pod warunkiem, że wymiarowość zestawu danych nie była zbyt wysoka, a nakładanie się było niewielkie. Algorytmy oparte na K-Means osiągnęły najbardziej ograniczony sukces w akceptacji oferowanych rekomendacji. Mimo że wykorzystanie RL zostało zbadane tylko w niewielkim stopniu, wydaje się, że jest to odpowiedni wybór dla tego problemu, ponieważ wewnętrzna dynamika problemu jest łatwo rozwiązywana przez RL, a ponadto interferencja między interfejsem rekomendacji a użytkownikiem może zostać zminimalizowana dzięki odpowiedniej definicji nagród
Marketing
Ostatnie zastosowanie, o którym zostanie wspomniane w tej komunikacji, jest związane z marketingiem. Jednym ze sposobów zwiększenia lojalności klientów jest zaoferowanie im możliwości otrzymania prezentów w wyniku zakupów w określonej firmie. Firma może przyznać wirtualne kredyty każdemu, kto kupi określone artykuły, zazwyczaj te, które firma jest zainteresowana promować. Po dokonaniu określonej liczby zakupów klienci mogą wymienić swoje wirtualne kredyty na prezenty oferowane przez firmę. Problem polega na ustaleniu odpowiedniej liczby wirtualnych kredytów dla każdego promowanego przedmiotu. Zgodnie z polityką firmy oczekuje się, że im wyższy przydział kredytów, tym wyższa kwota zakupów. Jednak zyski firmy są niższe, ponieważ kampania marketingowa dodaje firmie dodatkowych kosztów. Celem jest osiągnięcie kompromisu poprzez ustalenie optymalnej polityki. Zaproponowaliśmy podejście RL w celu optymalizacji tej kampanii marketingowej. Ta konkretna aplikacja, której cechy opisano poniżej, jest znacznie trudniejsza niż inne podejścia RL do marketingu wymienione w sekcji Tło. Wynika to zasadniczo z faktu, że istnieje wiele innych różnych działań, które można podjąć. Informacje wykorzystane w badaniu odpowiadają pięciu miesiącom kampanii, obejmującej 1 264 862 transakcje, 1 004 artykuły i 3 573 klientów. RL może radzić sobie z wewnętrzną dynamiką, a poza tym ma atrakcyjną zaletę, która jest w stanie zmaksymalizować tak zwaną długoterminową nagrodę. Jest to szczególnie istotne w tym zastosowaniu, ponieważ firma jest zainteresowana maksymalizacją zysków pod koniec kampanii, a klient, który nie generuje dużych zysków w pierwszych miesiącach kampanii, może jednak dokonać wielu dochodowych transakcji w przyszłości. Nasze pierwsze wyniki pokazały, że zyski przy użyciu polityki opartej na RL zamiast polityki stosowanej przez firmę do tej pory, mogą nawet podwoić długoterminowe zyski pod koniec kampanii .
WNIOSEK I PRZYSZŁE TRENDY
Niniejszy artykuł wykazał możliwości i wszechstronność różnych metod AI do zastosowania w rzeczywistych problemach, zilustrowanych trzema konkretnymi zastosowaniami w różnych domenach. Oczywiste jest, że metodologia jest ogólna i równie dobrze sprawdza się w wielu innych dziedzinach, pod warunkiem, że informacje zawarte w danych są wystarczająco bogate, aby wymagać nieliniowego modelowania i są w stanie obsługiwać wydajność predykcyjną, która ma wartość praktyczną. Jako kolejny przyszły trend należy podkreślić, że metody AI są coraz bardziej popularne w zastosowaniach biznesowych w ostatnich latach, rzucając wyzwanie klasycznym modelom biznesowym. W szczególnym przypadku RL potencjał komercyjny tej potężnej metodologii został znacząco niedoceniony, ponieważ jest ona stosowana niemal wyłącznie w robotyce. Uważamy, że jest to metodologia, która wciąż wymaga wykorzystania w wielu rzeczywistych zastosowaniach, jak pokazaliśmy w tym artykule.
Środowiska inteligencji otoczenia
WSTĘP
Trend w kierunku redukcji kosztów sprzętu i miniaturyzacji pozwala na włączanie urządzeń komputerowych do wielu obiektów i środowisk (systemy wbudowane). Inteligencja otoczenia (AmI) zajmuje się nowym światem, w którym urządzenia komputerowe są wszędzie rozproszone (wszechobecność), umożliwiając ludziom interakcję w środowiskach świata fizycznego w sposób inteligentny i dyskretny. Środowiska te powinny być świadome potrzeb ludzi, dostosowywać wymagania i prognozować zachowania. Środowiska AmI mogą być tak różnorodne, jak domy, biura, sale konferencyjne, szkoły, szpitale, centra kontroli, transport, atrakcje turystyczne, sklepy, instalacje sportowe i urządzenia muzyczne. Inteligencja otoczenia obejmuje wiele różnych dyscyplin, takich jak automatyzacja (czujniki, sterowanie i siłowniki), interakcja człowiek-maszyna i grafika komputerowa, komunikacja, wszechobecne przetwarzanie, systemy wbudowane i oczywiście sztuczna inteligencja. Celem badań nad sztuczną inteligencją jest wprowadzenie większej inteligencji do środowisk AmI, co pozwoli na lepsze wsparcie człowieka i dostęp do niezbędnej wiedzy, aby podejmować lepsze decyzje podczas interakcji z tymi środowiskami.
KONTEKST
Ambient Intelligence (AmI) to koncepcja opracowana przez Grupę Doradczą ds. IST Komisji Europejskiej ISTAG (ISTAG, 2001)(ISTAG, 2002). ISTAG uważa, że konieczne jest holistyczne spojrzenie na Ambient Intelligence, biorąc pod uwagę nie tylko technologię, ale cały łańcuch dostaw innowacji od nauki do użytkownika końcowego, a także różne cechy środowiska akademickiego, przemysłowego i administracyjnego, które ułatwiają lub utrudniają realizację wizji AmI (ISTAG, 2003). Ze względu na dużą liczbę technologii zaangażowanych w koncepcję Ambient Intelligence możemy znaleźć kilka prac, które pojawiły się jeszcze przed wizją ISTAG, wskazujących na trendy Ambient Intelligence. Jeśli chodzi o sztuczną inteligencję (AI), Ambient Intelligence jest nowym znaczącym krokiem w ewolucji AI. AI ściśle kroczyło ramię w ramię z ewolucją informatyki i inżynierii. Budowa pierwszych sztucznych modeli neuronowych i sprzętu, z pracą Waltera Pittsa i Warrena McCullocka (Pitts & McCullock, 1943) oraz systemem SNARC Marvina Minsky′ego i Deana Edmondsa odpowiada pierwszemu krokowi. Inteligentne systemy komputerowe, takie jak system ekspercki MYCIN lub inteligentne systemy sieciowe, takie jak AUTHORIZER′S ASSISTANT używane przez American Express do autoryzacji transakcji, konsultujące kilka baz danych, są rodzajem systemów drugiego kroku AI. Od lat 80. inteligentni agenci i systemy wieloagentowe ustanowiły trzeci krok, prowadząc ostatnio do ontologii i sieci semantycznej. Od sprzętu do komputera, od komputera do sieci lokalnej, od sieci lokalnej do Internetu i od Internetu do sieci, sztuczna inteligencja była na poziomie najnowocześniejszych obliczeń, najczęściej trochę wyprzedzając granice technologii. Teraz centrum nie znajduje się już w sprzęcie, komputerze, ani nawet w sieci. Inteligencja musi zostać wprowadzona do naszych codziennych środowisk. Jesteśmy świadomi nacisku w kierunku Inteligentnych Domów, Inteligentnych Pojazdów, Inteligentnych Systemów Transportowych, Inteligentnych Systemów Produkcyjnych, a nawet Inteligentnych Miast. To jest powód, dla którego koncepcja Ambient Intelligence jest obecnie tak ważna. Ambient Intelligence nie jest możliwa bez Sztucznej Inteligencji. Z drugiej strony badacze AI muszą być świadomi potrzeby zintegrowania swoich technik z technikami innych społeczności naukowych (np. Automatyzacja, Grafika Komputerowa, Komunikacja). Ambient Intelligence to ogromne wyzwanie, wymagające większego wysiłku różnych społeczności naukowych. Istnieje wiele różnych koncepcji i technologii związanych z Ambient Intelligence. Ubiquitous Computing, Pervasive Computing, Embedded Systems i Context Awareness to najpopularniejsze z nich. Jednak te koncepcje różnią się od Ambient Intelligence. Koncepcja Ubiquitous Computing (UbiComp) została wprowadzona przez Marka Weisera podczas jego kadencji jako głównego technologa w Palo Alto Research Center (PARC). Ubiquitous Computing oznacza, że mamy dostęp do urządzeń obliczeniowych w dowolnym miejscu w sposób zintegrowany i spójny. Ubiquitous Computing był głównie napędzany przez społeczności naukowe zajmujące się urządzeniami komunikacyjnymi i komputerowymi, ale teraz obejmuje inne obszary badawcze. Ambient Intelligence różni się od Ubiquitous Computing, ponieważ czasami środowisko, w którym rozważa się Ambient Intelligence, jest po prostu lokalne. Inną różnicą jest to, że Ambient Intelligence kładzie większy nacisk na inteligencję niż Ubiquitous Computing. Jednak wszechobecność jest dziś rzeczywistą potrzebą, a systemy Ambient Intelligence biorą pod uwagę tę cechę. Koncepcja, która czasami jest postrzegana jako synonim Ubiquitous Computing, to Pervasive Computing. Według Teresy Dillon, Ubiquitous Computing najlepiej jest postrzegać jako podstawową strukturę, wbudowane systemy, sieci i wyświetlacze, które są niewidoczne i wszędzie, pozwalając nam na "podłączanie i odtwarzanie" urządzeń i narzędzi. Z drugiej strony, Pervasive Computing jest związane ze wszystkimi fizycznymi częściami naszego życia; telefonem komórkowym, komputerem przenośnym lub inteligentną kurtką. Embedded Systems oznacza, że urządzenia elektroniczne i komputerowe są osadzone w obecnych obiektach lub towarach. Obecnie towary, takie jak samochody, są wyposażone w mikroprocesory; to samo dotyczy pralek, lodówek i zabawek. Społeczność Embedded Systems jest bardziej napędzana przez społeczności naukowe zajmujące się elektroniką i automatyzacją. Obecne wysiłki zmierzają w kierunku włączenia urządzeń elektronicznych i komputerowych do najbardziej powszechnych i prostych przedmiotów, których używamy, takich jak meble lub lustra. Ambient Intelligence różni się od Embedded Systems, ponieważ urządzenia komputerowe mogą być wyraźnie widoczne w scenariuszach AmI. Istnieje jednak wyraźna tendencja do angażowania większej liczby systemów wbudowanych w Ambient Intelligence. Context Awareness oznacza, że system jest świadomy bieżącej sytuacji, z którą mamy do czynienia. Przykładem jest automatyczne wykrywanie bieżącej sytuacji w Centrum Kontroli. Czy mamy do czynienia z normalną sytuacją, czy też z sytuacją krytyczną, a nawet awarią? W tym Centrum Kontroli inteligentny procesor alarmowy będzie wykazywał różne wyniki w zależności od zidentyfikowanej sytuacji. Przemysł samochodowy inwestuje również w systemy Context Aware, takie jak wykrywanie niemal wypadków. Społeczność naukowa zajmująca się interakcją człowiek-komputer poświęca wiele uwagi Context Awareness. Context Awareness jest jedną z najbardziej pożądanych koncepcji do uwzględnienia w Ambient Intelligence, identyfikacja kontekstu jest ważna dla podjęcia decyzji o działaniu w sposób inteligentny. Istnieją różne poglądy na temat znaczenia innych koncepcji i technologii w dziedzinie Ambient Intelligence. Zwykle te różnice wynikają z podstawowej społeczności naukowej autorów. ISTAG widzi wymagania dotyczące badań technologicznych z różnych punktów widzenia (komponenty, integracja, system i użytkownik/osoba). W (ISTAG, 2003) wymienione są następujące komponenty otoczenia: inteligentne materiały; technologie MEMS i czujników; systemy wbudowane; wszechobecna komunikacja; technologia urządzeń wejścia/wyjścia; oprogramowanie adaptacyjne. W tym samym dokumencie ISTAG odnosi się do następujących komponentów inteligencji: zarządzanie i obsługa mediów; naturalna interakcja; inteligencja obliczeniowa; świadomość kontekstu; i obliczenia emocjonalne. Ostatnio inteligencja otoczenia otrzymuje znaczną uwagę ze strony społeczności sztucznej inteligencji. Możemy odnieść się do warsztatów poświęconych inteligencji otoczenia, zorganizowanych przez Juana Augusto i Daniela Shapiro na ECAI'2006 (Europejskiej Konferencji na temat Sztucznej Inteligencji) i IJCAI'2007 (Międzynarodowej Wspólnej Konferencji na temat Sztucznej Inteligencji), a także do numeru specjalnego poświęconego inteligencji otoczenia, koordynowanego przez Carlosa Ramosa, Juana Augusto i Daniela Shapiro, który ukaże się w numerze czasopisma IEEE Intelligent Systems z marca/kwietnia 2008 r. Istnieje wiele różnych koncepcji i technologii związanych z Ambient Intelligence. Ubiquitous Computing, Pervasive Computing, Embedded Systems i Context Awareness to najpopularniejsze z nich. Jednak te koncepcje różnią się od Ambient Intelligence. Koncepcja Ubiquitous Computing (UbiComp) została wprowadzona przez Marka Weisera podczas jego kadencji jako głównego technologa w Palo Alto Research Center (PARC). Ubiquitous Computing oznacza, że mamy dostęp do urządzeń obliczeniowych w dowolnym miejscu w sposób zintegrowany i spójny. Ubiquitous Computing był głównie napędzany przez społeczności naukowe zajmujące się urządzeniami komunikacyjnymi i komputerowymi, ale teraz obejmuje inne obszary badawcze. Ambient Intelligence różni się od Ubiquitous Computing, ponieważ czasami środowisko, w którym rozważa się Ambient Intelligence, jest po prostu lokalne. Inną różnicą jest to, że Ambient Intelligence kładzie większy nacisk na inteligencję niż Ubiquitous Computing. Jednak wszechobecność jest dziś rzeczywistą potrzebą, a systemy Ambient Intelligence biorą pod uwagę tę cechę. Koncepcja, która czasami jest postrzegana jako synonim Ubiquitous Computing, to Pervasive Computing. Według Teresy Dillon, Ubiquitous Computing najlepiej jest postrzegać jako podstawową strukturę, wbudowane systemy, sieci i wyświetlacze, które są niewidoczne i wszędzie, pozwalając nam na "podłączanie i odtwarzanie" urządzeń i narzędzi. Z drugiej strony, Pervasive Computing jest związane ze wszystkimi fizycznymi częściami naszego życia; telefonem komórkowym, komputerem przenośnym lub inteligentną kurtką. Embedded Systems oznacza, że urządzenia elektroniczne i komputerowe są osadzone w obecnych obiektach lub towarach. Obecnie towary, takie jak samochody, są wyposażone w mikroprocesory; to samo dotyczy pralek, lodówek i zabawek. Społeczność Embedded Systems jest bardziej napędzana przez społeczności naukowe zajmujące się elektroniką i automatyzacją. Obecne wysiłki zmierzają w kierunku włączenia urządzeń elektronicznych i komputerowych do najbardziej powszechnych i prostych przedmiotów, których używamy, takich jak meble lub lustra. Ambient Intelligence różni się od Embedded Systems, ponieważ urządzenia komputerowe mogą być wyraźnie widoczne w scenariuszach AmI. Istnieje jednak wyraźna tendencja do angażowania większej liczby systemów wbudowanych w Ambient Intelligence. Context Awareness oznacza, że system jest świadomy bieżącej sytuacji, z którą mamy do czynienia. Przykładem jest automatyczne wykrywanie bieżącej sytuacji w Centrum Kontroli. Czy mamy do czynienia z normalną sytuacją, czy też z sytuacją krytyczną, a nawet awarią? W tym Centrum Kontroli inteligentny procesor alarmowy będzie wykazywał różne wyniki w zależności od zidentyfikowanej sytuacji . Przemysł samochodowy inwestuje również w systemy Context Aware, takie jak wykrywanie niemal wypadków. Społeczność naukowa zajmująca się interakcją człowiek-komputer poświęca wiele uwagi Context Awareness. Context Awareness jest jedną z najbardziej pożądanych koncepcji do uwzględnienia w Ambient Intelligence, identyfikacja kontekstu jest ważna dla podjęcia decyzji o działaniu w sposób inteligentny. Istnieją różne poglądy na temat znaczenia innych koncepcji i technologii w dziedzinie Ambient Intelligence. Zwykle te różnice wynikają z podstawowej społeczności naukowej autorów. ISTAG widzi wymagania dotyczące badań technologicznych z różnych punktów widzenia (komponenty, integracja, system i użytkownik/osoba). W (ISTAG, 2003) wymienione są następujące komponenty otoczenia: inteligentne materiały; technologie MEMS i czujników; systemy wbudowane; wszechobecna komunikacja; technologia urządzeń wejścia/wyjścia; oprogramowanie adaptacyjne. W tym samym dokumencie ISTAG odnosi się do następujących komponentów inteligencji: zarządzanie i obsługa mediów; naturalna interakcja; inteligencja obliczeniowa; świadomość kontekstu; i obliczenia emocjonalne. Ostatnio inteligencja otoczenia otrzymuje znaczną uwagę ze strony społeczności sztucznej inteligencji. Możemy odnieść się do warsztatów poświęconych inteligencji otoczenia, zorganizowanych przez Juana Augusto i Daniela Shapiro na ECAI'2006 (Europejskiej Konferencji na temat Sztucznej Inteligencji) i IJCAI'2007 (Międzynarodowej Wspólnej Konferencji na temat Sztucznej Inteligencji), a także do numeru specjalnego poświęconego inteligencji otoczenia, koordynowanego przez Carlosa Ramosa, Juana Augusto i Daniela Shapiro, który ukaże się w numerze czasopisma IEEE Intelligent Systems z marca/kwietnia 2008 r.
PROTOTYPY I SYSTEMY INTELIGENTNEJ OTOCZENIA
Tutaj przeanalizujemy kilka przykładów prototypów i systemów inteligencji otoczenia, podzielonych ze względu na obszar zastosowań.
AmI at Home
Domotics to skonsolidowany obszar działalności. Po pierwszych doświadczeniach z Domotics w domach pojawił się trend nawiązywania do koncepcji Inteligentnego Domu. Jednak Domotics jest zbyt skoncentrowany na automatyce, dając użytkownikowi możliwość kontrolowania urządzeń domowych z dowolnego miejsca. Nadal jesteśmy daleko od prawdziwej Inteligencji Otoczenia w domach, przynajmniej na poziomie komercyjnym. W Wichert, Hellschimidt, 2006, znajduje się interesujący przykład w celach projektu EMBASSI, kobieta gestem nakazuje telewizorowi rozjaśnić, jednak telewizor jest już na najjaśniejszym poziomie, więc światła zmniejszają poziom, a okna się zamykają, pokazując przykład świadomości kontekstu w otoczeniu. Kilka organizacji przeprowadza eksperymenty w celu osiągnięcia koncepcji Inteligentnego Domu. Niektóre przykłady to HomeLab firmy Philips, MIT House_n, Georgia Tech Aware Home, Microsoft Concept Home i e2 Home firm Electrolux i Ericsson. AmI w pojazdach i transporcie Od czasu pierwszych doświadczeń z NAVLAB 1 (Thorpe, Herbert, Kanade, Shafer, 1988) Carnegie Mellon University opracowało kilka prototypów do autonomicznej jazdy i pomocy pojazdom. Ostatni z nich, NAVLAB 11, to autonomiczny Jeep. Większość firm z branży samochodowej prowadzi badania w obszarze inteligentnych pojazdów do różnych zadań, takich jak pomoc w parkowaniu lub wykrywanie kolizji. Innym przykładem zastosowania AmI jest powiązanie z transportem, a mianowicie w powiązaniu z inteligentnymi systemami transportowymi (ITS). Wspólny program ITS Departamentu Transportu USA zidentyfikował kilka obszarów zastosowań, a mianowicie: zarządzanie arteriami; zarządzanie autostradami; zarządzanie tranzytem; zarządzanie incydentami; zarządzanie pojawianiem się; płatności elektroniczne; informacje dla podróżnych; zarządzanie informacją; zapobieganie wypadkom i bezpieczeństwo; operacje drogowe i zarządzanie nimi; zarządzanie pogodą na drogach; operacje pojazdów komercyjnych; i transport intermodalny. We wszystkich tych obszarach zastosowań można stosować Ambient Intelligence.
AmI w opiece zdrowotnej i osobach starszych
Kilka badań wskazuje na starzenie się populacji w ciągu najbliższych dekad. Chociaż jest to dobry wynik wzrostu oczekiwanej długości życia, to również wiąże się z pewnymi problemami. Odsetek populacji z problemami zdrowotnymi wzrośnie i będzie bardzo trudno aby szpitale utrzymały wszystkich pacjentów. Nasze społeczeństwo stoi przed odpowiedzialnością za opiekę nad tymi ludźmi w najlepszy możliwy sposób społeczny i ekonomiczny. Istnieje więc wyraźne zainteresowanie stworzeniem urządzeń i środowisk Ambient Intelligence, umożliwiających śledzenie pacjentów w ich własnych domach lub w trakcie ich codziennego życia. Urządzenia wspomagające kontrolę medyczną mogą być osadzone w ubraniach, takich jak koszulki, zbierając informacje o parametrach życiowych z czujników (np. ciśnienie krwi, temperatura). Pacjenci będą monitorowani z dużej odległości. Otaczające środowisko, na przykład dom pacjenta, może być świadome wyników z danych klinicznych, a nawet wykonywać połączenia alarmowe w celu wezwania pogotowia ratunkowego. Na przykład możemy odnieść się do systemu IST Vivago (IST International Security Technology Oy, Helsinki, Finlandia), aktywnego systemu alarmów społecznych, który łączy inteligentne alarmy społeczne z ciągłym zdalnym monitorowaniem profilu aktywności użytkownika .
AmI w turystyce i dziedzictwie kulturowym
Turystyka i dziedzictwo kulturowe to dobre obszary zastosowań dla inteligencji otoczenia. Turystyka to rozwijająca się branża. W przeszłości turyści byli zadowoleni z wstępnie zdefiniowanych wycieczek, równych dla wszystkich ludzi. Istnieje jednak trend w dostosowywaniu i ta sama wycieczka może być pomyślana tak, aby dostosować się do turystów zgodnie z ich preferencjami. Przykładem takiego doświadczenia jest immersyjny post wycieczkowy. MEGA to przyjazny użytkownikowi wirtualny przewodnik, który pomaga odwiedzającym Parco Archeologico della Valle del Temple w Agrigento, obszarze archeologicznym ze starożytnymi greckimi świątyniami w Agrigento, położonym na Sycylii, we Włoszech. DALICA została wykorzystana do skonstruowania i aktualizacji profilu użytkownika odwiedzających Villa Adriana w Tivoli, niedaleko Rzymu, we Włoszech
AmI w pracy
Człowiek spędza dużo czasu w miejscach pracy, takich jak biura, sale konferencyjne, zakłady produkcyjne, centra sterowania. SPARSE to projekt pierwotnie stworzony w celu pomocy operatorom centrów sterowania systemami energetycznymi w diagnozowaniu i przywracaniu po incydentach. Jest to dobry przykład świadomości kontekstu, ponieważ opracowany system jest świadomy bieżącej sytuacji, działając w różny sposób w zależności od normalnej lub krytycznej sytuacji systemu energetycznego. System ten ewoluuje w kierunku ram inteligencji otoczenia stosowanych w centrach sterowania. Podejmowanie decyzji jest jedną z najważniejszych czynności człowieka. Obecnie decyzje oznaczają rozważenie wielu różnych punktów widzenia, więc decyzje są powszechnie podejmowane przez formalne lub nieformalne grupy osób. Grupy wymieniają się pomysłami lub angażują się w proces argumentacji i kontrargumentacji, negocjują, współpracują, współdziałają, a nawet omawiają techniki i/lub metodologie rozwiązywania problemów. Podejmowanie decyzji grupowych to aktywność społeczna, w której dyskusja i wyniki uwzględniają połączenie aspektów racjonalnych i emocjonalnych. ArgEmotionAgents to projekt w obszarze zastosowania AmbientIntelligence w argumentacji grupowej i wspomaganiu decyzji, uwzględniający aspekty emocjonalne i działający w Laboratory of Ambient Intelligence for Decision Support (LAID),, swego rodzaju Intelligent Decision Room. Ta praca ma również część obejmującą wsparcie wszechobecności. AmI w sporcie Sporty obejmują sportowców na wysokim poziomie i wielu innych praktyków. Wiele sportów uprawia się bez pomocy powiązanych urządzeń, co otwiera tutaj wyraźną okazję dla Ambient Intelligence do tworzenia urządzeń i środowisk wspomagających sport. FlyMaster NAV+ to asystent pilota na pokładzie samolotu (np. szybowanie, paralotniarstwo), wykorzystujący moduł FlyMaster F1 z dostępem do GPS i informacji sensorycznych. FlyMaster Avionics S.A., spółka spin-off, została utworzona w celu komercjalizacji tych produktów
PLATFORMY AMBIENT INTELLIGENCE
Niektóre firmy i instytucje akademickie inwestują w tworzenie platform generujących Ambient Intelligence. Projekt Endeavour jest rozwijany przez California University w Berkeley . Celem projektu jest określenie, zaprojektowanie i wdrożenie prototypów na skalę planety, samoorganizujących się i obejmujących adaptacyjne "Information Utility". Oxygen umożliwia wszechobecne obliczenia zorientowane na człowieka poprzez połączenie określonych technologii użytkownika i systemu. Projekt ten zapewnia technologie mowy i wizji, które umożliwiają nam komunikowanie się z Oxygen tak, jakbyśmy wchodzili w interakcję z inną osobą, oszczędzając wiele czasu i wysiłku. Projekt Portolano został opracowany na University of Washington i ma na celu stworzenie poligonu doświadczalnego do badań nad powstającą dziedziną niewidzialnych obliczeń. Niewidzialne obliczenia są możliwe dzięki urządzeniom tak wysoce zoptymalizowanym do konkretnych zadań, że dostosowują się do świata i wymagają od użytkowników niewielkiej wiedzy technicznej. Projekt EasyLiving Microsoft Research Vision Group odpowiada prototypowej architekturze i powiązanym technologiom do budowania inteligentnych środowisk. Celem EasyLiving jest ułatwienie interakcji ludzi z innymi ludźmi, z komputerem i z urządzeniami
TRENDY PRZYSZŁOŚCI
Ambient Intelligence zajmuje się futurystyczną koncepcją naszego życia. Większość praktycznych doświadczeń dotyczących Ambient Intelligence jest nadal w bardzo początkowej fazie, ze względu na niedawne pojawienie się tej koncepcji. Obecnie nie jest jasne, jaki jest podział między komputerem a
środowiskami. Jednak dla nowych pokoleń rzeczy będą bardziej przejrzyste, a środowiska z Ambient Intelligence będą szerzej akceptowane. W obszarze transportu AmI obejmie kilka aspektów. Pierwszy będzie związany z samym pojazdem. Kilka funkcji zacznie być dostępnych, takich jak automatyczna identyfikacja sytuacji (np. identyfikacja przedkolizyjna, identyfikacja warunków kierowcy). Inne aspekty będą związane z informacjami o ruchu drogowym. Obecnie urządzenia GPS są uogólnione, ale zajmują się informacjami statycznymi. Łączenie warunków ruchu drogowego online umożliwi kierowcy unikanie dróg z wypadkami. Technologia daje dobre kroki w kierunku automatycznej jazdy pojazdem. Jednak w niedalekiej przyszłości opracowany system będzie postrzegany bardziej jako asystenci kierowcy pomimo autonomicznych systemów jazdy. Innym obszarem, w którym AmI doświadczy silnego rozwoju, będzie obszar opieki zdrowotnej, zwłaszcza w opiece nad osobami starszymi. Pacjenci otrzymają to wsparcie, aby umożliwić bardziej autonomiczne życie w swoich domach. Jednak automatyczne pozyskiwanie sygnałów życiowych (np. ciśnienia krwi, temperatury) umożliwi automatyczne wykonywanie połączeń alarmowych, gdy zdrowie pacjenta będzie w znacznym stopniu zagrożone. Monitorowanie osoby będzie również wykonywane w jej/jego domu, próbując wykryć różnice w oczekiwanych sytuacjach i nawykach. Wsparcie domowe pozwoli osiągnąć normalne życie osobiste i rodzinne. Inteligentne domy staną się rzeczywistością. Mieszkańcy domów będą zwracać mniejszą uwagę na normalne aspekty zarządzania domem, na przykład na to, ile butelek czerwonego wina jest dostępnych na tygodniowe posiłki lub czy wszystkie składniki na ciasto są dostępne. Oczekuje się również AmI do wsparcia pracy. Systemy wspomagania decyzji będą zorientowane na środowiska pracy. Będzie to jasne w biurach, salach konferencyjnych, centrach obsługi telefonicznej, centrach kontroli i zakładach.
WNIOSEK
W tym artykule przedstawiono stan wiedzy w zakresie dziedziny inteligencji otoczenia. Po zapoznaniu się z historią koncepcji ustanowiliśmy pewne definicje powiązanych koncepcji i zilustrowaliśmy je kilkoma przykładami. Istnieje długa droga do przebycia, aby osiągnąć koncepcję inteligencji otoczenia, jednak w przyszłości koncepcja ta będzie określana jako jeden z kamieni milowych w rozwoju sztucznej inteligencji.
Sztuczna inteligencja i edukacja
WSTĘP
Rządy i instytucje stają w obliczu nowych wymagań szybko zmieniającego się społeczeństwa. Spośród wielu istotnych trendów należy wziąć pod uwagę kilka faktów : (1) wzrost liczby i rodzaju studentów; oraz (2) ograniczenia narzucone przez koszty edukacji i harmonogramy kursów. W przypadku pierwszego, potrzeba ciągłej aktualizacji wiedzy i kompetencji w zmieniającym się środowisku pracy wymaga rozwiązań uczenia się przez całe życie. Coraz większa liczba młodych dorosłych wraca do szkół, aby ukończyć studia podyplomowe lub uczestniczyć w programach podyplomowych, aby uzyskać specjalizację w określonej dziedzinie. W przypadku drugiego, ze względu na pojawienie się nowych typów studentów, pojawiają się ograniczenia budżetowe i konflikty w harmonogramie. Na przykład pracownicy i imigranci to istotne grupy, dla których koszty edukacji i harmonogramy niezgodne z pracą mogą być kluczowym czynnikiem decydującym o zapisaniu się na kurs lub rezygnacji z programu po zainwestowaniu w niego czasu i wysiłku. Aby rozwiązać potrzeby wynikające z tego kontekstu społecznego, należy zaproponować nowe podejścia edukacyjne: (1) ulepszyć i rozszerzyć kursy nauki online, co obniżyłoby koszty dla studentów i umożliwiło pokrycie potrzeb edukacyjnych większej liczby studentów oraz (2) zautomatyzować procesy uczenia się, a następnie obniżyć koszty dla nauczycieli i zapewnić bardziej spersonalizowane doświadczenie edukacyjne w dowolnym czasie i miejscu. W wyniku tego kontekstu w ostatniej dekadzie zaobserwowano rosnące zainteresowanie zastosowaniem technologii komputerowych w dziedzinie edukacji. W związku z tym paradygmaty dziedziny sztucznej inteligencji (AI) przyciągają szczególną uwagę, aby rozwiązać problemy wynikające z wprowadzenia komputerów jako zasobów pomocniczych różnych strategii uczenia się. W tym artykule dokonujemy przeglądu stanu wiedzy w zakresie stosowania technik sztucznej inteligencji w dziedzinie edukacji, koncentrując się na (1) najpopularniejszych narzędziach edukacyjnych opartych na AI oraz (2) najbardziej odpowiednich technikach AI stosowanych w rozwoju inteligentnych systemów edukacyjnych.
PRZYKŁADY NARZĘDZI EDUKACYJNYCH OPARTYCH NA AI
Dziedzina sztucznej inteligencji może wnieść interesujące rozwiązania do potrzeb domeny edukacyjnej . Poniżej przedstawiono typy systemów, które można zbudować w oparciu o techniki AI.
Inteligentne Systemy Tutoringu
Inteligentne Systemy Tutoringu to aplikacje, które zapewniają spersonalizowaną/adaptacyjną naukę bez interwencji nauczycieli. Składają się z trzech głównych komponentów: (1) wiedzy o treściach edukacyjnych, (2) wiedzy o uczniu i (3) wiedzy o procedurach i metodologiach uczenia się. Systemy te obiecują radykalnie zmienić naszą wizję nauki online. W przeciwieństwie do aplikacji e-learningowych opartych na hipertekście, które zapewniają uczniom pewną liczbę możliwości wyszukania prawidłowej odpowiedzi przed jej wyświetleniem, inteligentne systemy tutoringu działają jak trenerzy nie tylko po wprowadzeniu odpowiedzi, ale także oferują sugestie, gdy uczniowie mają wątpliwości lub są zablokowani w trakcie rozwiązywania problemu. W ten sposób pomoc kieruje procesem uczenia się, a nie tylko mówi, co jest poprawne, a co nie. Istnieje wiele przykładów inteligentnych systemów tutoringu, niektóre z nich opracowano na uniwersytetach jako projekty badawcze, a inne stworzono z myślą o celach biznesowych. Wśród pierwszych, popularnym przykładem są systemy Andes , opracowane pod kierownictwem Kurta VanLehna z University of Pittsburg. System odpowiada za kierowanie uczniami, gdy próbują oni rozwiązywać różne zestawy problemów i ćwiczeń. Gdy uczeń prosi o pomoc w trakcie wykonywania zadania, system albo udziela wskazówek, aby przejść dalej w kierunku rozwiązania, albo wskazuje, co było nie tak na jakimś wcześniejszym etapie. Andes został pomyślnie oceniony w ciągu 5 lat w Naval Academy of the United States i można go pobrać bezpłatnie. Innym istotnym systemem jest Cognitive Tutor, jest to kompleksowy program nauczania matematyki w szkołach średnich i program korepetycji oparty na komputerze opracowany przez Johna R. Andersona, profesora na Carnegie Mellon University. Cognitive Tutor jest przykładem tego, jak prototypy badawcze mogą ewoluować w rozwiązania komercyjne, jak to jest obecnie stosowane w 1500 szkołach w Stanach Zjednoczonych. Z punktu widzenia biznesu Read-On! jest prezentowany jako produkt, który uczy umiejętności czytania ze zrozumieniem dla dorosłych. Analizuje i diagnozuje konkretne niedobory i problemy każdego ucznia, a następnie dostosowuje proces uczenia się na podstawie tych cech. Zawiera narzędzie autorskie, które pozwala projektantom kursów dostosowywać treści kursów do różnych profili uczniów w szybki i elastyczny sposób.
Systemy automatycznej oceny
Systemy automatycznej oceny koncentrują się głównie na ocenie mocnych i słabych stron uczniów w różnych działaniach edukacyjnych za pomocą testów oceniających. W ten sposób systemy te nie tylko wykonują automatyczną korektę testu, ale także automatycznie uzyskują przydatne informacje o kompetencjach i umiejętnościach uzyskanych przez uczniów w trakcie procesu edukacyjnego. Wśród automatycznych systemów oceniania możemy wyróżnić ToL (Test On Line), z którego korzystają studenci fizyki na Politechnice w Mediolanie. System składa się z bazy danych testów, algorytmu doboru pytań i mechanizmu automatycznej oceny testów, który może być dodatkowo konfigurowany przez nauczycieli. CELLA (Comprehensive English Language Learning Assesment) to kolejny system, który ocenia kompetencje studentów w zakresie używania i rozumienia języka angielskiego. Aplikacja pokazuje postępy studentów i określa ich biegłość i stopień kompetencji w zakresie używania języków obcych. Jeśli chodzi o aplikacje komercyjne, Intellimetric to system internetowy, który umożliwia studentom przesyłanie swoich prac online. W ciągu kilku sekund wspomagany przez sztuczną inteligencję moduł oceniania automatycznie podaje ocenę pracy. Firma twierdzi, że niezawodność wynosi 99%, co oznacza, że w 99 procentach przypadków wyniki wyszukiwarki pokrywają się z wynikami podanymi przez nauczycieli.
Wspomagane komputerowo uczenie się współpracy
Środowiska wspomaganego komputerowo uczenia się współpracy mają na celu ułatwienie procesu uczenia się, zapewniając uczniom zarówno kontekst, jak i narzędzia do interakcji i pracy w sposób współpracy z kolegami z klasy. W systemach opartych na inteligencji współpraca jest zwykle realizowana przy pomocy agentów oprogramowania odpowiedzialnych za pośredniczenie i wspieranie interakcji uczniów w celu osiągnięcia proponowanych celów nauczania. Prototypy badawcze są odpowiednimi poligonami doświadczalnymi do udowadniania nowych pomysłów i koncepcji, aby zapewnić najlepsze strategie współpracy. System DEGREE, na przykład, umożliwia scharakteryzowanie zachowań grupowych, jak również indywidualnych zachowań osób je tworzących, na podstawie zestawu atrybutów lub tagów. Agent mediator wykorzystuje te atrybuty, które są wprowadzane przez uczniów, w celu zapewnienia rekomendacji i sugestii w celu poprawy interakcji wewnątrz każdej grupy . W dziedzinie biznesu istnieje wiele rozwiązań, chociaż nie oferują one inteligentnej mediacji ułatwiającej interakcje współpracy. System DEBBIE (DePauw Electronic Blackboard for Interactive Education) jest jednym z najpopularniejszych. Został pierwotnie opracowany na początku 2000 roku na Uniwersytecie DePauw, a później zarządzany przez firmę DyKnow, która została specjalnie stworzona, aby osiągać zyski z DEBBIE . Technologia, którą obecnie oferuje DyKnow, pozwala zarówno nauczycielom, jak i uczniom na natychmiastowe dzielenie się informacjami i pomysłami. Ostatecznym celem jest wspieranie zadań uczniów w klasie poprzez wyeliminowanie potrzeby wykonywania prostych zadań, takich jak na przykład tworzenie kopii zapasowych prezentacji nauczyciela. Uczniowie mogliby zatem bardziej skupić się na zrozumieniu, a także analizowaniu koncepcji przedstawionych przez nauczyciela.
Nauka oparta na grach
Nauka oparta na grach poważnych, termin ukuty w celu rozróżnienia gier zorientowanych na naukę, stosowanych w edukacji, od gier zorientowanych wyłącznie na rozrywkę, zajmuje się wykorzystaniem siły motywacyjnej i atrakcyjności gier w dziedzinie edukacji w celu poprawy satysfakcji i wyników uczniów podczas zdobywania nowej wiedzy i umiejętności. Ten rodzaj nauki pozwala na prowadzenie działań w złożonych środowiskach edukacyjnych, których nie dałoby się wdrożyć ze względu na ograniczenia budżetowe, czasowe, infrastrukturalne i bezpieczeństwa przy użyciu tradycyjnych zasobów. NetAid to instytucja, która opracowuje gry, aby uczyć koncepcji obywatelstwa globalnego i uwrażliwiać na walkę z ubóstwem. Jedna z jej pierwszych gier, wydana w 2002 roku, zwana NetAid World Class, polega na przyjęciu tożsamości prawdziwego dziecka mieszkającego w Indiach i rozwiązaniu prawdziwych problemów, z którymi borykają się biedne dzieci w tym regionie. W 2003 roku gra była używana przez 40 000 uczniów w różnych szkołach w Stanach Zjednoczonych. W biznesie i rozrywce istnieje wiele gier, które można wykorzystać do osiągnięcia celów edukacyjnych. Wśród najpopularniejszych jest Brain Training of Nintendo (Brain Training, 2007), który rzuca użytkownikowi wyzwanie poprawy jego kondycji umysłowej poprzez wykonywanie ćwiczeń pamięciowych, rozumowania i matematycznych. Ostatecznym celem jest osiągnięcie optymalnego wieku mózgowego po regularnym treningu.
TECHNIKI AI W EDUKACJI
Inteligentne systemy edukacyjne omówione powyżej opierają się na różnorodnych technikach sztucznej inteligencji. Najczęściej stosowane w dziedzinie edukacji to: (1) mechanizmy personalizacji oparte na modelach uczniów i grup, (2) inteligentni agenci i systemy oparte na agentach oraz (3) ontologie i techniki sieci semantycznej.
Mechanizmy personalizacji
Techniki personalizacji, które są podstawą inteligentnych systemów nauczania, obejmują tworzenie i wykorzystywanie modeli uczniów. Mówiąc ogólnie, modele te implikują konstrukcję jakościowej reprezentacji zachowań uczniów w kategoriach istniejącej wiedzy tła na temat domeny. Te reprezentacje mogą być dalej wykorzystywane w inteligentnych systemach nauczania, inteligentnych środowiskach edukacyjnych i do opracowywania autonomicznych inteligentnych agentów, którzy mogą współpracować z uczniami-ludźmi w trakcie procesu uczenia się. Wprowadzenie technik uczenia maszynowego ułatwia aktualizację i rozszerzanie pierwszych wersji modeli studentów w celu dostosowania ich do ewolucji każdego studenta, a także możliwych zmian i modyfikacji treści i działań edukacyjnych. Najpopularniejszymi technikami modelowania studentów są : modele nakładkowe i modele sieci bayesowskich. Pierwsza metoda polega na traktowaniu modelu studenta jako podzbioru wiedzy eksperta w dziedzinie, w której odbywa się nauka. W rzeczywistości stopień nauki jest mierzony w kategoriach porównania wiedzy nabytej i reprezentowanej w modelu studenta z tłem początkowo przechowywanym w modelu eksperta. Druga metoda zajmuje się reprezentacją procesu uczenia się jako sieci stanów wiedzy. Po zdefiniowaniu model powinien wnioskować, na podstawie interakcji tutor-uczeń, prawdopodobieństwo, że student znajdzie się w określonym stanie.
Inteligentni agenci i systemy oparte na agentach
Agenci oprogramowania są uważani za byty oprogramowania, takie jak programy oprogramowania lub roboty, które prezentują, w różnym stopniu, trzy główne atrybuty: autonomię, współpracę i uczenie się. Autonomia odnosi się do zasady, że agent może działać samodzielnie (działając i decydując o własnej reprezentacji świata). Współpraca odnosi się do zdolności do interakcji z innymi agentami za pośrednictwem pewnego języka komunikacji. Wreszcie, uczenie się jest niezbędne do reagowania lub interakcji ze środowiskiem zewnętrznym. Zespoły inteligentnych agentów budują systemy wieloagentowe (MAS). W tego typu systemach każdy agent ma albo niekompletne informacje, albo ograniczone możliwości rozwiązania danego problemu. Innym ważnym aspektem jest brak scentralizowanej kontroli globalnej; dlatego dane są rozproszone w całym systemie, a obliczenia są asynchroniczne (Sycara, 1998). Wiele ważnych zadań może być wykonywanych przez inteligentnych agentów w kontekście systemów edukacyjnych i uczących się : monitorowanie danych wejściowych, wyników i wyników aktywności wytworzonych przez uczniów; weryfikacja terminów podczas oddawania prac domowych i ćwiczeń; automatyczne odpowiadanie na pytania uczniów; automatyczne ocenianie testów i ankiet.
Ontologie i techniki sieci semantycznej
Ontologie mają na celu uchwycenie i przedstawienie wiedzy konsensualnej w sposób ogólny oraz mogą być ponownie wykorzystywane i udostępniane w aplikacjach oprogramowania . Ontologia składa się z pojęć lub klas i ich atrybutów, relacji między pojęciami, właściwości tych relacji oraz aksjomatów i reguł, które jawnie reprezentują wiedzę z określonej dziedziny. W dziedzinie edukacji zaproponowano kilka ontologii: (1) w celu opisania treści nauczania dokumentów technicznych , (2) w celu modelowania elementów wymaganych do projektowania, analizy i oceny interakcji między uczniami w uczeniu kooperatywnym wspomaganym komputerowo , (3) w celu określenia wiedzy potrzebnej do zdefiniowania nowych scenariuszy uczenia się kooperatywnego , (4) w celu sformalizowania semantyki obiektów nauczania opartych na standardach metadanych oraz (5) w celu opisania semantyki języków projektowania nauczania
PRZYSZŁE TRENDY
Następna generacja adaptacyjnych środowisk zintegruje agentów pedagogicznych, wzbogaconych o techniki eksploracji danych i uczenia maszynowego, zdolnych do zapewnienia diagnozy poznawczej uczniów, która pomoże określić stan procesu uczenia się, a następnie zoptymalizować wybór spersonalizowanych projektów uczenia się. Ponadto ulepszone modele uczniów, osób ułatwiających, zadań i procesów rozwiązywania problemów, w połączeniu z wykorzystaniem ontologii i silników rozumowania, ułatwią wykonywanie działań edukacyjnych na platformach online lub w tradycyjnych warunkach klasowych. Badania w tej dziedzinie są bardzo aktywne i stawiają sobie ambitne cele. W niektórych dekadach można by pomarzyć o środowiskach science fiction, w których uczniowie mieliby interfejsy mózgowe do bezpośredniej interakcji z inteligentnym asystentem, który pełniłby rolę nauczyciela z bezpośrednim połączeniem z obszarami mózgu odpowiedzialnymi za naukę.
WNIOSEK
W tym artykule dokonaliśmy przeglądu najnowocześniejszych rozwiązań w zakresie stosowania technik sztucznej inteligencji w dziedzinie edukacji. Podejścia AI wydają się obiecujące w zakresie poprawy jakości procesu uczenia się, a następnie zaspokojenia nowych wymagań szybko zmieniającego się społeczeństwa. Obecne systemy oparte na sztucznej inteligencji, takie jak inteligentne systemy nauczania, wspomagane komputerowo uczenie się grupowe i gry edukacyjne, udowodniły już możliwości stosowania technik sztucznej inteligencji. Przyszłe aplikacje ułatwią zarówno spersonalizowane style uczenia się, jak i pomogą nauczycielom i uczniom w tradycyjnych warunkach klasowych.
Sztuczna inteligencja i stabilność falochronu gruzowego
WSTĘP
Falochrony to konstrukcje przybrzeżne, które mają chronić basen portowy przed falami. Istnieją dwa główne typy: falochrony z gruzu kamiennego, składające się z różnych warstw kamieni lub kawałków betonu o różnych rozmiarach (ciężarach), tworzących porowaty kopiec; oraz falochrony pionowe, nieprzepuszczalne i monolityczne, zwykle składające się z betonowych kesonów. Niniejszy artykuł dotyczy falochronów z gruzu kamiennego. Typowy falochron z gruzu kamiennego składa się z warstwy pancernej, warstwy filtracyjnej i rdzenia. Aby falochron był stabilny, jednostki warstwy pancernej (kamienie lub kawałki betonu) nie mogą zostać usunięte przez działanie fal. Stabilność jest zasadniczo osiągana przez ciężar. Niektóre rodzaje elementów betonowych są w stanie osiągnąć wysoki stopień zazębienia, co przyczynia się do stabilności poprzez utrudnianie usuwania pojedynczej jednostki. Siły, które jednostka pancerna musi wytrzymać pod wpływem działania fal, zależą od hydrodynamiki na stoku falochronu, która jest niezwykle złożona ze względu na łamanie się fal i porowatą naturę konstrukcji. Do tej pory nie udało się uzyskać szczegółowego opisu przepływu i nie jest jasne, czy uda się to zrobić w przyszłości, biorąc pod uwagę występujące zjawiska turbulentne. Dlatego też natychmiastowa siła wywierana na jednostkę pancerną nie jest, przynajmniej na razie, możliwa do określenia za pomocą numerycznego modelu przepływu. Z tego powodu formuły empiryczne są stosowane w projektowaniu kopców gruzowych, skalibrowane na podstawie testów laboratoryjnych konstrukcji modelowych. Jednak formuły te nie mogą uwzględniać wszystkich aspektów wpływających na stabilność, głównie dlatego, że inherentna złożoność problemu nie nadaje się do prostego rozwiązania. W związku z tym formuły empiryczne są stosowane jako narzędzie wstępnego projektowania, a testy modelu fizycznego w korycie falowym konkretnego projektu w stosownych warunkach klimatu morskiego są rygorystyczne, z wyjątkiem mniejszych konstrukcji. Testy modelu fizycznego naturalnie integrują całą złożoność problemu. Ich wadą jest to, że są drogie i czasochłonne. W tym artykule sztuczne sieci neuronowe są trenowane i testowane za pomocą wyników testów stabilności przeprowadzonych na modelowym falochronie. Wykazano, że odtwarzają one bardzo dokładnie zachowanie modelu fizycznego w kanale falowym. Tak więc model ANN, jeśli jest trenowany i testowany z wystarczającą ilością danych, może być używany zamiast testów modelu fizycznego. Wirtualne laboratorium tego rodzaju pozwoli zaoszczędzić czas i pieniądze w porównaniu z konwencjonalną procedurą.
TŁO
Sztuczne sieci neuronowe są używane w zastosowaniach inżynierii lądowej od jakiegoś czasu, szczególnie w hydrologii ; niektóre zagadnienia inżynierii oceanicznej zostały również podjęte. Stabilność falochronu z gruzu kamiennego jest badana w pionierskiej pracy Mase , skupiającej się na konkretnym wzorze stabilności. Medina i inni trenują i testują sztuczną sieć neuronową przy użyciu danych dotyczących stabilności z sześciu laboratoriów. Dane wejściowe to względna wysokość fali, liczba Iribarrena i zmienna reprezentująca laboratorium. Kim i Park (2005) porównują różne modele ANN w analizie obracającej się wokół jednego empirycznego wzoru stabilności, podobnie jak Mase. Yagci i inni stosują różne rodzaje sieci neuronowych i logiki rozmytej, charakteryzując fale na podstawie ich wysokości, okresu i stromości.
MODEL FIZYCZNY I MODEL ANN
Sztuczne sieci neuronowe zostały wytrenowane i przetestowane na podstawie testów laboratoryjnych przeprowadzonych w korycie falowym laboratorium CITEEC na Uniwersytecie La Coru?a. Sekcja koryta ma 4 m szerokości i 0,8 m wysokości, a długość 33 m . Fale są generowane za pomocą łopatki tłokowej, sterowanej przez system aktywnej absorpcji (AWACS), który zapewnia, że fale odbite od modelu są pochłaniane przez łopatkę. Model przedstawia typowy falochron z trzech warstw gruzowiska na głębokości 15 m, zwieńczony na +9,00 m, w skali 1:30. Jego nachylenia wynoszą odpowiednio 1:1,50 i 1:1,25 po stronie morskiej i zawietrznej. Warstwa pancerza składa się z kolei z dwóch warstw kamieni o wadze W=69 g ±10%; te w górnej warstwie są pomalowane na niebiesko, czerwono i czarno zgodnie z poziomymi pasami, podczas gdy te w dolnej warstwie są pomalowane na biało, aby łatwo zidentyfikować po teście uszkodzone obszary, tj. obszary, w których górna warstwa została usunięta. Warstwa filtrująca składa się ze żwiru o medianie wielkości D50 = 15,11 mm i grubości 4 cm. Wreszcie rdzeń składa się z drobniejszego żwiru o D50 = 6,95 mm, D15 = 5,45 mm i D85 = 8,73 mm i porowatości n = 42%. Gęstość kamieni i żwiru wynosi ?r = 2700 kg/m3. Fale mierzono na sześciu różnych stacjach wzdłuż osi podłużnej lub osi x kanału. Przy początku x znajdującym się w położeniu spoczynkowym łopatki falowej, pierwszy falomierz, S1, znajdował się na x = 7,98 m. Grupa trzech czujników, S2, S3 i S4, została użyta do oddzielenia fali padającej i odbitej. Centralny falomierz, S3, został umieszczony na x=12,28 m, podczas gdy położenie pozostałych, S2 i S4, było zmieniane w zależności od okresu generowania fali każdego testu (Tabela 1). Inny falomierz, S5, został umieszczony 25 cm przed stopą falochronu modelowego, na x=13,47 m i 16 cm na prawo (patrząc z łopatki falochronu) od środkowej linii kanału, aby nie zakłócać nagrywania wideo testów. Na koniec falomierz (S6) został umieszczony na zawietrznej falochronu modelowego, na x=18,09 m. W testach stabilności użyto zarówno fal regularnych, jak i nieregularnych. Niniejszy artykuł dotyczy ośmiu testów fal regularnych, przeprowadzonych z czterema różnymi okresami fal. Głębokość wody w kanale była utrzymywana na stałym poziomie przez cały czas trwania testów (h=0,5 m). Każdy test składał się z szeregu przebiegów falowych o stałej wartości okresu fali T, powiązanej z liczbą falową k za pomocą
T = 2π[gktanh(kh)]1/2
gdzie g jest przyspieszeniem grawitacyjnym. Każdy przebieg fal składał się z 200 fal. W pierwszym przebiegu każdego testu wygenerowane fale miały wysokość modelu H=6 cm (odpowiadającą wysokości fali w prototypie Hp=1,80 m); w kolejnych przebiegach wysokość fali zwiększano o 1 cm (7 cm, 8 cm, 9 cm itd.), tak aby falochron modelowy był poddawany coraz bardziej energicznym falom. Cztery poziomy uszkodzeń zostały użyte do scharakteryzowania sytuacji stabilności falochronu modelowego po każdym przebiegu fali:
(0) Brak uszkodzeń. Żadne jednostki pancerne nie zostały przesunięte ze swoich pozycji.
(1) Inicjacja uszkodzeń. Pięć lub więcej jednostek pancernych zostało przemieszczonych.
(2) Uszkodzenia Iribarren. Przemieszczone jednostki pierwszej (zewnętrznej) warstwy pancerza pozostawiły odkryty obszar drugiej warstwy wystarczająco duży, aby fale mogły usunąć kamień.
(3) Rozpoczęcie zniszczenia. Pierwsza jednostka drugiej warstwy pancerza została usunięta przez działanie fal.
W miarę zwiększania wysokości fali w trakcie testu poziom uszkodzeń również wzrósł z początkowego "braku uszkodzeń" do "rozpoczęcia uszkodzenia", "uszkodzenia Iribarren" i ostatecznie "rozpoczęcia zniszczenia", w którym to momencie test został zakończony, a model przebudowany na potrzeby kolejnego testu. Liczba przebiegów fal w teście wahała się od 10 do 14. Powyższe poziomy uszkodzeń zapewniają dobrą półilościową ocenę stanu stabilności falochronu. Jednak następujący bezwymiarowy parametr uszkodzenia jest bardziej odpowiedni dla modelu sztucznej sieci neuronowej:
S=nD50/(1-p)b
gdzie D50 jest medianą wielkości kamieni pancerza, p jest porowatością warstwy pancerza, b jest szerokością falochronu modelowego, a n jest liczbą jednostek przemieszczonych po każdym przejściu fali. W tym przypadku D50 = 2,95 cm, p = 0,40 i b = 50 cm. Wysokość fali padającej została bezwymiarowa za pomocą wysokości fali o zerowym uszkodzeniu formuły SPM (1984),
gdzie KD=4 to współczynnik stateczności, γw=1000 kg/m3 to gęstość wody (w testach laboratoryjnych zastosowano wodę słodką), a a to nachylenie falochronu. Przy tych wartościach H0 = 9,1 cm. Bezwymiarowa wysokość fali padającej jest podana przez
H* = H/H0
gdzie H oznacza wysokość fali padającej. Większość poprzednich zastosowań Sztucznych Sieci Neuronowych w Inżynierii Lądowej wykorzystuje wielowarstwowe sieci sprzężenia zwrotnego trenowane za pomocą algorytmu propagacji wstecznej, które również zostaną wykorzystane w tym badaniu; ich główną zaletą są ich zdolności generalizacyjne. Tak więc tego rodzaju sieci można użyć na przykład do przewidywania uszkodzeń pancerza, jakie model falochronu wytrzyma w określonych warunkach, nawet jeśli warunki te nie były dokładnie częścią zestawu danych, na którym trenowano sieć. Jednak parametry opisujące warunki (np. gr., wysokość fali i okres) muszą mieścić się w zakresach parametrów testów stabilności, na których trenowano sieć neuronową. W tym przypadku wyniki testów stabilności modelu falochronu z gruzowiska opisanego powyżej zostały wykorzystane do trenowania i testowania sztucznej sieci neuronowej. Osiem testów stabilności obejmowało 96 przebiegów fal. Dane wejściowe do sieci stanowiła bezwymiarowa wysokość fali (H*) i względna głębokość wody (kh) przebiegu fali, a dane wyjściowe - wynikowy bezwymiarowy parametr uszkodzenia (S). Dane z 49 przebiegów fal, odpowiadające czterem testom stabilności T20, T21, T22 i T23, zostały wykorzystane do trenowania sieci; podczas gdy dane z 46 przebiegów fal, odnoszące się do pozostałych czterech testów (T10, T11, T12 i T13) zostały wykorzystane do jej testowania. Ten rozkład danych zapewnił, że każdy z czterech okresów generowania fali był obecny zarówno w zestawach danych treningowych, jak i testowych. Najpierw sztuczna sieć neuronowa z 10 neuronami sigmoidalnymi w warstwie ukrytej i liniowej warstwie wyjściowej została wytrenowana i przetestowana 10 razy. Sieć neuronowa została wytrenowana za pomocą metody regularizacji bayesowskiej , o której wiadomo, że jest skuteczna w unikaniu nadmiernego dopasowania. Średnie wartości MSE wyniosły 0,2880 przy uwzględnieniu wszystkich danych, 0,2224 dla zestawu danych treningowych i 0,3593 dla zestawu danych testowych. Odchylenia standardowe wartości MSE wyniosły 5,9651x10⁻¹⁰, 9,0962x10⁻¹⁰ i 7,7356x10⁻¹⁰ odpowiednio dla całego zestawu danych, zestawu danych treningowych i zestawu danych testowych. Zwiększenie liczby jednostek neuronowych w warstwie ukrytej do 15 nie spowodowało żadnej znaczącej poprawy średnich wartości MSE (odpowiednio 0,2879, 0,2222 i 0,3593 dla wszystkich danych, zestawu danych treningowych i zestawu danych testowych), więc zachowano poprzednią sztuczną sieć neuronową z 10 neuronami w warstwie ukrytej. Poniższe wyniki odpowiadają przebiegowi treningowemu i testowemu tej sieci neuronowej z globalnym MSE wynoszącym 0,2513. Analiza regresji liniowej wskazuje, że dane sieci neuronowej bardzo dobrze pasują do danych eksperymentalnych w całym zakresie bezwymiarowego parametru uszkodzenia S. W efekcie współczynnik korelacji wynosi 0,983, a równanie najlepszego dopasowania liniowego, y = 0,938x ? 0,00229, jest bardzo zbliżone do równania linii przekątnej y = x . Wyniki uzyskane z zestawem danych treningowych (testy stabilności T20, T21, T22 i T23) wykazują doskonałą zgodność między modelem sieci neuronowej a modelem fizycznym. W trzech z czterech testów (T20, T22 i T23) dane sieci neuronowej naśladują pomiary na falochronie modelu niemal do perfekcji. W teście T21 model fizyczny doświadcza gwałtownego wzrostu poziomu uszkodzeń przy H* = 1,65, który jest lekko łagodzony przez model ANN. Wartość MSE wynosi 0,1441. Zestaw danych testowych obejmował również cztery testy stabilności (T10, T11, T12 i T13). Wrodzona trudność problemu jest widoczna w teście T11 , w którym bezwymiarowy parametr uszkodzeń (S) nie wzrasta w przebiegu fali przy H* = 1,54, ale nagle wzrasta o około 100% w następnym przebiegu fali przy H* = 1,65. Takie różnice między przebiegami fal są praktycznie niemożliwe do uchwycenia przez model ANN, biorąc pod uwagę, że dane wejściowe do modelu ANN albo zmieniają się tylko nieznacznie, w tym przypadku o mniej niż 7% (bezwymiarowa wysokość fali, H*), albo wcale się nie zmieniają (względna głębokość wody, kh). Należy pamiętać, że podczas obliczania uszkodzeń po danym przebiegu fali, sieć neuronowa ANN nie ma żadnych informacji o poziomie uszkodzeń przed przebiegiem fali, w przeciwieństwie do modelu fizycznego. Mimo to sieć neuronowa ANN działa dobrze, dając wartość MSE równą 0,3678 z zestawem danych testowych.
TRENDY NA PRZYSZŁOŚĆ
W tym badaniu wykorzystano wyniki testów stabilności przeprowadzonych na regularnych falach. Testy fal nieregularnych powinny być również analizowane za pomocą sztucznej inteligencji, a autorzy zamierzają to zrobić w przyszłości. Charakterystyka falochronu to kolejny ważny aspekt problemu. Sieć neuronowa ANN nie może ekstrapolować poza zakresy charakterystyk fal i falochronu, na których została wytrenowana. Testy stabilności wykorzystane w tym badaniu uwzględniały jeden model falochronu; należy przeprowadzić dalsze testy obejmujące modele fizyczne z innymi geometriami i materiałami. Po udowodnieniu potencjału sztucznych sieci neuronowych do modelowania zachowania falochronu z gruzowiska poddanego działaniu fal, można zbudować wirtualne laboratorium z wynikami tych testów.
WNIOSEK
Niniejszy artykuł pokazuje, że sztuczne sieci neuronowe są w stanie modelować zachowanie się falochronu z gruzu kamiennego w obliczu fal energetycznych. Jest to bardzo złożony problem z wielu powodów. Po pierwsze, hydrodynamika fal łamiących się na zboczu nie jest dobrze znana, tak bardzo, że szczegółowa charakterystyka ruchów cząstek wody nie jest możliwa w chwili obecnej i może pozostać taka w przyszłości ze względu na chaotyczną naturę zaangażowanych procesów. Po drugie, w przypadku falochronu z gruzu kamiennego problem jest dodatkowo złożony z powodu porowatej natury struktury, która powoduje złożoną interakcję fala-struktura, w której strumień energii przenoszony przez falę padającą jest rozprowadzany na następujące procesy: (i) odbicie fali; (ii) łamanie fali na zboczu; (iii) transmisja fali przez porowate medium; i (iv) rozpraszanie. Subtelna interakcja między wszystkimi tymi procesami oznacza, że nie można badać żadnego z nich bez uwzględnienia pozostałych. Po trzecie, samo porowate medium ma charakter stochastyczny: nie można powiedzieć, że dwa falochrony z gruzowiska są identyczne. Ta złożoność uniemożliwiała do tej pory opracowanie modelu numerycznego, który mógłby wiarygodnie analizować siły działające na jednostki warstwy pancerza, a tym samym sytuację stabilności falochronu. W konsekwencji testy modelu fizycznego są koniecznością, gdy przewiduje się dużą strukturę z gruzowiska. Pomimo trudności problemu, wykazano, że sztuczna sieć neuronowa użyta w tej pracy odtwarza bardzo dokładnie wyniki modelu fizycznego. Tak więc sztuczna sieć neuronowa może stanowić, po odpowiednim przeszkoleniu i walidacji, wirtualne laboratorium. Testowanie falochronu w tym wirtualnym laboratorium jest znacznie szybsze i znacznie tańsze niż testowanie fizycznego modelu tej samej struktury w laboratoryjnym korycie falowym.
Sztuczna inteligencja w wyszukiwaniu informacji
WSTĘP
W tym artykule opisano najbardziej znane podejścia do stosowania technologii sztucznej inteligencji w wyszukiwaniu informacji (IR). Wyszukiwanie informacji jest kluczową technologią w zarządzaniu wiedzą. Zajmuje się wyszukiwaniem informacji oraz reprezentacją, przechowywaniem i organizacją wiedzy. Wyszukiwanie informacji dotyczy procesów wyszukiwania, w których użytkownik musi zidentyfikować podzbiór informacji, który jest istotny dla jego potrzeb informacyjnych w ramach dużej ilości wiedzy. Poszukujący informacji formułuje zapytanie, próbując opisać swoje potrzeby informacyjne. Zapytanie jest porównywane z reprezentacjami dokumentów, które zostały wyodrębnione podczas fazy indeksowania. Reprezentacje dokumentów i zapytań są zazwyczaj dopasowywane przez funkcję podobieństwa, taką jak cosinus. Najbardziej podobne dokumenty są prezentowane użytkownikom, którzy mogą ocenić istotność w odniesieniu do swojego problemu (Belkin, 2000). Problem prawidłowego reprezentowania dokumentów i dopasowywania niedokładnych reprezentacji wkrótce doprowadził do zastosowania technik opracowanych w ramach sztucznej inteligencji do wyszukiwania informacji.
KONTEKST
Na początku informatyki wyszukiwanie informacji (IR) i sztuczna inteligencja (AI) rozwijały się równolegle. W latach 80. XX wieku zaczęły ze sobą współpracować, a termin inteligentne wyszukiwanie informacji został ukuty dla zastosowań AI w IR. W latach 90. XX wieku wyszukiwanie informacji przeszło od modeli wyszukiwania boolowskiego opartych na zbiorach do systemów rankingowych, takich jak model przestrzeni wektorowej i podejścia probabilistyczne. Te przybliżone systemy wnioskowania otworzyły drzwi dla bardziej inteligentnych komponentów o wartości dodanej. Duża liczba dokumentów tekstowych dostępnych w profesjonalnych bazach danych i w Internecie doprowadziła do zapotrzebowania na inteligentne metody wyszukiwania tekstu i do znacznych badań w tej dziedzinie. Potrzeba lepszego wstępnego przetwarzania w celu wyodrębnienia większej wiedzy z danych stała się ważnym sposobem na ulepszenie systemów. Gotowe podejścia obiecują gorsze wyniki niż systemy dostosowane do użytkowników, domeny i potrzeb informacyjnych. Obecnie większość technik opracowanych w AI została zastosowana w systemach wyszukiwania z większym lub mniejszym powodzeniem. Gdy dostępne są dane od użytkowników, systemy często wykorzystują uczenie maszynowe w celu optymalizacji swoich wyników.
Metody sztucznej inteligencji w wyszukiwaniu informacji
Metody sztucznej inteligencji są stosowane w całym standardowym procesie wyszukiwania informacji i w przypadku nowych usług o wartości dodanej. Pierwsza sekcja zawiera krótki przegląd wyszukiwania informacji. Następne sekcje są zorganizowane wzdłuż etapów procesu wyszukiwania i podają przykłady zastosowań.
Wyszukiwanie informacji
Wyszukiwanie informacji zajmuje się przechowywaniem i reprezentacją wiedzy oraz wyszukiwaniem informacji istotnych dla konkretnego problemu użytkownika. Poszukujący informacji formułuje zapytanie, próbując opisać swoje potrzeby informacyjne. Zapytanie jest porównywane z reprezentacjami dokumentów. Reprezentacje dokumentów i zapytań są zazwyczaj dopasowywane za pomocą funkcji podobieństwa, takiej jak współczynnik cosinusa lub Dice′a. Najbardziej podobne dokumenty są prezentowane użytkownikom, którzy mogą ocenić ich trafność w odniesieniu do swojego problemu. Indeksowanie zazwyczaj składa się z kilku faz. Po segmentacji słów usuwane są słowa pomijane. Te powszechne słowa, takie jak artykuły lub przyimki, same w sobie zawierają niewiele znaczenia i są ignorowane w reprezentacji dokumentu. Po drugie, formy słów są przekształcane w ich podstawową formę, rdzeń. Podczas fazy rdzeniowania, np. domy byłyby przekształcane w dom. W przypadku reprezentacji dokumentu różne formy słów zwykle nie są konieczne. Znaczenie słowa dla dokumentu może być różne. Niektóre słowa lepiej opisują treść dokumentu niż inne. Ta waga jest określana przez częstotliwość występowania tematu w tekście dokumentu. W wyszukiwaniu multimediów kontekst jest niezbędny do wyboru formy zapytania i reprezentacji dokumentu. Różne reprezentacje mediów mogą być dopasowywane do siebie lub mogą być konieczne transformacje (np. dopasowywanie terminów do obrazów lub wypowiedzi mówionych do dokumentów w tekście pisanym). Ponieważ wyszukiwanie informacji musi radzić sobie z niejasną wiedzą, dokładne metody przetwarzania nie są odpowiednie. Bardziej odpowiednie są niejasne modele wyszukiwania, takie jak model probabilistyczny. W ramach tych modeli terminy są dostarczane z wagami odpowiadającymi ich znaczeniu dla dokumentu. Te wagi odzwierciedlają różne poziomy istotności. Wynikiem obecnych systemów wyszukiwania informacji są zazwyczaj posortowane listy dokumentów, w których najlepsze wyniki są bardziej prawdopodobne, że będą istotne według systemu. W niektórych podejściach użytkownik może ocenić zwrócone mu dokumenty i powiedzieć systemom, które z nich są dla niego istotne. Następnie system sortuje zestaw wyników. Dokumenty, które zawierają wiele słów obecnych w odpowiednich dokumentach, są wyżej klasyfikowane. Wiadomo, że ten proces sprzężenia zwrotnego istotności znacznie poprawia wydajność. Sprzężenie zwrotne istotności jest również interesującym zastosowaniem uczenia maszynowego. Na podstawie decyzji człowieka, krok optymalizacji można modelować za pomocą kilku podejść, np. z przybliżonymi zestawami. W środowiskach internetowych kliknięcie jest często interpretowane jako niejawny pozytywny osąd istotności.
Zaawansowane modele reprezentacji
Aby reprezentować dokumenty w języku naturalnym, należy przeanalizować ich zawartość. Jest to trudne zadanie dla systemów komputerowych. Solidna analiza semantyczna dla dużych zbiorów tekstów lub nawet obiektów multimedialnych nie została jeszcze opracowana. Dlatego dokumenty tekstowe są reprezentowane przez terminy języka naturalnego głównie bez kontekstu składniowego lub semantycznego. Jest to często określane jako podejście bag-of-words. Te słowa kluczowe lub terminy mogą tylko niedoskonale reprezentować obiekt, ponieważ ich kontekst i relacje z innymi terminami są tracone. Jednak poczyniono duże postępy, a systemy analizy semantycznej stają się konkurencyjne. Zaawansowana analiza składniowa i semantyczna do solidnego przetwarzania danych masowych została wyprowadzona z lingwistyki obliczeniowej. W przypadku wiedzy specyficznej dla aplikacji i domeny, stosuje się inne podejście w celu ulepszenia reprezentacji dokumentów. Schemat reprezentacji jest wzbogacany poprzez wykorzystanie wiedzy o koncepcjach domeny
Dopasowanie między zapytaniem a dokumentem
Po wyprowadzeniu reprezentacji kluczowym aspektem systemu wyszukiwania informacji jest obliczenie podobieństwa między zapytaniem a reprezentacją dokumentu. Większość systemów wykorzystuje matematyczne funkcje podobieństwa, takie jak cosinus. Decyzja dotycząca konkretnej funkcji opiera się na heurystyce lub ocenach empirycznych. Kilka podejść wykorzystuje uczenie maszynowe do długoterminowej optymalizacji dopasowania między terminem a dokumentem. Np. jedno podejście stosuje algorytm genetyczny w celu dostosowania funkcji ważenia do zbioru (Almeida i in., 2007). Sieci neuronowe były szeroko stosowane w IR. Do zadań wyszukiwania zastosowano kilka architektur sieciowych, najczęściej używane są tak zwane sieci aktywacji rozprzestrzeniania. Sieci aktywacji rozprzestrzeniania są prostymi sieciami w stylu Hopfielda, jednak nie wykorzystują reguły uczenia się sieci Hopfielda. Zazwyczaj składają się z dwóch warstw reprezentujących terminy i dokumenty. Wagi połączeń między warstwami są dwukierunkowe i początkowo ustawione zgodnie z wynikami tradycyjnych algorytmów indeksowania i ważenia. Neurony odpowiadające terminom zapytania użytkownika są aktywowane w warstwie terminów, a aktywacja rozprzestrzenia się wzdłuż wag do warstwy dokumentu i z powrotem. Aktywacja reprezentuje istotność lub zainteresowanie i dociera do potencjalnie istotnych terminów i dokumentów. Najbardziej aktywowane dokumenty są prezentowane użytkownikowi jako wynik. Dokładniejsze przyjrzenie się modelom ujawnia, że bardzo przypominają one tradycyjny model przestrzeni wektorowej wyszukiwania informacji. Dopiero po drugim kroku asocjacyjna natura procesu rozprzestrzeniania aktywacji prowadzi do wyników innych niż model przestrzeni wektorowej. Sieci rozprzestrzeniania aktywacji pomyślnie przetestowane przy użyciu danych masowych nie wykorzystują tej asocjacyjnej właściwości. W niektórych systemach proces jest zatrzymywany po zaledwie jednym kroku z warstwy terminów do warstwy dokumentów, podczas gdy inne wykonują jeszcze jeden krok wstecz do warstwy terminów, aby ułatwić naukę. Zapytania w systemach wyszukiwania informacji są zwykle krótkie i zawierają niewiele słów. Dłuższe zapytania mają większe prawdopodobieństwo osiągnięcia dobrych wyników. W konsekwencji systemy próbują dodać dobre terminy do zapytania wprowadzonego przez użytkownika. Zastosowano kilka technik. Terminy te są pobierane z dokumentów o najwyższej randze lub używane są terminy podobne do oryginalnych. Inna technika polega na użyciu terminów z dokumentów z tej samej kategorii. W tym celu stosuje się algorytmy klasyfikacyjne z uczenia maszynowego. Analiza linków stosuje dobrze znane miary z analizy bibliometrycznej do sieci Web. Liczba linków wskazujących na stronę internetową jest używana jako wskaźnik jej jakości. PageRank przypisuje wartość autorytetu każdej stronie internetowej, która jest przede wszystkim funkcją jej linków zwrotnych. Ponadto zakłada, że linki ze stron o wysokim autorytecie powinny być wyżej ważone i powinny skutkować wyższym autorytetem dla strony odbierającej. Aby uwzględnić różne wartości, które każda strona musi rozdysponować, algorytm jest wykonywany iteracyjnie, aż wynik będzie zbieżny. Podejścia uczenia maszynowego uzupełniają analizę linków. Decyzje ludzi dotyczące jakości stron internetowych służą do określania cech projektowych tych stron, które są dobrymi wskaźnikami ich jakości. Modele uczenia maszynowego są stosowane do określania jakości stron, które nie zostały jeszcze ocenione. Uczenie się od użytkowników było ważną strategią ulepszania systemów. Oprócz treści, metody sztucznej inteligencji zostały wykorzystane do ulepszania interfejsu użytkownika.
Komponenty o wartości dodanej dla interfejsów użytkownika
Kilku badaczy wdrożyło systemy wyszukiwania informacji oparte na samoorganizującej się mapie Kohonena (SOM), modelu sieci neuronowej do nienadzorowanej klasyfikacji. Zapewniają one asocjacyjny interfejs użytkownika, w którym sąsiedztwo dokumentów wyraża relację semantyczną. Implementacje dla dużych zbiorów można testować w Internecie. SOM składa się z zazwyczaj dwuwymiarowej siatki neuronów, z których każdy jest powiązany z wektorem wag. Dokumenty wejściowe są klasyfikowane według podobieństwa między wzorcem wejściowym a wektorami wag, a algorytm dostosowuje wagi zwycięskiego neuronu i jego sąsiada. W ten sposób sąsiednie klastry mają duże podobieństwo. Aplikacje wyszukiwania informacji SOM klasyfikują dokumenty i przypisują dominujący termin jako nazwę klastra. W przypadku rzeczywistych zbiorów na dużą skalę jedna dwuwymiarowa siatka nie jest wystarczająca. Byłaby ona albo zbyt duża, albo każdy węzeł zawierałby w konsekwencji zbyt wiele dokumentów. Żadna z nich nie byłaby pomocna dla użytkowników, dlatego przyjęto architekturę warstwową. Najwyższa warstwa składa się z węzłów, które reprezentują klastry dokumentów. Dokumenty tych węzłów są ponownie analizowane przez SOM. Dla użytkownika system składa się z kilku dwuwymiarowych map terminów, w których podobne terminy znajdują się blisko siebie. Po wybraniu jednego węzła może on dotrzeć do innego dwuwymiarowego SOM. Paradygmat wyszukiwania informacji dla SOM polega na przeglądaniu i nawigowaniu między warstwami map. SOM wydaje się być bardzo naturalną wizualizacją. Jednak podejście SOM ma pewne poważne wady.
• Interfejs do interakcji z kilkoma warstwami map sprawia, że system jest trudny do przeglądania.
• Użytkownicy dużych zbiorów tekstów potrzebują przede wszystkim mechanizmów wyszukiwania, których sam SOM nie oferuje.
• Podobieństwo zbioru dokumentów jest zredukowane do dwóch wymiarów, pomijając wiele potencjalnie interesujących aspektów.
• SOM lepiej rozwija swoje zalety dla interakcji człowiek-komputer w przypadku małej liczby dokumentów. Bardzo zachęcającym zastosowaniem byłoby klasteryzacja zestawu wyników. Neurony zmieściłyby się na jednym ekranie, liczba wyrazów byłaby ograniczona, a zatem redukcja do dwóch wymiarów nie pominęłaby tak wielu aspektów.
Klasyfikacja i personalizacja użytkownika
Adaptacyjne podejścia do wyszukiwania informacji mają na celu dostosowanie wyników systemu do jednego użytkownika oraz jego zainteresowań i preferencji. Najpopularniejszy schemat reprezentacji opiera się na schemacie reprezentacji używanym w wyszukiwaniu informacji, w którym macierz dokumentu-terminu przechowuje ważność lub wagę każdego terminu dla każdego dokumentu. Gdy termin pojawia się w dokumencie, ta waga powinna być inna niż zero. Zainteresowanie użytkownika może być również przechowywane jak dokument. Wówczas zainteresowanie jest wektorem terminów. Mogą to być terminy, które użytkownik wprowadził lub wybrał w interfejsie użytkownika lub które system wyodrębnił z dokumentów, którymi użytkownik wykazał zainteresowanie, przeglądając je lub pobierając. Przykładem takiego systemu jest UCAIR, który można zainstalować jako wtyczkę do przeglądarki. UCAIR opiera się na standardowej wyszukiwarce internetowej w celu uzyskania wyniku wyszukiwania i podstawowego rankingu. Ten ranking jest obecnie modyfikowany przez ponowne klasyfikowanie dokumentów na podstawie niejawnych informacji zwrotnych i zapisanego profilu zainteresowań użytkownika. Większość systemów wykorzystuje tę metodę przechowywania zainteresowania użytkownika w wektorze terminów. Jednak ta metoda ma kilka wad. Profil zainteresowań może nie być stabilny, a użytkownik może mieć różnorodne rozbieżne zainteresowania pracą i wypoczynkiem, które są wymieszane w jednym profilu. Zaawansowane techniki indywidualizacji personalizują podstawowe funkcje systemu. Wyniki badań empirycznych wykazały, że sprzężenie zwrotne trafności jest skuteczną techniką poprawy jakości wyszukiwania. Metody uczenia się wyszukiwania informacji muszą rozszerzać zakres efektów sprzężenia zwrotnego trafności poza modyfikację zapytania, aby osiągnąć długoterminową adaptację do subiektywnego punktu widzenia użytkownika. Sama zmiana zapytania często skutkuje poprawą jakości; jednak informacje są tracone po bieżącej sesji. Niektóre systemy zmieniają reprezentację dokumentu zgodnie z informacją zwrotną trafności. W metaforze przestrzeni wektorowej odpowiednie dokumenty są przesuwane w kierunku reprezentacji zapytania. To podejście również obejmuje pewne problemy. Ponieważ tylko ułamek dokumentów jest objęty modyfikacjami, podstawowe dane z procesu indeksowania są zmieniane w nieco heterogeniczny stan. Oryginalny wynik indeksowania nie jest już dostępny. Z pewnością ta technika jest niewystarczająca w przypadku podejść fuzyjnych, w których łączy się kilka metod wyszukiwania. W tym przypadku kilka podstawowych reprezentacji musiałoby zostać zmienionych zgodnie z wpływem odpowiednich metod na odpowiednie dokumenty. Indeksy są zazwyczaj heterogeniczne, co często uważa się za zaletę podejść fuzyjnych. Konsekwencją byłoby duże przeciążenie obliczeniowe. Podejście MIMOR (Multiple Indexing and Method-Object Relations) nie polega na zmianach dokumentu ani reprezentacji zapytania podczas przetwarzania informacji zwrotnej o trafności w celu personalizacji. Zamiast tego koncentruje się na centralnym aspekcie funkcji wyszukiwania, obliczaniu podobieństwa między dokumentem a zapytaniem. Podobnie jak inne metody fuzji, MIMOR akceptuje wynik poszczególnych systemów wyszukiwania, jak z czarnej skrzynki. Wyniki te są łączone za pomocą kombinacji liniowej, która jest przechowywana podczas wielu sesji. Wagi systemów ulegają zmianie w wyniku uczenia się. Dostosowują się one zgodnie z informacjami zwrotnymi o trafności dostarczanymi przez użytkowników i tworzą długoterminowy model do wykorzystania w przyszłości. W ten sposób MIMOR uczy się, które systemy odniosły sukces w przeszłości
PRZYSZŁE TRENDY
Systemy wyszukiwania informacji są stosowane w coraz bardziej złożonych i zróżnicowanych środowiskach. Przeszukiwanie poczty e-mail, zbiorów społecznościowych i innych określonych domen stwarza nowe wyzwania, które prowadzą do innowacyjnych systemów. Te aplikacje wyszukiwania wymagają dokładnej i zorientowanej na użytkownika oceny. Nowe środki oceny i standaryzowane zbiory testów są niezbędne do uzyskania wiarygodnych wyników oceny. W adaptacji użytkownika systemy rekomendacji są ważnym trendem dla przyszłych ulepszeń. Systemy rekomendacji należy postrzegać w kontekście aplikacji społecznościowych. Twórcy systemów stają w obliczu wzrostu treści generowanych przez użytkowników, co umożliwia nowe metody rozumowania. Można się spodziewać, że nowe aplikacje, takie jak odpowiadanie na pytania, polegające na bardziej inteligentnym przetwarzaniu, zdobędą większy udział w rynku w niedalekiej przyszłości
WNIOSEK
Zarządzanie wiedzą ma ogromne znaczenie dla społeczeństwa informacyjnego. Dokumenty napisane w języku naturalnym zawierają znaczną część dostępnej wiedzy. W związku z tym wyszukiwanie ma kluczowe znaczenie dla sukcesu systemów zarządzania wiedzą. Technologie AI są szeroko stosowane w systemach wyszukiwania. Wykorzystanie wiedzy w bardziej efektywny sposób jest głównym obszarem badań. Ponadto zorientowane na użytkownika systemy wartości dodanej wymagają inteligentnego przetwarzania i uczenia maszynowego w wielu formach. Ważnym przyszłym trendem dla metod AI w IR będzie adaptacja metod wyszukiwania do kontekstu. Uczenie maszynowe można stosować w celu znalezienia zoptymalizowanych funkcji dla kolekcji lub zapytań.
Sztuczna inteligencja w komputerowo wspomaganej diagnostyce
WSTĘP
Specjaliści z dziedziny radiologii medycznej są bezpośrednio zależni od procesu podejmowania decyzji w swoich codziennych czynnościach. Proces ten opiera się głównie na analizie dużej ilości informacji uzyskanych w celu oceny obrazów radiograficznych. Niektóre badania wykazują dużą pojemność sztucznych sieci neuronowych (ANN) w systemach wspomagających diagnostykę, głównie w zastosowaniach jako klasyfikacja wzorców. Celem tego artykułu jest przedstawienie rozwoju systemu opartego na ANN, weryfikującego jego zachowanie jako narzędzia ekstrakcji cech i redukcji wymiarowości, do rozpoznawania i charakteryzowania wzorców, do późniejszej klasyfikacji wzorców normalnych i nieprawidłowych.
KONTEKST
Diagnostyka wspomagana komputerowo (CAD) jest uważana za jeden z głównych obszarów badań obrazów medycznych i diagnostyki radiologicznej. Według Gigera "W przyszłości prawdopodobne jest, że wszystkie obrazy medyczne będą miały jakąś formę wykonanej CAD, aby skorzystać na wynikach i opiece nad pacjentem". Diagnoza radiologa jest zazwyczaj oparta na jakościowej interpretacji analizowanych danych, na które może wpływać i być szkodliwa przez wiele czynników, takich jak niska jakość obrazu, zmęczenie wzroku, rozproszenie, nakładanie się struktur, między innymi. Ponadto ludzie mają ograniczenia w zdolnościach wzrokowych, co może utrudniać analizę obrazu medycznego, głównie w wykrywaniu określonych prezentowanych wzorców . Badania wykazują, że gdy analiza jest przeprowadzana przez dwóch radiologów, czułość diagnozy znacznie wzrasta. W tym kierunku CAD może być używany jako drugi specjalista, gdy dostarcza komputerowi odpowiedź jako drugą opinię. Wiele prac analizuje wydajność radiologa przed wykorzystaniem systemów CAD, od których oddzielamy badania Jiang i iinni oraz Fenton i inni. W rozwoju systemów CAD zwykle stosuje się techniki z dwóch obszarów obliczeniowych: Computer Vision i Artificial Intelligence. Z obszaru Computer Vision stosuje się techniki przetwarzania obrazu w celu ulepszenia, segmentacji i ekstrakcji cech. Celem ulepszenia jest poprawa obrazu, aby uczynić go bardziej odpowiednim dla konkretnego zastosowania. W zastosowaniach z cyfrowymi obrazami medycznymi, ulepszenie jest ważne, aby ułatwić analizę wizualną ze strony specjalisty. Segmentacja to etap, w którym obraz jest dzielony na części lub obiekty składowe . Wynikiem segmentacji jest zbiór obiektów, które można analizować i kwantyfikować indywidualnie, reprezentując określone cechy oryginalnego obrazu. Ostatnim etapem przetwarzania obrazu jest ekstrakcja cech, która zasadniczo obejmuje kwantyfikowanie elementów, które składają się na segmentowane obiekty oryginalnego obrazu, takie jak rozmiar, kontrast i forma. Po zakończeniu tej pierwszej części skwantyfikowane atrybuty są wykorzystywane do klasyfikacji struktur zidentyfikowanych na obrazie, zwykle przy użyciu metod sztucznej inteligencji. Według Kononenko wykorzystanie sztucznej inteligencji we wsparciu diagnozy jest wydajne, umożliwiając złożoną analizę danych o prostej i bezpośredniej formie. Wiele metod i technik sztucznej inteligencji można zastosować na tym etapie, zwykle w celu zidentyfikowania i oddzielenia wzorców na odrębne grupy, na przykład wzorce normalne i nieprawidłowe. Według Kahna Jr (1994) wśród głównych technik można wymienić: rozumowanie oparte na regułach, sztuczne sieci neuronowe, sieci bayesowskie, rozumowanie oparte na przypadkach. Do nich można dodać metody statystyczne, algorytmy genetyczne i drzewa decyzyjne. Problemem, który dotyka większości zastosowań rozpoznawania wzorców, jest wymiarowość danych. Wymiarowość jest związana z liczbą atrybutów, które reprezentują wzorzec, czyli wymiarem przestrzeni wyszukiwania. Gdy przestrzeń ta zawiera tylko najbardziej istotne atrybuty, proces klasyfikacji jest szybszy i zużywa niewiele zasobów przetwarzania , a także pozwala na większą precyzję klasyfikatora. W problemach przetwarzania obrazów medycznych akcentowane jest znaczenie redukcji wymiarowości; dlatego normalnie obrazy, które mają być przetwarzane, składają się z bardzo dużej liczby pikseli, używanych jako podstawowe atrybuty w klasyfikacji. Ekstrakcja cech jest powszechnym podejściem do przeprowadzenia redukcji wymiarowości. Ogólnie rzecz biorąc, algorytm ekstrakcji tworzy nowy zestaw atrybutów z przekształceń lub kombinacji oryginalnego zestawu. Niektóre metody są badane w celu promowania ekstrakcji cech, a w konsekwencji redukcji wymiarowości, takie jak metody statystyczne, metody oparte na teorii sygnałów i sztuczne sieci neuronowe. Jako przykład wykorzystania sztucznych sieci neuronowych we wsparciu diagnostyki medycznej możemy przytoczyć badania Papadopoulosa i inni oraz André & Rangayan (2006).
GŁÓWNY TEMAT ARTYKUŁU
W tym artykule przedstawiamy również propozycję wykorzystania sztucznej inteligencji na etapie ekstrakcji cech, zastępując tradycyjne techniki przetwarzania obrazu. Tradycyjnie ekstrakcja cech jest przeprowadzana na podstawie technik statystycznych lub spektralnych, które skutkują na przykład teksturą lub atrybutami geometrycznymi. Po uzyskaniu tych atrybutów techniki sztucznej inteligencji są stosowane w klasyfikacji wzorców. Nasza propozycja to wykorzystanie ANN również do ekstrakcji cech.
Ekstrakcja cech za pomocą ANN
Ekstrakcja cech za pomocą sztucznych sieci neuronowych działa zasadniczo jako wybór cech, które reprezentują oryginalny zestaw danych. Ten wybór cech jest związany z procesem, w którym zestaw danych jest przekształcany w przestrzeń cech, która teoretycznie dokładnie opisuje te same informacje, co oryginalna przestrzeń danych. Jednak transformacja jest projektowana w taki sposób, że zestaw danych jest reprezentowany przez zredukowaną efektywną cechę, zachowując większość wewnętrznych informacji danych, to znaczy oryginalny zestaw danych cierpi na znaczną redukcję wymiarowości. Redukcja wymiarowości jest niezwykle użyteczna w aplikacjach, które obejmują przetwarzanie obrazu cyfrowego, które zazwyczaj zależą od bardzo dużej liczby punktów danych do manipulowania. Podsumowując, ekstrakcja cech za pomocą sieci neuronowych przekształca oryginalny zestaw pikseli w mapę o zmniejszonych wymiarach, która reprezentuje oryginalny obraz bez znaczącej utraty informacji. Do tej funkcji zazwyczaj stosuje się samoorganizujące się sieci neuronowe, takie jak na przykład samoorganizująca się mapa Kohonena (SOM). Samoorganizująca się mapa wyszukuje sposoby przekształcenia jednego określonego wzoru w dwuwymiarową mapę, zgodnie z pewnym porządkiem topologicznym. Elementy tworzące mapę są rozmieszczone w jednej warstwie, tworząc siatkę
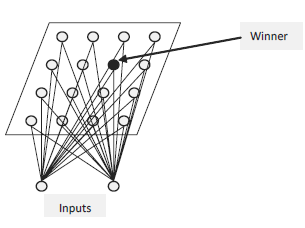
Wszystkie elementy siatki odbierają sygnał wejściowy wszystkich zmiennych, powiązanych z ich odpowiednimi wagami. Obliczenie jego wartości wyjściowej jest przeprowadzane przez jedną określoną funkcję, na podstawie wag połączeń, i służy do identyfikacji zwycięskiego elementu. Matematycznie każdy element siatki jest reprezentowany przez wektor złożony z wag połączeń, o tym samym wymiarze przestrzeni wejściowej, to znaczy, że liczba elementów tworzących wektor odpowiada liczbie zmiennych wejściowych problemu.
Metodologia
Jako przykład zastosowania opracowano samoorganizującą się sieć neuronową do ekstrakcji cech obrazów radiogramów klatki piersiowej, obiektywizującą charakterystykę wzorców prawidłowych i nieprawidłowych. Każdy oryginalny obraz został podzielony na 12 części, mając za podstawę podział anatomiczny zwykle stosowany w diagnostyce radiologa. Każda część składa się z około 250 000 pikseli. Przy użyciu proponowanej samouczącej się sieci uzyskano redukcję tylko dla 240 reprezentatywnych elementów, z zadowalającymi wynikami w końcowej klasyfikacji wzorca.
PRZYSZŁE TRENDY
Opracowane badanie pokazuje możliwości zastosowania samouczących się sieci w ekstrakcji cech i redukcji wymiarowości; jednak w tym celu można również wykorzystać inne typy sieci neuronowych. Należy przeprowadzić nowe badania w celu porównania wyników i adekwatności metodologii.
WNIOSEK
Wkład technologii informacyjnej jest niezaprzeczalny jako narzędzie wspomagające podejmowanie decyzji medycznych. Sztuczna inteligencja przedstawia się jako świetne źródło ważnych technik, które należy wykorzystać w tym kierunku. Można udowodnić, że technika sztucznych sieci neuronowych podkreśla swoją dużą wszechstronność i solidność, zapewniając wystarczająco zadowalające wyniki, gdy jest dobrze stosowana i wdrażana. Wykorzystanie automatycznego systemu analizy obrazu może pomóc radiologowi, gdy jest używany jako narzędzie "drugiej opinii" lub drugiego odczytu, w analizie możliwych niedokładnych przypadków. Obserwuje się również, że wykorzystanie proponowanej metodologii stanowi znaczący zysk w przetwarzaniu obrazu radiogramów klatki piersiowej ze względu na jej szczególne cechy.
Sztuczne sieci neuronowe i modelowanie poznawcze
WSTĘP
W czasach swojej świetności sztuczne sieci neuronowe obiecywały radykalnie nowe podejście do modelowania poznawczego. Podejście koneksjonistyczne dało początek wielu wpływowym i kontrowersyjnym modelom poznawczym. W tym artykule rozważamy główne cechy podejścia, przyglądamy się czynnikom prowadzącym do jego entuzjastycznego przyjęcia i omawiamy, w jakim stopniu różni się ono od wcześniejszych modeli obliczeniowych. Koneksjonistyczne modele poznawcze wywarły znaczący wpływ na badanie umysłu. Jednak koneksjonizm nie jest już w szczytowym okresie. Zostaną zidentyfikowane możliwe powody spadku jego popularności, a także podjęta zostanie próba określenia jego prawdopodobnej przyszłości. Rozwój modeli koneksjonistycznych datuje się od publikacji w 1986 r. przez Rumelharta i McClellanda, zredagowanej pracy zawierającej zbiór koneksjonistycznych modeli poznania, z których każdy był trenowany przez ekspozycję na próbki wymaganych zadań. Te tomy wyznaczyły program dla koneksjonistycznych modelarzy poznawczych i zaoferowały metodologię, która następnie stała się standardem. Koneksjonistyczne modele poznawcze zostały od tego czasu opracowane w dziedzinach obejmujących wyszukiwanie pamięci i tworzenie kategorii, a także (w języku) rozpoznawanie fonemów, rozpoznawanie słów, percepcję mowy, nabytą dysleksję, nabywanie języka oraz (w wizji) wykrywanie krawędzi, rozpoznawanie obiektów i kształtów. Ponad dwadzieścia lat później wpływ tej pracy jest nadal widoczny.
KONTEKST
Model wymowy słów Seidenberga i McClellanda (1989) jest dobrze znanym przykładem koneksjonistycznym. Użyli oni propagacji wstecznej do wytrenowania trójwarstwowej sieci w celu odwzorowania reprezentacji ortograficznej słów i niesłów na rozproszoną reprezentację fonologiczną i reprezentację wyjściową ortograficzną. Twierdzi się, że model ten dobrze pasuje do danych eksperymentalnych pochodzących od ludzi. Ludzie mogą szybko podejmować decyzje, czy ciąg liter jest słowem, czy nie (w zadaniu decyzyjnym leksykalnym) i mogą łatwo wymawiać zarówno słowa, jak i niesłowa. Czas potrzebny na wykonanie obu czynności zależy od wielu czynników, w tym częstotliwości występowania słów w języku i regularności ich pisowni. Wytrenowana sztuczna sieć neuronowa wyprowadza zarówno reprezentację fonologiczną, jak i ortograficzną swojego wejścia. Reprezentacja fonologiczna jest traktowana jako równoważna wymawianiu słowa lub niesłowa. Reprezentacja ortograficzna i stopień, w jakim powiela ona oryginalne dane wejściowe, są uważane za równoważne zadaniu decyzji leksykalnej. Model czasu przeszłego również miał duży wpływ. Model ten odzwierciedla kilka aspektów uczenia się końcówek czasowników przez człowieka. Został wytrenowany na przykładach formy rdzenia słowa jako danych wejściowych i formy czasu przeszłego jako danych wyjściowych. Każde dane wejściowe i wyjściowe były reprezentowane jako zestaw kontekstowo zależnych cech fonologicznych, kodowanych i dekodowanych za pomocą stałej sieci kodera/dekodera. Celem modelu było symulowanie sekwencji przypominających etapy uczenia się czasu przeszłego, jakie wykazują ludzie. Małe dzieci najpierw poprawnie uczą się czasu przeszłego kilku czasowników, zarówno regularnych (np. looked), jak i nieregularnych (np. went lub came). Na etapie 2 często zachowują się tak, jakby wywnioskowały ogólną regułę tworzenia czasu przeszłego (dodając -ed do tematu czasownika). Często jednak nadmiernie uogólniają tę regułę i dodają -ed do czasowników nieregularnych (np. comed). Istnieje stopniowe przejście do etapu końcowego, w którym uczą się produkować poprawną formę czasu przeszłego zarówno regularnych, jak i wyjątków. W ten sposób ich wydajność wykazuje funkcję w kształcie litery U dla czasowników nieregularnych (na początku poprawne, potem często błędne, potem znowu poprawne). Model był trenowany etapami na 506 angielskich czasownikach. Najpierw trenowano go na 10 czasownikach o wysokiej częstotliwości (regularnych i nieregularnych). Następnie wprowadzono czasowniki o średniej częstotliwości (głównie regularne) i trenowano je przez szereg epok. Spadek wydajności czasowników nieregularnych nastąpił wkrótce po wprowadzeniu czasowników o średniej częstotliwości - spadek, po którym nastąpiła stopniowa poprawa, która przypominała krzywą w kształcie litery U występującą w wydajności człowieka.
MOCNE STRONY I OGRANICZENIA KONEKSYJNEGO MODELOWANIA POZNAWCZEGO
Opisane powyżej modele wykazują pięć typowych cech koneksjonistycznych modeli poznania: (i) dostarczają opisu, który jest powiązany i inspirowany operacjami mózgu; (ii) mogą być używane zarówno do modelowania procesów umysłowych, jak i do symulowania rzeczywistego zaangażowanego zachowania; (iii) mogą zapewnić "dobre dopasowanie" do danych z eksperymentów psychologicznych; (iv) model i jego dopasowanie do danych są osiągane bez wyraźnego programowania i (v) często dostarczają nowych opisów danych. Omawiamy te cechy po kolei. Po pierwsze, istnieje idea, że koneksjonistyczny model poznawczy jest inspirowany i powiązany ze sposobem, w jaki działa mózg. Koneksjonizm opiera się zarówno na domniemanym działaniu układu nerwowego, jak i na rozproszonym obliczeniu. Jednostki podobne do neuronów są połączone za pomocą ważonych połączeń w sposób przypominający połączenia synaptyczne między neuronami w mózgu. Te ważone połączenia przechwytują wiedzę o systemie; można je uzyskać analitycznie lub poprzez "trening" systemu
za pomocą powtarzających się prezentacji przykładów treningu wejścia-wyjścia. Duże zainteresowanie modelami koneksjonistycznymi poznania wynikało z tego, że oferowały one nowe wyjaśnienie sposobu, w jaki wiedza była reprezentowana w mózgu. Na przykład zachowanie modelu uczenia się czasu przeszłego można opisać w kategoriach przestrzegania reguł - ale jego podstawowy mechanizm nie zawiera żadnych wyraźnych reguł. Wiedza o tworzeniu czasu przeszłego jest rozłożona na wagi w sieci. Zainteresowanie obliczeniami przypominającymi mózg było podsycane przez rosnące niezadowolenie z klasycznego podejścia przetwarzania symbolicznego do modelowania umysłu i jego relacji z mózgiem. Chociaż teorie manipulacji symbolami mogłyby wyjaśnić wiele aspektów ludzkiego poznania, istniały obawy co do tego, w jaki sposób takie symbole mogłyby być nauczone i reprezentowane w mózgu. Funkcjonalizm wyraźnie nalegał, że szczegóły dotyczące tego, w jaki sposób inteligencja i rozumowanie były faktycznie wdrażane, są nieistotne. Obawy
dotyczące manipulacji bezsensownymi, nieuzasadnionymi symbolami są zilustrowane eksperymentem myślowym Searle′a "Chinese Room" (1980). Koneksjonizm, przeciwnie, oferował podejście oparte na uczeniu się, w niewielkim stopniu wykorzystywał symbole i był związany ze sposobem, w jaki działał mózg. Można argumentować, że jednym z głównych wkładów koneksjonizmu w badanie i rozumienie umysłu było opracowanie wspólnego słownictwa między osobami zainteresowanymi poznaniem a osobami zainteresowanymi badaniem mózgu. Druga i trzecia cecha odnoszą się do sposobu, w jaki sztuczne sieci neuronowe mogą zarówno zapewnić model procesu poznawczego, jak i symulować zadanie oraz zapewnić dobre dopasowanie do danych empirycznych. W psychologii poznawczej nacisk kładziono na budowanie modeli, które mogłyby uwzględniać wyniki empiryczne uzyskane na ludziach, ale które nie uwzględniały symulacji zadań eksperymentalnych. Z kolei w sztucznej inteligencji opracowano modele, które wykonywały zadania w sposób przypominający zachowanie człowieka, ale które w niewielkim stopniu uwzględniały szczegółowe dowody psychologiczne. Jednakże, podobnie jak w dwóch opisanych tutaj modelach, modele koneksjonistyczne symulowały wykonywanie zadań przez człowieka i były w stanie dopasować dane z badań psychologicznych. Czwartą cechą jest osiągnięcie modelu i dopasowanie do danych bez wyraźnego ręcznego programowania. Można to korzystnie porównać z metodologią programowania symbolicznego sztucznej inteligencji, w której model jest programowany krok po kroku, pozostawiając miejsce na doraźne modyfikacje i prowizorki. Piątą cechą jest możliwość dostarczenia nowego wyjaśnienia danych. W swoim modelu wymowy słów Seidenberg i McClelland wykazali, że ich sztuczna sieć neuronowa dostarczyła zintegrowane (pojedynczy mechanizm) wyjaśnienie danych zarówno dla słów regularnych, jak i wyjątków, podczas gdy wcześniej stare konwencje modelowania poznawczego wymuszały wyjaśnienie w kategoriach podwójnej ścieżki. Podobnie, model czasu przeszłego został sformułowany jako wyzwanie dla opisów opartych na regułach: chociaż wydajność dzieci można opisać w kategoriach reguł, twierdzono, że model wykazał, że to samo zachowanie można wyjaśnić za pomocą podstawowego mechanizmu, który nie używa wyraźnych reguł. W czasach świetności twierdzenia koneksjonizmu o nowych wyjaśnieniach pobudzały wiele debat. Odbyło się również wiele dyskusji na temat tego, w jakim stopniu koneksjonizm może zapewnić adekwatne wyjaśnienie wyższych procesów umysłowych. Fodor i Pylyshyn (1988) przeprowadzili atak na reprezentacyjną adekwatność koneksjonizmu. Koneksjoniści odpowiedzieli, a w pracach takich jak van Gelder (1990) argumentowano, że nie tylko mogliby przedstawić opis procesów wrażliwych na strukturę leżących u podstaw języka ludzkiego, ale że koneksjonizm zrobił to w nowatorski sposób: eliminacyjne stanowisko koneksjonistyczne. Teraz, gdy kurz opadł, modele koneksjonistyczne nie wydają się tak radykalnie różne od innych podejść do modelowania, jak kiedyś przypuszczano. Uważano, że jedną z ich mocnych stron jest zdolność do modelowania procesów umysłowych, symulowania zachowań i zapewniania dobrego dopasowania do danych z eksperymentów psychologicznych bez wyraźnego zaprogramowania do tego. Jednak obecnie istnieje większa świadomość, że decyzje dotyczące czynników, takich jak architektura sieci, forma, jaką przyjmą jej reprezentacje, a nawet interpretacja jej danych wejściowych i wyjściowych, są równoznaczne z formą programowania pośredniego lub ekstensjonalnego. Kontrola treści i prezentacji próbki szkoleniowej jest ważnym aspektem programowania ekstensjonalnego. Kiedy Pinker i Prince (1988) skrytykowali model czasu przeszłego, ważnym elementem ich krytyki było to, że eksperymentatorzy nierealistycznie dostosowali środowisko do wytworzenia wymaganych wyników, a wyniki były artefaktem danych treningowych. Chociaż wyniki wskazywały na krzywą w kształcie litery U w tempie nabywania, jak to ma miejsce u dzieci, Pinker i Prince argumentowali, że ta krzywa wystąpiła tylko dlatego, że sieć była narażona na czasowniki w nierealistycznie ustrukturyzowanej kolejności. Dalsze badania w dużej mierze odpowiedziały na tę krytykę, ale nadal jest tak, że wybór danych wejściowych i kontrola sposobu, w jaki są one prezentowane sieci, wpływają na to, czego sieć się uczy. Podobny argument można wysunąć w odniesieniu do wyboru reprezentacji danych wejściowych. Podsumowując: toczyła się debata na temat nowości koneksjonizmu i jego zdolności do uwzględniania przetwarzania poznawczego wyższego poziomu. Istnieje jednak powszechne uznanie, że podejście to wniosło trwały wkład, wskazując, w jaki sposób procesy poznawcze można wdrożyć na poziomie neuronów. Mimo to podejście koneksjonistyczne do modelowania poznawczego nie jest już tak popularne, jak kiedyś. Poniżej rozważono możliwe powody:
• Trudne wyzwania: Możliwym powodem spadku popularności sztucznych sieci neuronowych jest to, że jak sugeruje Elman, "dotarliśmy do punktu, w którym łatwe cele zostały zidentyfikowane, ale trudniejsze problemy pozostają". Trudne wyzwania, którym należy sprostać, obejmują pomysł skalowania modeli w celu uwzględnienia szerszego zakresu zjawisk i budowania modeli, które mogą uwzględniać więcej niż jedno zachowanie.
• Większe zrozumienie: W wyniku naszego większego zrozumienia działania i inherentnych ograniczeń sztucznych sieci neuronowych, część ich atrakcyjności zniknęła wraz z ich tajemnicą. Stały się one częścią arsenału metod statystycznych do rozpoznawania wzorców, a większość ostatnich badań nad sztucznymi sieciami neuronowymi skupiała się bardziej na pytaniach o to, czy najlepszy poziom generalizacji został osiągnięty efektywnie, niż na modelowaniu poznania.
Istnieje również większa wiedza na temat ograniczeń sztucznych sieci neuronowych, takich jak problem "katastrofalnej interferencji" związanej z propagacją wsteczną. Propagacja wsteczna działa imponująco, gdy wszystkie dane treningowe są prezentowane sieci w każdym cyklu treningowym, ale jej wyniki są mniej imponujące, gdy takie szkolenie jest przeprowadzane sekwencyjnie, a sieć jest w pełni trenowana na jednym zestawie elementów przed trenowaniem na nowym zestawie. Nowo nauczone informacje często kolidują z wcześniej nauczonymi informacjami i je nadpisują. Na przykład McCloskey i Cohen użyli propagacji wstecznej do trenowania sieci na problemie arytmetycznym dodawania + 1 (np. 1+1, 2+1, …, 9+1). Odkryli, że gdy kontynuowali trenowanie tej samej sieci, aby dodać 2 do danej liczby, "zapomniała", jak dodać 1. Sekwencyjne trenowanie w tej formie skutkuje katastrofalną interferencją. Sharkey i Sharkey wykazali, że można uniknąć problemu, jeśli zestaw treningowy jest wystarczająco reprezentatywny dla funkcji bazowej lub istnieje wystarczająco dużo sekwencyjnych zestawów treningowych. W kontekście tego przykładu, jeśli funkcja, której należy się nauczyć, to zarówno + 1, jak i + 2, wówczas zestawy treningowe zawierające wystarczającą liczbę przykładów każdej z nich mogą doprowadzić do uczenia się sieci, aby dodać 1 lub 2 do danej liczby. Jednak odbywa się to kosztem możliwości rozróżniania elementów, które zostały nauczone, od tych, które nie zostały nauczone. Ten przykład jest związany z innym ograniczeniem sztucznych sieci neuronowych: ich niezdolnością do ekstrapolacji poza ich zestaw treningowy. Chociaż ludzie mogą łatwo pojąć ideę dodania jednego do dowolnej danej liczby, nie jest tak łatwo nauczyć sieć ekstrapolacji poza dane, na których jest trenowana. Twierdzono , że ta niezdolność sztucznych sieci neuronowych trenowanych przy użyciu propagacji wstecznej do generalizacji poza ich przestrzeń treningową stanowi poważne ograniczenie mocy sieci koneksjonistycznych: ważne, ponieważ ludzie mogą łatwo generalizować uniwersalne relacje na nieznane przypadki. Oczywiste jest, że istnieją pewne aspekty poznania, szczególnie te związane z wyższymi zdolnościami ludzkimi, takimi jak zdolności rozumowania i planowania, które są trudniejsze do uchwycenia w modelach koneksjonistycznych.
• Zmiana epoki: Obecnie obserwuje się wzrost zainteresowania bardziej szczegółowym modelowaniem funkcji mózgu i towarzyszące temu niezadowolenie z prostoty modeli poznawczych, które często składały się z "niewielkiej liczby neuronów połączonych w trzech rzędach" (Hawkins, 2004). Podobnie, istnieje większa niecierpliwość w związku z naciskiem w koneksjonizmie na biologicznie nieprawdopodobny algorytm uczenia się metodą propagacji wstecznej. Jednocześnie wzrasta świadomość roli, jaką ciało odgrywa w poznaniu, oraz relacji między ciałem, mózgiem i środowiskiem (np. Clark, 1999). Tradycyjne modele koneksjonistyczne nie pasują łatwo do nowego nacisku na poznanie ucieleśnione
TRENDY NA PRZYSZŁOŚĆ
Jednym z oczekiwanych trendów na przyszłość będzie skupienie się na trudnych wyzwaniach. Prawdopodobne jest, że badania zbadają, w jaki sposób modele izolowanych procesów, takich jak nauka czasu przeszłego czasowników, mogą pasować do bardziej ogólnych opisów uczenia się języka i poznania. Istnieją dalsze pytania dotyczące rozwojowego pochodzenia wielu aspektów poznania oraz pochodzenia i postępu zaburzeń rozwojowych. Koneksjonistyczne modelowanie poznawcze prawdopodobnie zmieni się w odpowiedzi na nowy zeitgest. Prawdopodobnym scenariuszem jest to, że sztuczne sieci neuronowe będą nadal wykorzystywane do modelowania poznawczego, ale nie wyłącznie, jak wcześniej. Nadal będą stanowić część hybrydowych podejść do poznania, w połączeniu z metodami symbolicznymi. Podobnie, sztuczne sieci neuronowe mogą być używane w połączeniu z algorytmami ewolucyjnymi, aby tworzyć podstawę adaptacyjnych odpowiedzi na środowisko. Zamiast trenować sztuczne sieci neuronowe, można je dostosowywać za pomocą metod ewolucyjnych i wykorzystywać jako podstawę dla kontrolerów robotycznych (np. Nolfi i Floreano, 2000). Takie zmiany zapewnią przyszłość modelowaniu koneksjonistycznemu i pobudzą nowy zestaw pytań dotyczących pojawiania się poznania w odpowiedzi na interakcję organizmu ze środowiskiem.
WNIOSEK
W tym artykule opisaliśmy dwa przełomowe modele poznawcze koneksjonistyczne i rozważyliśmy ich charakterystyczne cechy. Nakreśliliśmy debaty na temat nowości i wystarczalności koneksjonizmu do modelowania poznania i argumentowaliśmy, że pod pewnymi względami podejście to dzieli cechy z podejściami modelowania, które je poprzedzały. Zidentyfikowano powody stopniowego zaniku zainteresowania koneksjonizmem i omówiono możliwe przyszłości. Koneksjonizm wywarł silny wpływ na modelowanie poznawcze i chociaż jego związek z mózgiem nie jest już postrzegany jako silny, dostarczył wskazówek, w jaki sposób procesy poznawcze można uwzględnić w mózgu. Twierdzi się tutaj, że chociaż podejście to nie jest już wszechobecne, nadal będzie stanowić ważny składnik przyszłych modeli poznawczych, ponieważ uwzględniają one interakcje między myślą, mózgiem i środowiskiem.
Sztuczne sieci neuronowo-glejowe
WSTĘP
Ponad 50 lat temu stworzono systemy koneksjonistyczne (CS) w celu przetwarzania informacji w komputerach, takich jak mózg ludzki. Od tego czasu systemy te znacznie się rozwinęły i obecnie pozwalają nam rozwiązywać złożone problemy w wielu dyscyplinach (klasyfikacja, klasteryzacja, regresja itp.). Jednak ten postęp nie jest wystarczający. Istnieje nadal wiele ograniczeń, gdy te systemy są używane. Większość ulepszeń uzyskano na dwa różne sposoby. Wielu badaczy preferowało konstrukcję sztucznych sieci neuronowych (ANN) opartych na modelach matematycznych z różnymi równaniami, które kierują ich funkcjonowaniem. W przeciwnym razie inni badacze udawali, że jak najbardziej możliwe jest stworzenie podobnych systemów do mózgu ludzkiego. Systemy zawarte w tym artykule powstały w wyniku drugiego sposobu badania. Wprowadzono CS, które udają, że imitują sieci neuronów glejowych mózgu. Systemy te nazywane są sztucznymi sieciami neuronów glejowych (ANGN). Te CS nie są zbudowane tylko z neuronów, ale również z elementów, które imitują neurony glejowe, zwanych astrocytami (Araque, 1999). Te systemy, które mają hybrydowe szkolenie, wykazały skuteczność w rozwiązywaniu problemów klasyfikacji za pomocą całkowicie połączonych sieci wielowarstwowych typu feed-forward, bez propagacji wstecznej i połączeń bocznych.
TŁO
ANNS lub CSS naśladują biologiczne sieci neuronowe, ponieważ nie wymagają programowania zadań, ale uogólniają i uczą się z doświadczenia. Obecne ANN są składane przez zestaw bardzo prostych elementów przetwarzania (PE), które naśladują neurony biologiczne i pewną liczbę połączeń między nimi. Do tej pory naukowcy, którzy udają, że naśladują mózg, starali się reprezentować w Anns, jakie znaczenie mają neurony w układzie nerwowym (NS). Jednak w ciągu ostatnich dziesięcioleci badanie wzrosły . Co ciekawe w polu neuronauki i coraz bardziej złożone obwody nerwowe, a także w systemie glejowym (GS), są uważnie obserwowane. Znaczenie funkcji GS prowadzi badaczy do myślenia, że ich udział w przetwarzaniu informacji w NS jest znacznie bardziej istotny niż wcześniej zakładano. W takim przypadku przydatne może być zintegrowanie z sztucznymi modelami inne elementy, które nie są neuronami. Od późnych lat 80. zastosowanie innowacyjnych i starannie rozwiniętych technik komórkowych i fizjologicznych (takich jak plastr-clamp, fluorescencyjne obrazy jonowe, mikroskopia konfokalna i biologia molekularna) do badań glejowych wbierało klasycznej idei, że astrocyty jedynie zapewniają strukturalne i Wsparcie troficzne dla neuronów i sugeruje, że te pierwiastki odgrywają bardziej aktywną rolę w fizjologii ośrodkowego układu nerwowego. Nowe odkrycia ujawniają teraz, że glej jest ściśle powiązany z aktywną kontrolą aktywności nerwowej i biorą udział w regulacji neurotransmisji synaptycznej . Obfite dowody sugerują istnienie dwukierunkowej komunikacji między astrocytami i neuronami oraz ważną aktywną rolę astrocytów w fizjologii NS . Dowody te doprowadziły do propozycji nowej koncepcji fizjologii synaptycznej, trójstronnej synapsy, która składa się z trzech elementów funkcjonalnych: elementów presynaptycznych i postsynaptycznych oraz otaczających astrocytów. Komunikacja między tymi trzema elementami ma bardzo złożone cechy, które wydają się bardziej niezawodnie odzwierciedlać złożoność przetwarzania informacji między elementami NS. Tak więc nie ma wątpliwości co do istnienia komunikacji między astrocytami i neuronami. Aby zrozumieć motywy tej odwrotnej sygnalizacji, musimy znać różnice i podobieństwa między ich właściwościami. Zaledwie dekadę temu absurdalne byłoby sugerowanie, że te dwa typy komórek mają bardzo podobne funkcje; Teraz zdajemy sobie sprawę, że podobieństwa uderzają z perspektywy sygnalizacji chemicznej. Oba typy komórek otrzymują wejścia chemiczne, które mają wpływ na receptory jonotropowe i metabotropowe. Po tej integracji oba typy komórek wysyłają sygnały do swoich sąsiadów poprzez uwalnianie transmitoracji chemicznych. Zarówno sygnalizacja neuronu do neuronu, jak i sygnalizacja neuron-naistrocyt pokazują właściwości plastyczne, które zależą od aktywności. Główną różnicą między astrocytami i neuronami jest to, że wiele neuronów rozszerza swoje aksony na duże odległości i prowadzi potencjały czynnościowe o krótkim czasie trwania z dużą prędkością, podczas gdy astrocyty nie wykazują żadnej pobudliwości elektrycznej, ale prowadzą skoki wapnia o długim czasie (dziesiątki sekund) ponad przesadnie) krótkie odległości i przy niskiej prędkości. Szybka sygnalizacja i funkcje wejściowe/wyjściowe w centralnych NS, które wymagają prędkości, wydają się należeć do domeny neuronowej. Ale co dzieje się z wolniejszymi zdarzeniami, takimi jak indukcja wspomnień i inne procesy abstrakcyjne, takie jak procesy myślowe? Czy sygnalizacja między astrocytami przyczynia się do ich kontroli? Dopóki nie ma odpowiedzi na te pytania, badania muszą kontynuować; Obecne prace oferują nowe sposoby rozwoju poprzez wykorzystanie technik sztucznej inteligencji (AI). Dlatego nie tylko udaje się, że poprawia CSS zawierające pierwiastki naśladujące astrocyty, ale ma również na celu skorzystanie z neuronauki w badaniu obwodów mózgu od innego punktu widzenia, AI. Najnowsze prace w tym obszarze są prezentowane przez Porto i inni.
GŁÓWNY TEMAT ARTYKUŁU
Wszystkie możliwości projektowe, zarówno w odniesieniu do architektury, jak i procesu szkolenia sieci neuronowej, są zasadniczo ukierunkowane na minimalizację poziomu błędu lub skrócenie czasu uczenia się systemu. W związku z tym w procesie optymalizacji mechanizmu, w przypadku sieci neuronowej, musimy znaleźć rozwiązanie dla wielu parametrów elementów i połączeń między nimi. Biorąc pod uwagę możliwe przyszłe ulepszenia, które optymalizują sieć neuronową pod kątem minimalnego błędu i minimalnego czasu szkolenia, nasze modele będą obwodami mózgowymi, w których udział elementów GS jest kluczowy dla przetwarzania informacji. Aby zaprojektować integrację tych elementów w sieci neuronowej i opracować metodę uczenia się dla powstałej sieci neuronowej, która pozwoli nam sprawdzić, czy w tych systemach występuje poprawa, przeanalizowaliśmy główne istniejące metody szkoleniowe, które zostaną wykorzystane do opracowania. Przeanalizowaliśmy metody szkolenia bez nadzoru i szkolenia z nadzorem oraz inne metody, które wykorzystują lub łączą niektóre z ich cech i uzupełniają analizę: szkolenie przez wzmocnienie, szkolenie hybrydowe i szkolenie ewolucyjne. Obserwowane ograniczenia. Kilka eksperymentów z ANN wykazało istnienie konfliktów między funkcjonowaniem CS a biologicznymi sieciami neuronowymi, ze względu na stosowanie metod, które nie odzwierciedlały rzeczywistości. Na przykład w przypadku wielowarstwowego perceptronu, który jest prostym CS, połączenia synaptyczne między PE mają wagi, które mogą być pobudzające lub hamujące, podczas gdy w naturalnym NS to neurony wydają się reprezentować te funkcje, a nie połączenia; ostatnie badania wskazują, że komórki GS, a konkretniej astrocyty, również odgrywają ważną rolę. Inne ograniczenie dotyczy algorytmu uczenia się znanego jako "propagacja wsteczna", co oznacza, że zmiana wartości połączeń wymaga wstecznej transmisji sygnału błędu w ANN. Tradycyjnie zakładano, że takie zachowanie jest niemożliwe w naturalnym neuronie, który zgodnie z teorią "polaryzacji dynamicznej" Ramóna y Cajala (1911) nie jest w stanie skutecznie przekazywać informacji odwrotnie przez akson aż do osiągnięcia somy komórkowej; nowe badania wykazały jednak, że neurony mogą przesyłać informacje do neuronów presynaptycznych w określonych warunkach, albo za pomocą istniejących mechanizmów w dendrytach, albo za pośrednictwem różnych interwencji komórek glejowych, takich jak astrocyty. Jeśli uczenie się jest nadzorowane, oznacza to istnienie "instruktora", co w kontekście mózgu oznacza zbiór neuronów, które zachowują się inaczej niż pozostałe, aby kierować procesem. Obecnie istnienie tego typu neuronów jest biologicznie niewytłumaczalne, ale GS wydaje się być silnie implikowane w tej orientacji i może być elementem, który konfiguruje instruktora, który do tej pory nie był brany pod uwagę. W tym kontekście niniejsze badanie analizuje, w jakim stopniu najnowsze odkrycia w dziedzinie neuronauki (Araque i in., 2001; Perea i Araque, 2002) przyczyniają się do powstania tych sieci: odkryć wynikających z aktywności mózgu w obszarach uważanych za zaangażowane w uczenie się i przetwarzanie informacji
Sztuczne sieci neuronów glejowych
Wielu badaczy wykorzystało obecny potencjał komputerów i wydajność modeli obliczeniowych do opracowania "biologicznych" modeli obliczeniowych i lepszego zrozumienia struktury i zachowania neuronów piramidalnych, o których uważa się, że biorą udział w procesach uczenia się i pamięci , oraz astrocytów . Modele te pozwoliły lepiej zrozumieć przyczyny i czynniki zaangażowane w specyficzne funkcjonowanie obwodów biologicznych. Niniejsza praca wykorzysta te nowe spostrzeżenia do postępu w dziedzinie nauk komputerowych, a konkretniej w dziedzinie sztucznej inteligencji. Przedstawiamy ANGN, które obejmują zarówno sztuczne neurony, jak i elementy sterujące przetwarzaniem, które reprezentują astrocyty, a których funkcjonowanie jest zgodne z krokami, które zostały pomyślnie zastosowane w konstrukcji i użytkowaniu CS: projektowanie, szkolenie, testowanie i wykonywanie. Ponadto, ponieważ badania obliczeniowe uczenia się za pomocą ANN zaczynają zmierzać w kierunku ewolucyjnych metod obliczeniowych, połączymy optymalizację w modyfikacji wag (zgodnie z wynikami modeli biologicznych) z wykorzystaniem algorytmów genetycznych (GA), aby znaleźć najlepsze rozwiązanie dla danego problemu. Ta technika ewolucyjna okazała się bardzo skuteczna w fazie szkolenia CS, ponieważ pomaga dostosować CS do optymalnego rozwiązania zgodnie z danymi wejściowymi, które trafiają do systemu i danymi wyjściowymi, które system musi wytworzyć. To zjawisko adaptacji ma miejsce w mózgu dzięki plastyczności jego elementów i może być częściowo kontrolowane przez GS; z tego powodu uważamy GA za część "sztucznego gleju". Rezultatem tej kombinacji jest hybrydowa metoda uczenia się (Porto, 2004). Projektowanie ANGN jest zorientowane na problemy klasyfikacyjne, które są rozwiązywane za pomocą prostych sieci, tj. sieci wielowarstwowych, chociaż przyszłe badania mogą doprowadzić do zaprojektowania modeli w bardziej złożonych sieciach. Wydaje się logicznym podejściem rozpoczęcie projektowania tych nowych modeli od prostych ANN i zorientowanie najnowszych odkryć dotyczących astrocytów i neuronów piramidalnych w przetwarzaniu informacji na ich wykorzystanie w sieciach klasyfikacyjnych, ponieważ kontrola wzmocnienia lub osłabienia połączeń w mózgu jest związana z adaptacją lub plastycznością połączeń, co prowadzi do generowania sposobów aktywacji. Proces ten może zatem poprawić klasyfikację wzorców i ich rozpoznawanie przez ANGN. Szczegółowy opis funkcjonowania ANGN i wyników z tymi systemami można znaleźć w Porto i inni
PRZYSZŁE TRENDY
Ciągle analizujemy inne możliwości modyfikacji synaptycznych w oparciu o zachowanie mózgu, aby zastosować je w nowych CS, które mogą rozwiązywać proste problemy przy użyciu prostych architektur. Ponadto, biorąc pod uwagę, że udowodniono, że gleje działają na złożone obwody mózgowe i że im bardziej mózg danej osoby się rozwinął, tym więcej gleju ma ona w swoim układzie nerwowym (zgodnie z tym, co Cajal powiedział sto lat temu (Ramón y Cajal, 1911), stosujemy zaobserwowane zachowanie mózgu do bardziej złożonych architektur sieciowych. Szczególnie po sprawdzeniu, że bardziej złożona architektura sieciowa osiągnęła lepsze wyniki w przedstawionym tutaj problemie. Z tego samego powodu zamierzamy przeanalizować, w jaki sposób nowe CS rozwiązują złożone problemy, na przykład te związane z przetwarzaniem czasu, w których całkowicie lub częściowo rekurencyjne sieci odgrywałyby rolę. Sieci te mogłyby łączyć swoje funkcjonowanie z tym nowym zachowaniem.
WNIOSEK
W tym artykule przedstawiono CS złożone ze sztucznych neuronów i sztucznych komórek glejowych. Projekt sztucznych modeli nie miał na celu uzyskania idealnej kopii naturalnego modelu, ale szeregu zachowań, których ostateczne funkcjonowanie jest do niego maksymalnie zbliżone. Niemniej jednak bliskie podobieństwo między nimi jest niezbędne do poprawy wyników i może skutkować bardziej "inteligentnymi" zachowaniami. Modyfikacje synaptyczne wprowadzone w CS i oparte na modelowanych procesach mózgowych wzmacniają trening wielowarstwowych architektur. Musimy pamiętać, że innowacja istniejących modeli ANN w kierunku rozwoju nowych architektur jest uwarunkowana potrzebą zintegrowania nowych parametrów z algorytmami uczenia się, aby mogły one dostosowywać swoje wartości. Nowe parametry, które zapewniają modelom elementów procesu ANN nowe funkcjonalności, są trudniejsze do zdobycia niż optymalizacje najczęściej używanych algorytmów, które zwiększają obliczenia i zasadniczo działają po stronie obliczeniowej algorytmu. ANGN integrują nowe elementy i dzięki metodzie hybrydowej podejście to nie komplikuje procesu treningu. Badania z tymi ANGN przynoszą korzyści AI, ponieważ mogą poprawić możliwości przetwarzania informacji, co pozwoliłoby nam poradzić sobie z szerszym zakresem problemów. Co więcej, pośrednio przyniosło to korzyści Neuroscience, ponieważ eksperymenty z modelami obliczeniowymi, które symulują obwody mózgowe, torują drogę trudnym eksperymentom przeprowadzanym w laboratoriach, a także dostarczają nowych pomysłów na badania
Separacja ślepych źródeł za pomocą ICA
WSTĘP
Niniejsza praca przedstawia krótkie wprowadzenie do separacji ślepych źródeł przy użyciu technik analizy niezależnych składowych (ICA). Głównym celem separacji ślepych źródeł (BSS) jest uzyskanie z obserwacji złożonych z różnych sygnałów mieszanych tych różnych sygnałów, które je tworzą. Cel ten można osiągnąć za pomocą dwóch różnych technik: przestrzennej i statystycznej. Pierwsza z nich opiera się na układzie mikrofonów i zależy od ich położenia i separacji. Wykorzystuje również kierunki przybycia (DOA) z różnych sygnałów audio. Z drugiej strony separacja statystyczna zakłada, że sygnały są statystycznie niezależne, że są mieszane w sposób liniowy i że możliwe jest uzyskanie mieszanek za pomocą odpowiednich czujników . Ostatnia technika jest tą, która zostanie zbadana w tej pracy. Jest to najnowsza technika i jest w ciągłym rozwoju. Jest ona wykorzystywana w różnych dziedzinach, takich jak przetwarzanie języka naturalnego, bioinformatyka, przetwarzanie obrazu oraz w różnych zastosowaniach w życiu codziennym, takich jak komunikacja mobilna. Konkretnie, techniką, która będzie wykorzystywana jest niezależna analiza składowych (ICA). ICA pochodzi ze starej techniki zwanej PCA (analiza głównych składowych). PCA jest wykorzystywana w szerokim zakresie zakresów, takich jak rozpoznawanie twarzy lub kompresja obrazu, będąc bardzo powszechną techniką znajdowania wzorców w danych o wysokim wymiarze. Problem BSS może być dwojaki; pierwszy z nich to taki, gdy mieszaniny są liniowe. Oznacza to, że dane są mieszane bez echa lub pogłosu, podczas gdy drugi, ze względu na te warunki, mieszanki są splotowe i nie są całkowicie niezależne ze względu na propagację sygnału przez dynamiczne środowiska. Jest to "problem koktajlowy". W zależności od mieszanek, istnieje kilka metod rozwiązania problemu BSS. Pierwszy przypadek można postrzegać jako uproszczenie drugiego. Separacja ślepego źródła oparta na ICA jest również podzielona na trzy grupy; pierwsza to metody, które działają w dziedzinie czasu, druga to te, które działają w dziedzinie częstotliwości, a ostatnia grupa to metody, które łączą metody dziedziny częstotliwości i czasu. W tej pracy zaproponowano rewizję stanu techniki tych metod.
PODSUMOWANIE
Problem polega na tym, że w systemie miesza się kilka źródeł, te mieszanki są rejestrowane, a następnie muszą zostać rozdzielone, aby uzyskać oszacowania oryginalnych źródeł. Jak wspomniano powyżej, problemy BSS mogą być dwóch różnych typów; pierwszy, gdy mieszanki są liniowe, patrz równanie 3, i drugi, gdy mieszanki są splotowe, patrz równanie 5. W pierwszym przypadku każdy sygnał źródłowy jest mnożony przez stałą, która zależy od środowiska, a następnie są one dodawane. Mieszaniny splotowe nie są całkowicie niezależne ze względu na propagację sygnału przez dynamiczne środowiska. To sprawia, że sygnały nie są po prostu dodawane. Pierwszy przypadek jest idealny, a drugi jest najczęstszym przypadkiem, ponieważ w rzeczywistych nagraniach pokojowych systemy miksujące są tego typu. Poniższy rysunek przedstawia układ mieszania w przypadku dwóch źródeł dwóch mieszanek:

Gdzie X1 i X2 są niezależnymi sygnałami, Y1 i Y2 są mieszaniem różnych Xj, a  jest układem mieszania, który można przedstawić w ogólnej postaci jako ?

hij są filtrami FIR, każdy z nich reprezentuje funkcję wielodrożnego przenoszenia akustycznego ze źródła i do czujnika j. i i j reprezentują liczbę źródeł i czujników. Teraz należy zapamiętać pierwszy warunek, który umożliwia ślepą separację źródeł: "Liczba czujników musi być większa lub równa liczbie źródeł". Biorąc to pod uwagę, problem dla dwóch czujników, w ogólnej formie, można przedstawić jako:

Generalnie, istnieje n sygnałów źródłowych statystycznie niezależnych X(t) = [X1(t), …,Xn(t)] , i m obserwowanych mieszanin, które są liniowymi i natychmiastowymi kombinacjami poprzednich sygnałów Y(t) = [Y1(t), … ,Yn(t)] . Zaczynając od przypadku liniowego, najprostszego przypadku, mieszaniny są następujące:

Teraz musimy odzyskać X(t) z Y(t). Należy oszacować macierz odwrotną H, w której zawarte są hij. Gdy już mamy tę macierz:

gdzie  zawiera oszacowania oryginalnych sygnałów źródłowych, a
 jest odwrotną macierzą mieszania. Teraz, gdy zdefiniowaliśmy najprostszy przypadek, czas wyjaśnić przypadek ogólny, który obejmuje mieszanki splotowe. Cały proces, który obejmuje proces mieszania i rozdzielania, i który został opisany wcześniej dla mieszanek liniowych, jest zdefiniowany jak na Rysunku

Proces będzie następujący; najpierw zestaw sygnałów źródłowych (X) przechodzi przez nieznany układ . Wyjście (Y) zawiera wszystkie mieszanki. Y jest wyrównywane za pomocą odwrotnego oszacowanego układu , który musi dać oszacowanie oryginalnych sygnałów źródłowych ( ). Mając dostęp do N czujników z liczbą źródeł mniejszą lub równą N, wszystkie z nieznanymi kanałami bezpośrednimi i krzyżowymi, celem jest odzyskanie wszystkich nieznanych źródeł. Tutaj pojawia się drugi warunek uzyskania separacji źródeł: "W ślepej separacji źródeł przy użyciu ICA zakłada się, że znamy tylko funkcje gęstości prawdopodobieństwa źródeł niegaussowskich i niezależnych". Musimy więc uzyskać i musi być tak:

Tutaj, jak wspomniano powyżej, to oszacowania oryginalnych sygnałów źródłowych, Y to obserwacje, a to odwrotny filtr mieszający.
ŚLEPA SEPARACJA ŹRÓDEŁ ICA
W tym artykule przedstawiono różne metody rozwiązywania ślepej separacji źródeł, a dokładniej te, które opierają się na analizie niezależnych składowych (ICA). Najpierw zostaną opisane metody dla mieszanin liniowych, a następnie podzielimy metody dla mieszanin splotowych na trzy grupy w zależności od dziedziny; dziedzina częstotliwości, dziedzina czasu lub obie. Ślepa separacja źródeł dla mieszanin liniowych Ślepa separacja źródeł dla mieszanin liniowych jest szczególnym przypadkiem metody splotowej. Tak więc metody zaprojektowane dla mieszanin splotowych muszą rozwiązywać problem mieszanin liniowych w teorii. W tym przypadku postanowiliśmy opisać niektóre metody liniowe osobno, ponieważ istnieją pewne ważne metody specjalizujące się w tym przypadku. Istnieją różne metody, takie jak Infomax, która opiera się na maksymalizacji informacji (Bell & Sejnowski, 1995), metoda oparta na minimalizacji informacji wzajemnej lub metody wykorzystujące tensory. Metody, które zostaną opisane w tym artykule to FastICA i JADE, zostały wybrane, ponieważ są dwiema z najbardziej znanych metod dla liniowego przypadku BSS i ponieważ są właściwym pierwszym krokiem do BSS. Pierwszą z nich, i być może najbardziej znaną, jest FastICA . Algorytm FastICA jest obliczeniowo wysoce wydajną metodą wykonywania oszacowania ICA. Wykorzystuje schemat iteracji stałoprzecinkowej, który w niezależnych eksperymentach okazał się 10-100 razy szybszy niż konwencjonalne metody gradientu zstępującego dla ICA. Inną zaletą algorytmu FastICA jest to, że można go również użyć do wykonania poszukiwania projekcji, zapewniając w ten sposób uniwersalną metodę analizy danych, która może być używana zarówno w sposób eksploracyjny, jak i do oszacowania niezależnych komponentów (lub źródeł). Ten algorytm jest dostępny w zestawie narzędzi, który jest bardzo łatwy w użyciu (Helsinki University of Technology, 2006). Inną metodą, która jest bardzo powszechna w separacji ślepego źródła mieszanin liniowych, jest JADE. JADE (Join approx diagonalization of eigenmatrices) odnosi się do jednej zasady rozwiązywania problemu równych wartości własnych tensora kumulacyjnego. W tym algorytmie tensor EVD jest uważany bardziej za krok wstępnego przetwarzania. Metodę ściśle powiązaną z JADE podaje rozkład wartości własnych macierzy korelacji ważonej. Ze względów historycznych podstawowa metoda jest po prostu nazywana ślepą identyfikacją czwartego rzędu (FOBI).
Separacja ślepego źródła dla mieszanin splotowych
Po opisaniu problemu liniowego nadszedł czas na wyjaśnienie, jak rozwiązać problem z mieszankami splotowymi. Ten przypadek jest bardziej złożony niż liniowy, jak przedstawiono w Tło. Gdy mieszanki są splotowe, problem nazywa się również ślepą dekonwolucją. Aby rozwiązać ten problem, zaprojektowano kilka metod. Można je podzielić na trzy grupy w zależności od dziedziny: dziedzinę czasu, dziedzinę częstotliwości lub obie. Gdy algorytm działa w dziedzinie częstotliwości, mieszanki splotowe można uprościć do jednoczesnych za pomocą transformacji częstotliwości. Ułatwia to zbieżność filtra separacyjnego. Tak więc algorytmy te mogą zwiększyć prędkość zbieżności i zmniejszyć obciążenie obliczeniowe. Ma to jednak swoją cenę; aby utrzymać wydajność obliczeniową, algorytmy te muszą zwiększać długość ramki, gdy ramka okna się zwiększa. Dane są redukowane i mogą powodować niewystarczalność danych uczących się. W związku z tym wydajność algorytmu jest obniżona. Niektóre przykłady tych algorytmów to: ślepa separacja źródeł w domenie falki, metoda rekurencyjna , dekorrelacja opóźnienia czasowego , algorytm ICA i kształtowanie wiązki lub zestaw narzędzi macierzy FIR 5.0. Jeśli algorytm działa w domenie czasu, możemy pracować z sygnałami audio o szerokim paśmie, gdzie zachowane jest założenie niezależności. Wadami jest to, że generują duże obciążenie obliczeniowe, gdy pracują z ogromnymi macierzami separacji, a zbieżność jest ogólnie powolna, gdy sygnały są głosami. Niektóre algorytmy działające w dziedzinie czasu to SIMO - ICA , banki filtrów lub algorytmy szybkich punktów stałych w dziedzinie czasu dla splotowej ICA. Możemy jednak również połączyć dwie poprzednie metody, aby zrekompensować zalety i wady każdej z nich, na przykład w wieloetapowej ICA ; FDICA (ICA w dziedzinie częstotliwości) i TDICA (ICA w dziedzinie czasu) są łączone w celu osiągnięcia możliwie najlepszej wydajności. Ten algorytm ma stabilne zachowanie, ale obciążenie obliczeniowe jest wysokie.
TRENDY PRZYSZŁOŚCI
Separacja źródeł ślepych ma szeroki zakres, który jest w ciągłym rozwoju, a wielu autorów pracuje nad projektowaniem lub modyfikacją różnych metod. W tej pracy przedstawiono różne algorytmy rozwiązywania problemu separacji ślepych źródeł. Przyszłymi trendami będą projekty metod on-line, które pozwolą na implementację tych algorytmów w rzeczywistych zastosowaniach, takich jak rozpoznawanie głosu lub urządzenia do obsługi bez użycia rąk. Algorytmy można również ulepszyć w celu osiągnięcia bardziej wydajnej i dokładnej separacji mieszanin, liniowej lub splotowej. Pomoże to w różnych systemach jako pierwszy krok do identyfikacji mówców, na przykład na konferencjach, wideokonferencjach lub podobnych.
WNIOSEK
W tym artykule przedstawiono różne sposoby rozwiązywania problemu separacji ślepych źródeł. Ilustruje on również, że problem może mieć dwie formy w zależności od mieszanin. Jeśli mamy mieszaniny liniowe, system będzie zachowywał się inaczej niż w przypadku mieszanek splotowych. Jak opisano powyżej, metody można również podzielić na dwa typy: algorytmy dziedziny częstotliwości i algorytmy dziedziny czasu. Pierwszy typ ma szybszą zbieżność niż typ dziedziny czasu, ale może działać nieprawidłowo, jeśli dane są niewystarczające. Metody dziedziny czasu mają bardziej stabilne zachowanie niż algorytmy częstotliwości, ale większe obciążenie obliczeniowe. Aby zrównoważyć zalety i wady każdego typu metody, zaproponowano algorytmy wieloetapowe.
Powrót